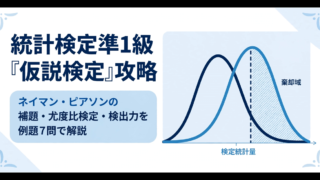
統計検定準1級「仮説検定」攻略 ― ネイマン・ピアソンの補題・尤度比検定・検出力の典型出題対策 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
統計検定準1級の対策として、出題範囲のうち「統計的仮説検定」の理論に絞り、例題を筆者(生物統計家)が選定しました。数値はすべてRで検算して掲載しています。この記事でわかること
💡 この記事でわかること
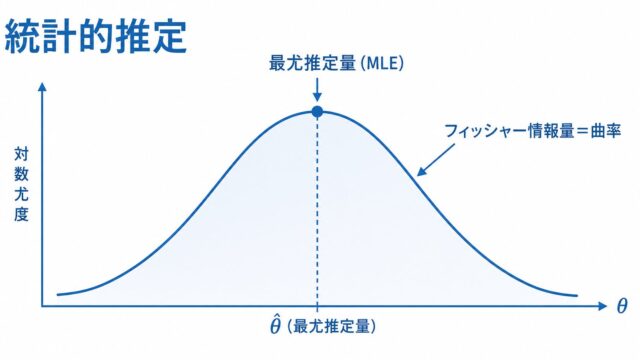
本記事は統計検定準1級の攻略シリーズの1本で、統計検定準1級「統計的推定」攻略では最尤法と十分統計量を扱いました。本記事は検定の理論的な土台――過誤の確率、最強力検定、尤度比検定、検出力設計――を例題7問で整理します。各例題にはRのコードと出力を併記し、答え合わせまで完結します。- 棄却域から有意水準・第二種の過誤・検出力を計算し、離散分布では実際の有意水準が名目とずれる理由
- ネイマン・ピアソンの補題で最強力検定を導く手順と、ランダム化・一様最強力検定の考え方
- 尤度比検定の作り方と、t検定との一致、漸近カイ二乗分布(Wilksの定理)の使い方
- 検出力と効果量からサンプルサイズを逆算する設計の計算
はじめに ― 準1級における「仮説検定」の位置づけ
統計検定準1級は、統計学の実務的な運用能力を測る試験として位置づけられています。試験方式はCBT(コンピュータを使った受験)で、試験時間は90分、出題数はおおむね20〜30問、100点満点で60点以上が合格ラインとされています(最新の正確な情報は公式サイトでご確認ください)。試験中は四則演算・百分率・平方根ができる普通電卓のみが使えます(関数電卓は不可)。 2級の検定が「t検定やカイ二乗検定の手順を実行できること」を問うのに対し、準1級の仮説検定は「その手順がなぜ正当化されるのか」を問います。棄却域の決め方の背後にあるネイマン・ピアソンの補題、多くの検定を統一的に生み出す尤度比検定、そして検出力にもとづくサンプルサイズ設計が柱です。臨床試験の統計家にとっては、有意水準と検出力の設計は日常業務そのものでもあります。 本記事では、仮説検定の理論の典型出題を例題7問に絞り、「問題 → 手計算の途中式 → 検算 → Rでの答え合わせ → 解釈」の順に進めます。なお、個別の検定手法の手順は2級「仮説検定・区間推定」攻略で、順位にもとづく検定は準1級「ノンパラメトリック法」攻略で扱ったため、本記事の対象外とします。 検定の理論でつまずきやすいのは、「帰無仮説のもとで」「対立仮説のもとで」という条件の切り替えです。本記事の例題は、どの確率も「何のもとでの確率か」を明示しながら計算します。読み方は、まず答えを見ずに電卓で手計算し、詰まった箇所だけ途中式と照らし合わせるのがおすすめです。Rのコードは答え合わせ専用です。検定の枠組み ― 過誤・有意水準・検出力
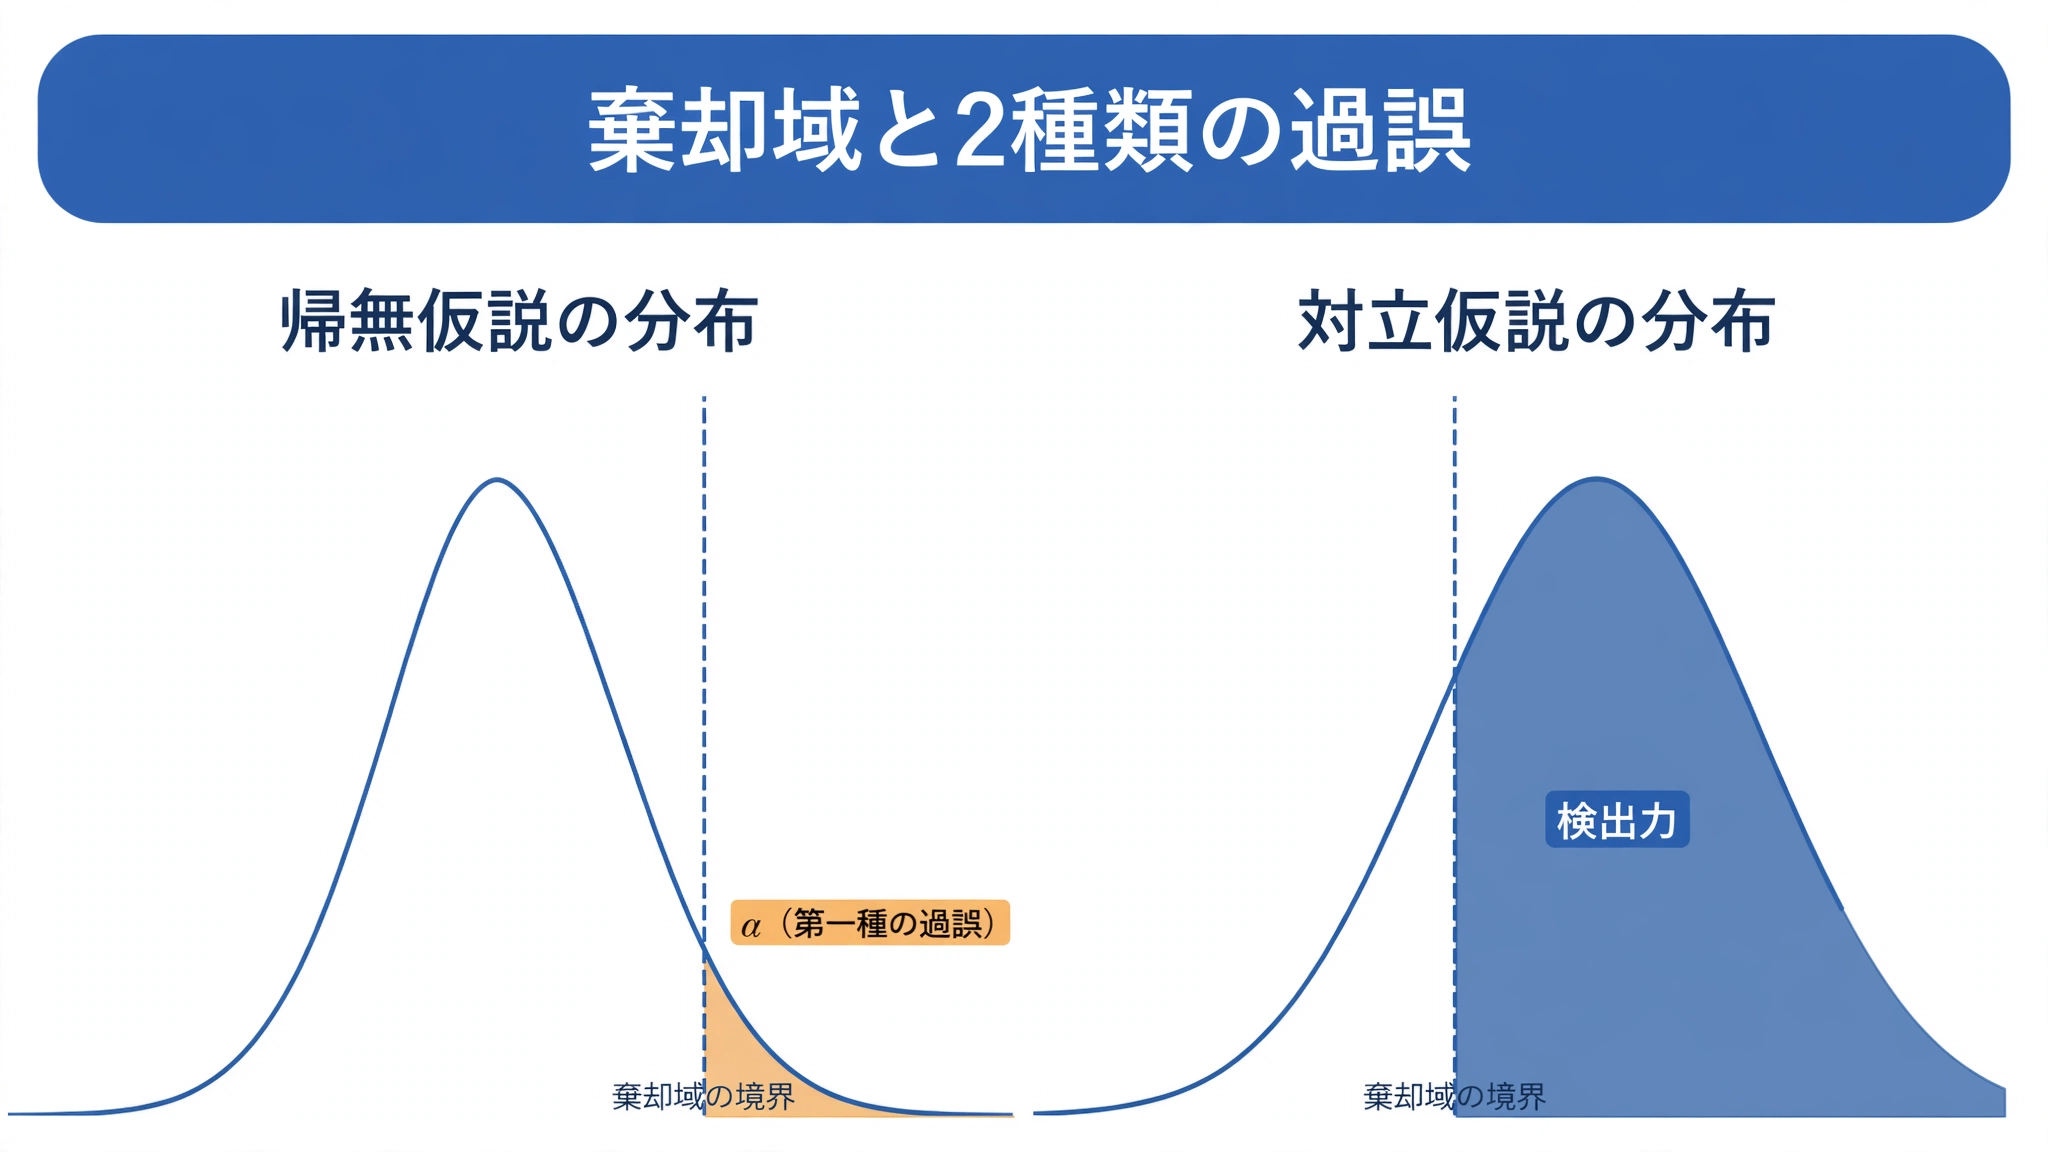
検定では、否定したい主張を帰無仮説 \(H_0\)、示したい主張を対立仮説 \(H_1\) とし、標本から計算した検定統計量が \(H_0\) のもとでどれだけ珍しいかで判定します。判定の誤りには2種類あります。| 真の状態 | \(H_0\) を棄却する | \(H_0\) を棄却しない |
|---|---|---|
| \(H_0\) が真 | 第一種の過誤(確率 \(\alpha\)) | 正しい判断 |
| \(H_1\) が真 | 正しい判断(確率 \(1-\beta\)) | 第二種の過誤(確率 \(\beta\)) |
例題1 正規分布の棄却域から検出力を求める
問題 母標準偏差 \(\sigma=10\) が既知の正規母集団から \(n=25\) の標本を取ります。\(H_0:\mu=100\) 対 \(H_1:\mu>100\) を有意水準5%(片側)で検定するとき、(1) 標本平均の棄却域と、(2) 真の平均が \(\mu=106\) のときの検出力と第二種の過誤の確率 \(\beta\) を求めてください。 解答 標本平均の標準誤差は \(10/\sqrt{25}=2\) です。(1) 片側5%点 \(z_{0.05}=1.645\) を使うと、棄却域は次のようになります。\[\bar{x}>100+1.645\times2=103.29\]
(2) 検出力は、\(\mu=106\) のもとで標本平均が棄却域に入る確率です。標準化すると \(\frac{103.29-106}{2}=-1.355\) となるので、\[P(\bar{X}>103.29\mid\mu=106)=P(Z>-1.355)=\Phi(1.355)=0.9123\]
よって検出力は \(0.9123\)、\(\beta=1-0.9123=0.0877\) です。 検算 検出力 \(0.9123\) と \(\beta\) \(0.0877\) の合計が1になることで確認できます。 Rで答え合わせをします。# 例題1:正規分布(分散既知)の検出力
crit <- 100 + qnorm(0.95) * (10 / sqrt(25))
power1 <- 1 - pnorm((crit - 106) / (10 / sqrt(25)))
round(c(crit = crit, power = power1, beta = 1 - power1), 4)
    crit    power     beta
103.2897   0.9123   0.0877
📝 解釈・補足
検出力0.9123は「真の平均が106なら、約91%の確率で有意な差として検出できる」という意味です。臨床試験のサンプルサイズ設計で目標にされる「検出力80〜90%」は、この量そのものです。本番では、棄却域を立てる段階では \(\mu=100\)(\(H_0\))を、検出力を計算する段階では \(\mu=106\)(\(H_1\))を中心に置く、という中心の切り替えを見落とさないでください。
検出力0.9123は「真の平均が106なら、約91%の確率で有意な差として検出できる」という意味です。臨床試験のサンプルサイズ設計で目標にされる「検出力80〜90%」は、この量そのものです。本番では、棄却域を立てる段階では \(\mu=100\)(\(H_0\))を、検出力を計算する段階では \(\mu=106\)(\(H_1\))を中心に置く、という中心の切り替えを見落とさないでください。
例題2 二項分布で実際の有意水準とp値を求める
問題 成功回数 \(X\) が二項分布に従う試行で、\(n=10\)、\(H_0:p=0.5\) 対 \(H_1:p>0.5\) を名目有意水準5%で検定します。(1) 棄却域 \(X\ge9\) と \(X\ge8\) のそれぞれについて実際の有意水準を求め、名目5%を超えないのはどちらか答えてください。(2) 観測値 \(x=9\) のp値を求めてください。(3) 真の \(p=0.8\) のとき、棄却域 \(X\ge9\) の検出力を求めてください。 解答 \(H_0\) のもとでは、\(X=x\) となる確率は \(\binom{10}{x}/2^{10}\) です。(1) 尾の確率を数えると、\[P(X\ge9)=\frac{10+1}{1024}=0.0107,\quad P(X\ge8)=\frac{45+10+1}{1024}=0.0547\]
\(X\ge8\) は名目5%を超えるため使えず、棄却域は \(X\ge9\) で、実際の有意水準は1.07%です。(2) p値は「観測以上に \(H_1\) 側へ極端な結果が \(H_0\) のもとで出る確率」なので、\(P(X\ge9\mid p=0.5)=0.0107\) です。(3) 検出力は \(p=0.8\) のもとでの棄却確率で、\[P(X\ge9\mid p=0.8)=10\times0.8^9\times0.2+0.8^{10}=0.2684+0.1074=0.3758\]
検算 \(\binom{10}{8}=45\) を使うと \(P(X\ge8)\) の分子が \(45+10+1=56\) となり、(1) の数え上げと一致します。 Rで答え合わせをします。# 例題2:二項分布の正確な検定(実際の有意水準と検出力)
alpha9 <- 1 - pbinom(8, size = 10, prob = 0.5)
alpha8 <- 1 - pbinom(7, size = 10, prob = 0.5)
power2 <- 1 - pbinom(8, size = 10, prob = 0.8)
round(c(alpha_Xge9 = alpha9, alpha_Xge8 = alpha8, power_p08 = power2), 4)
alpha_Xge9 alpha_Xge8  power_p08
    0.0107     0.0547     0.3758
📝 解釈・補足
離散分布では確率が飛び飛びの値しか取らないため、有意水準をちょうど5%にはできず、検定は保守的(実際の水準1.07%)になります。その代償として検出力は0.3758と低く、\(n=10\) では \(p=0.8\) という大きな差でも6割以上を見逃します。症例数が少ない臨床試験で正確検定が保守的になる理由も、同じ仕組みです。
離散分布では確率が飛び飛びの値しか取らないため、有意水準をちょうど5%にはできず、検定は保守的(実際の水準1.07%)になります。その代償として検出力は0.3758と低く、\(n=10\) では \(p=0.8\) という大きな差でも6割以上を見逃します。症例数が少ない臨床試験で正確検定が保守的になる理由も、同じ仕組みです。
⚠️ 注意
p値は「帰無仮説が正しい確率」ではありません。あくまで \(H_0\) のもとで計算した確率です。有意水準(\(H_0\) のもとで棄却する確率)・検出力(\(H_1\) のもとで棄却する確率)・p値(\(H_0\) のもとで観測以上に極端な結果が出る確率)の3つは、「どの仮説を条件にしているか」で整理すると混同しません。
p値は「帰無仮説が正しい確率」ではありません。あくまで \(H_0\) のもとで計算した確率です。有意水準(\(H_0\) のもとで棄却する確率)・検出力(\(H_1\) のもとで棄却する確率)・p値(\(H_0\) のもとで観測以上に極端な結果が出る確率)の3つは、「どの仮説を条件にしているか」で整理すると混同しません。
最も強力な検定 ― ネイマン・ピアソンの補題と一様最強力検定
有意水準を固定したとき、検出力を最大にする棄却域はどう決まるのでしょうか。その答えを与えるのがネイマン・ピアソンの補題です。帰無仮説 \(H_0:\theta=\theta_0\) と対立仮説 \(H_1:\theta=\theta_1\) がともに1つの値だけからなる単純仮説同士の場合、尤度比が定数 \(k\) を超える領域を棄却域とする検定が、その有意水準のもとで最も強力(検出力が最大)になります。\[\frac{L(\theta_1)}{L(\theta_0)}>k\]
直感的には、「対立仮説のもとで相対的に起こりやすいデータほど優先して棄却する」ということです。ただし、これは対立仮説が1点の場合の話です。対立仮説が \(\theta>\theta_0\) のような複合仮説でも、すべての \(\theta_1\) に対して同時に最強力な検定が存在するとき、それを一様最強力検定(UMP検定)と呼びます。尤度比が十分統計量の単調関数になる(単調尤度比をもつ)分布族では、棄却域の形が対立仮説の値によらず同じになり、UMP検定が得られます。例題3と例題4で、この2つの形を確認します。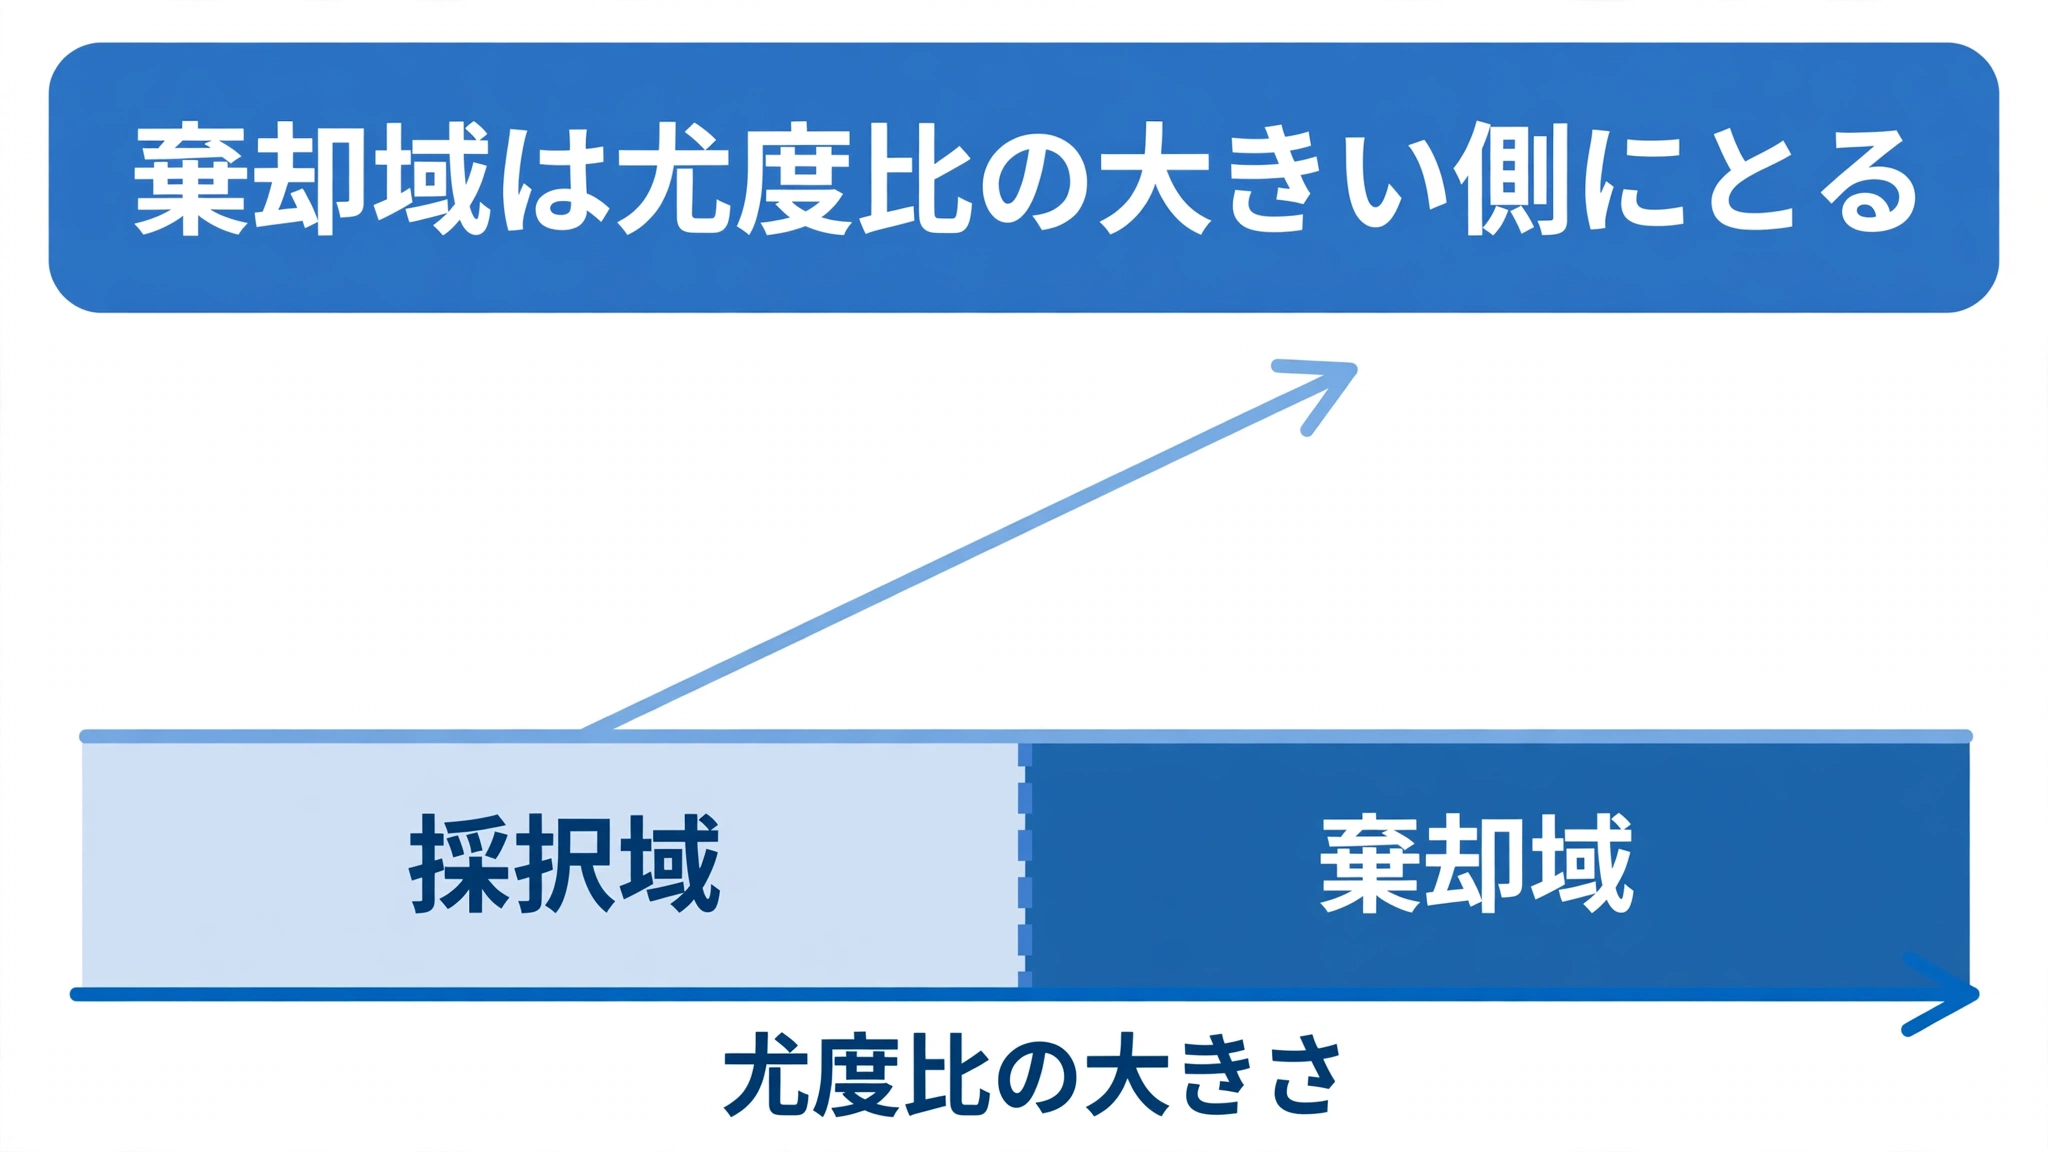
例題3 ポアソン分布の最強力検定とランダム化
問題 不良品数 \(X\) がポアソン分布に従うとします。\(H_0:\lambda=2\) 対 \(H_1:\lambda=5\) を有意水準5%で検定する最強力検定(ランダム化を許す)を求め、その検出力を計算してください。 解答 ①使うのはネイマン・ピアソンの補題です。尤度比は\[\frac{L(5)}{L(2)}=\frac{e^{-5}5^x/x!}{e^{-2}2^x/x!}=e^{-3}\left(\frac{5}{2}\right)^x\]
となり、\(x\) の単調増加関数です。したがって棄却域は「\(X\) が大きい側」になります。②境界を決めます。\(H_0\) のもとで \(P(X\ge6)=0.0166\)、\(P(X=5)=0.0361\) です。\(X\ge6\) だけでは5%に届かず、\(X\ge5\) では超えてしまいます。③そこで、\(X=5\) のとき確率 \(\gamma\) で棄却するランダム化を入れ、\(0.0166+0.0361\gamma=0.05\) を解くと \(\gamma=0.9265\) です。④検出力は \(\lambda=5\) のもとで計算し、\(P(X\ge6)+\gamma P(X=5)=0.3840+0.9265\times0.1755=0.5466\) となります。 検算 ランダム化なしで \(X\ge6\) を棄却域にすると有意水準は0.0166と保守的になり、検出力も0.3840まで下がります。ランダム化はこの差を埋める仕掛けです。 Rで答え合わせをします。# 例題3:ポアソン分布の最強力検定(ネイマン・ピアソンの補題とランダム化)
p_ge6_H0 <- 1 - ppois(5, lambda = 2)
p_eq5_H0 <- dpois(5, lambda = 2)
gamma3 <- (0.05 - p_ge6_H0) / p_eq5_H0
power3 <- (1 - ppois(5, lambda = 5)) + gamma3 * dpois(5, lambda = 5)
round(c(p_ge6_H0 = p_ge6_H0, p_eq5_H0 = p_eq5_H0,
gamma = gamma3, power = power3), 4)
p_ge6_H0 p_eq5_H0    gamma    power
  0.0166   0.0361   0.9265   0.5466
📝 解釈・補足
最強力検定は「\(X\ge6\) なら棄却、\(X=5\) なら確率0.9265で棄却」で、検出力は0.5466です。離散分布では有意水準をちょうど5%に合わせるためにランダム化が要ります。本番では、棄却域が大きい側になる理由を尤度比の単調性で説明できることが問われます。
最強力検定は「\(X\ge6\) なら棄却、\(X=5\) なら確率0.9265で棄却」で、検出力は0.5466です。離散分布では有意水準をちょうど5%に合わせるためにランダム化が要ります。本番では、棄却域が大きい側になる理由を尤度比の単調性で説明できることが問われます。
例題4 一様分布の一様最強力検定(標本最大値)
問題 \(U(0,\theta)\) からの \(n=5\) の標本で、\(H_0:\theta=1\) 対 \(H_1:\theta>1\) を有意水準5%で検定します。(1) 標本最大値 \(X_{(5)}\) を使う棄却域 \(X_{(5)}>k\) の定数 \(k\) を求めてください。(2) \(\theta=1.5\) のときの検出力を求めてください。(3) 観測された最大値が1を超えた場合、検定はどうなるか述べてください。 解答 ①尤度比は標本最大値 \(X_{(5)}\) の単調関数になるため、棄却域は最大値が大きい側です。(1) \(H_0\) のもとで \(P(X_{(5)}\le k)=k^5\) なので、\(1-k^5=0.05\) から \(k=0.95^{1/5}=0.9898\) です。(2) \(\theta=1.5\) のもとでは \(P(X_{(5)}>k)=1-\left(\frac{k}{1.5}\right)^5=1-0.1251=0.8749\) が検出力となります。(3) 最大値が1を超えた標本は、台が \([0,1]\) の \(H_0\) のもとでは起こり得ないため、その時点で直ちに棄却できます。 検算 棄却域の形は対立仮説の \(\theta\) の値に依存しないため、この検定はすべての \(\theta>1\) に対して最強力、つまりUMP検定になっています。 Rで答え合わせをします。# 例題4:一様分布の一様最強力検定(標本最大値)
k4 <- 0.95^(1 / 5)
power4 <- 1 - (k4 / 1.5)^5
round(c(k = k4, power_theta15 = power4), 4)
            k power_theta15
       0.9898        0.8749
📝 解釈・補足
答えは \(k=0.9898\)、\(\theta=1.5\) での検出力0.8749です。一様分布は台(分布の範囲)がパラメータに依存する特殊な例で、最大値が十分統計量になること、標本が台の外に出れば即棄却になることがポイントです。本番では \(P(X_{(n)}\le k)=\left(\frac{k}{\theta}\right)^n\) の導出を書けるようにしておきましょう。
答えは \(k=0.9898\)、\(\theta=1.5\) での検出力0.8749です。一様分布は台(分布の範囲)がパラメータに依存する特殊な例で、最大値が十分統計量になること、標本が台の外に出れば即棄却になることがポイントです。本番では \(P(X_{(n)}\le k)=\left(\frac{k}{\theta}\right)^n\) の導出を書けるようにしておきましょう。
⚠️ 注意
UMP検定が存在するのは、単調尤度比をもつ分布族の片側検定など、条件がそろった場合だけです。両側検定では一般にUMP検定は存在しません。また例題3のランダム化検定は理論を完成させるための道具で、臨床試験などの実務で実際に使うことはまずありません。実務では離散分布の検定は保守的な棄却域で運用されます。
UMP検定が存在するのは、単調尤度比をもつ分布族の片側検定など、条件がそろった場合だけです。両側検定では一般にUMP検定は存在しません。また例題3のランダム化検定は理論を完成させるための道具で、臨床試験などの実務で実際に使うことはまずありません。実務では離散分布の検定は保守的な棄却域で運用されます。
尤度比検定 ― t検定との一致と漸近カイ二乗
尤度比検定は、帰無仮説のもとでの最大尤度と、制約なしの最大尤度の比で検定を組み立てる方法です。尤度比を \(\Lambda=\frac{\text{帰無仮説のもとでの最大尤度}}{\text{制約なしの最大尤度}}\) とすると、\(\Lambda\) は1以下で、小さいほどデータが帰無仮説に合わないことを示します。検定統計量には \(-2\log\Lambda\) を使うのが通例です。\[-2\log\Lambda\ \xrightarrow{d}\ \chi^2(\text{帰無仮説で固定したパラメータの数})\]
帰無仮説のもとで、標本サイズが大きいとき \(-2\log\Lambda\) はカイ二乗分布に近づく、というのがWilksの定理です。自由度は「全体のパラメータ数 − 帰無仮説のもとでのパラメータ数」です。この1つの枠組みで、t検定も適合度検定も統一的に扱えます。例題5 尤度比検定はt検定と一致するか確かめる
問題 正規母集団(分散未知)からの \(n=16\) の標本で \(\bar{x}=52\)、不偏標準偏差 \(s=8\) でした。\(H_0:\mu=50\) 対 \(H_1:\mu\ne50\) を尤度比検定で検定してください。(1) 尤度比統計量 \(-2\log\Lambda\) を求めてください。(2) 漸近カイ二乗分布(自由度1)によるp値と、t検定の正確なp値を比べてください。 解答 ①正規分布の平均の尤度比統計量は、t統計量で書き直せます。まず \(t=\frac{52-50}{8/\sqrt{16}}=1.0\) です。②尤度比統計量は \(-2\log\Lambda=n\log\left(1+\frac{t^2}{n-1}\right)\) の形になります。③数値を代入すると、\[-2\log\Lambda=16\times\log\left(1+\frac{1}{15}\right)=16\times0.0645=1.0326\]
④自由度1のカイ二乗分布の5%点は3.84で、1.0326はこれより小さいため棄却しません。p値は漸近カイ二乗で0.3095、t分布(自由度15)による正確な値は0.3332です。\(-2\log\Lambda\) は \(t^2\) の単調増加関数なので、尤度比検定とt検定は棄却・非棄却が常に一致する同等な検定です。 検算 漸近p値0.3095と正確なp値0.3332の差は小さく、結論(棄却しない)は変わりません。 Rで答え合わせをします。# 例題5:尤度比検定とt検定(正規分布・分散未知)
n5 <- 16; xbar5 <- 52; s5 <- 8
t5 <- (xbar5 - 50) / (s5 / sqrt(n5))
lrt5 <- n5 * log(1 + t5^2 / (n5 - 1))
round(c(t = t5, minus2logLambda = lrt5,
p_chisq = 1 - pchisq(lrt5, df = 1),
p_t = 2 * (1 - pt(abs(t5), df = n5 - 1))), 4)
              t minus2logLambda         p_chisq             p_t
         1.0000          1.0326          0.3095          0.3332
📝 解釈・補足
答えは \(-2\log\Lambda=1.0326\) で、棄却しません。
漸近p値0.3095は正確な0.3332より小さく(反保守的)、標本サイズが小さいとカイ二乗近似は楽観的に出ます。本番では、まず帰無・対立それぞれの最大尤度を押さえ、\(-2\log\Lambda\) が \(t^2\) の単調関数になる形を見抜くことが要点です。
答えは \(-2\log\Lambda=1.0326\) で、棄却しません。
漸近p値0.3095は正確な0.3332より小さく(反保守的)、標本サイズが小さいとカイ二乗近似は楽観的に出ます。本番では、まず帰無・対立それぞれの最大尤度を押さえ、\(-2\log\Lambda\) が \(t^2\) の単調関数になる形を見抜くことが要点です。
例題6 適合度をG検定とカイ二乗検定で比べる
問題 サイコロを60回投げたところ、各目の回数は次のとおりでした。「サイコロは均等である」という仮説を、尤度比検定(G検定)とピアソンのカイ二乗検定で検定してください。| 目 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 観測度数 | 8 | 12 | 9 | 11 | 10 | 10 |
\[G^2=2\times0.5029=1.0058\]
③ピアソンの統計量は \(\chi^2=\frac{(8-10)^2+(12-10)^2+(9-10)^2+(11-10)^2}{10}=\frac{10}{10}=1.0\) です。④自由度5のカイ二乗分布の5%点は11.07で、どちらもはるかに小さいため棄却しません。p値はG検定0.9621、カイ二乗0.9626です。 検算 2つの統計量1.0058と1.0、p値0.9621と0.9626がほぼ一致し、Wilksの定理の漸近カイ二乗性が具体例で確認できます。 Rで答え合わせをします。# 例題6:適合度の尤度比検定(G検定)とカイ二乗検定
obs <- c(8, 12, 9, 11, 10, 10)
exp6 <- rep(10, 6)
G2 <- 2 * sum(obs * log(obs / exp6))
X2 <- sum((obs - exp6)^2 / exp6)
round(c(G2 = G2, p_G = 1 - pchisq(G2, df = 5),
X2 = X2, p_X = 1 - pchisq(X2, df = 5)), 4)
    G2    p_G     X2    p_X
1.0058 0.9621 1.0000 0.9626
📝 解釈・補足
答えは \(G^2=1.0058\)、\(\chi^2=1.0\) で、どちらも棄却しません。
G検定とピアソンのカイ二乗検定は、帰無仮説のもとで同じカイ二乗分布(自由度=セル数−1=5)に近づく漸近的に同等な検定です。自由度を6としないよう、「推定していない分だけ引く」感覚を押さえてください。
答えは \(G^2=1.0058\)、\(\chi^2=1.0\) で、どちらも棄却しません。
G検定とピアソンのカイ二乗検定は、帰無仮説のもとで同じカイ二乗分布(自由度=セル数−1=5)に近づく漸近的に同等な検定です。自由度を6としないよう、「推定していない分だけ引く」感覚を押さえてください。
検出力とサンプルサイズ
検出力が決まれば、式を逆向きに解いて必要な標本サイズ \(n\) が求まります。検定の設計はこの逆算そのものです。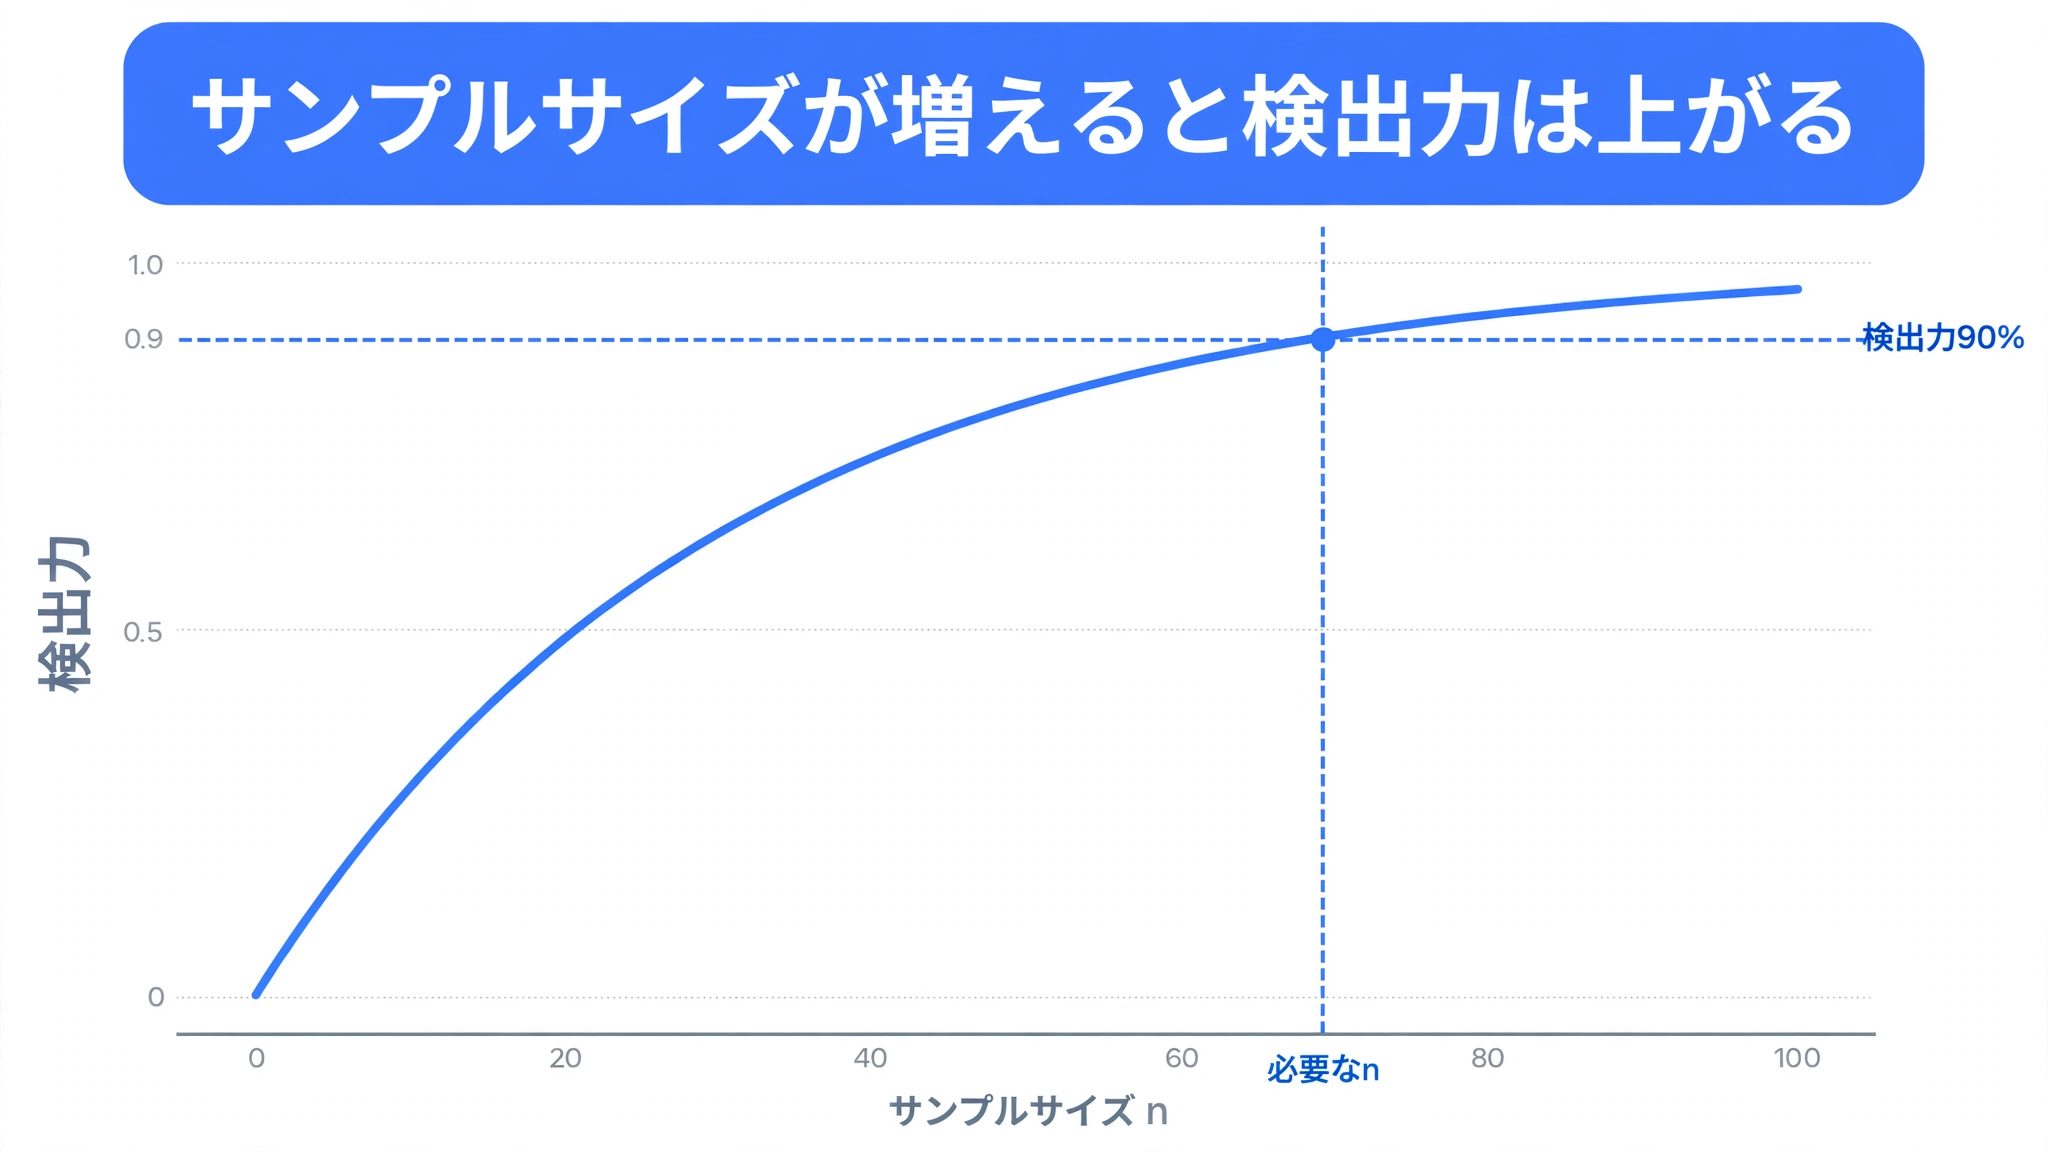
例題7 検出力90%に必要なサンプルサイズを求める
問題 \(\sigma=10\) が既知の正規母集団で、\(H_0:\mu=100\) 対 \(H_1:\mu>100\) を片側有意水準5%で検定します。真の平均が \(\mu=105\) のときに検出力90%以上を確保するには、標本サイズ \(n\) はいくつ必要ですか。 解答 ①検出力の条件は、効果 \(\delta=105-100=5\) を使って \(\frac{\delta\sqrt{n}}{\sigma}\ge z_{0.05}+z_{0.10}\) と書けます。②数値表から \(z_{0.05}=1.645\)、\(z_{0.10}=1.282\) で、和は2.927です。③ \(n\) について解くと、\[n\ge\left(\frac{2.927\times10}{5}\right)^2=34.26\]
④ \(n\) は整数なので、切り上げて \(n=35\) が必要です。 検算 \(n=35\) での実際の検出力は \(\Phi(5\sqrt{35}/10-1.645)=\Phi(1.313)=0.9054\) で、90%を満たします。 Rで答え合わせをします。# 例題7:検出力からサンプルサイズを決める
n_need <- ((qnorm(0.95) + qnorm(0.90)) * 10 / 5)^2
power35 <- pnorm(5 * sqrt(35) / 10 - qnorm(0.95))
round(c(n_need = n_need, power_n35 = power35), 4)
   n_need power_n35
  34.2554    0.9054
📝 解釈・補足
答えは \(n=35\) です。
必要な \(n\) は、検出したい差 \(\delta\) と標準偏差 \(\sigma\) の比で決まります。臨床試験のサンプルサイズ設計も、検出したい群間差・想定する標準偏差・検出力から \(n\) を逆算する、この計算そのものです。
答えは \(n=35\) です。
必要な \(n\) は、検出したい差 \(\delta\) と標準偏差 \(\sigma\) の比で決まります。臨床試験のサンプルサイズ設計も、検出したい群間差・想定する標準偏差・検出力から \(n\) を逆算する、この計算そのものです。
受験対策・実務でのポイント
例題1〜7を通して、間違いやすいのは計算よりも「条件の取り方」と「近似の限界」でした。最後に整理します。- 有意水準と検出力で条件を取り違えない:有意水準は帰無仮説のもと、検出力は対立仮説(真のパラメータ値)のもとで計算します(例題1)。
- 離散分布では実際の有意水準を確認する:名目5%でも実際は1.07%までしか使えないことがあります(例題2)。ちょうどに合わせる仕掛けがランダム化です(例題3)。
- 尤度比は最大尤度同士の比:まず帰無・対立それぞれの最大尤度を押さえ、\(-2\log\Lambda\) とWilksの定理の自由度を確認します(例題5・6)。
- 漸近と正確な値はずれる:小さい標本ではカイ二乗近似のp値は小さめに出ます。正確な分布(t分布など)が使える場面ではそちらが優先です(例題5)。
- サンプルサイズは差とばらつきの比で決まる:\(\delta/\sigma\) が半分になれば必要な \(n\) は4倍になります(例題7)。
🔑 まとめ・実務ポイント
本番での手順は3つです。(1)「どの仮説のもとでの確率か」を先に固定する。(2)尤度比が出たら最大尤度の比と自由度を確認し、漸近近似でよいか判断する。(3)サンプルサイズは検出力の式を逆向きに解く。この3手順で、仮説検定の理論問題はほぼ処理できます。
本番での手順は3つです。(1)「どの仮説のもとでの確率か」を先に固定する。(2)尤度比が出たら最大尤度の比と自由度を確認し、漸近近似でよいか判断する。(3)サンプルサイズは検出力の式を逆向きに解く。この3手順で、仮説検定の理論問題はほぼ処理できます。
📚 この記事をより深く理解するための参考書籍
『統計検定準1級対応 統計学実践ワークブック』日本統計学会 編(学術図書出版社)
『統計検定準1級対応 統計学実践ワークブック』日本統計学会 編(学術図書出版社)

日本統計学会が編集した準1級対応の公式ワークブックです。仮説検定の章では、過誤と検出力、最強力検定、尤度比検定が準1級の水準で体系的に整理されています。本記事の例題で「なぜこの棄却域になるのか」で手が止まったときに、該当する章へ戻る使い方がおすすめです。なお、2026年には統計的因果推論の章を追加した増補版も刊行されています。
『日本統計学会公式認定 統計検定 準1級 公式問題集』日本統計学会 編(実務教育出版、2021年)

過去問題と解説を収録した公式問題集です。本記事で理論の流れをつかんだら、制限時間内に「どの定理を使う問題か」を見分けて計算する練習に使ってください。検出力の計算や尤度比検定の立式といった同型の問題で、手順の定着を確かめるのに最適です。
『現代数理統計学の基礎』久保川達也(共立出版、2017年)

数理統計学を理論の土台から積み上げるテキストで、仮説検定の章ではネイマン・ピアソンの補題、一様最強力検定、尤度比検定の証明と使い方が丁寧に扱われています。本記事の例題で「なぜ尤度比で決まるのか」を数式で追いたくなったときに読むと、理解が一段深まります。1級を見据える方にも土台になる一冊です。
生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
- 統計検定準1級「統計的推定」攻略 ― 最尤法・十分統計量・フィッシャー情報量・クラメール–ラオの不等式の典型出題対策 ―
- 統計検定準1級「ノンパラメトリック法」攻略 ― 符号検定・Wilcoxon・Kruskal-Wallis・順位相関の典型出題対策 ―
- 統計検定準1級 攻略ガイド ― 出題範囲・勉強法・おすすめ参考書を生物統計家が徹底解説 ―
- 統計検定2級「仮説検定・区間推定」攻略 ― t検定・カイ二乗検定・p値の典型出題を例題7問で解説 ―