統計検定2級「確率分布」攻略 ― 二項・ポアソン・正規分布と標本分布の典型出題を例題7問で解説 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
統計検定2級の対策として、出題範囲のうち「確率分布」に絞り、本番で出そうな例題を筆者(生物統計家)が選定しました。数値はすべてRで検算したうえで掲載しています。
この記事でわかること
- 分布表から期待値・分散・共分散・相関係数を手計算で求める方法
- 二項分布とポアソン分布の使い分けと、確率の計算手順
- 標準化と標準正規分布表を使った確率の読み方(上位10%点の求め方まで)
- 中心極限定理と標本分布(カイ二乗分布・t分布)が、検定・区間推定にどうつながるか
本記事は、統計検定2級の攻略シリーズの第2弾です。第1弾統計検定2級「仮説検定・区間推定」攻略では、信頼区間と検定の手続きを例題7問で解説しました。本記事はその土台編にあたり、検定統計量が従う「分布」そのものを扱います。第1弾で「なぜt分布なのか」で止まってしまった方は、本記事から読むと手続きの意味がつながります。各例題にはRのコードと出力を併記していますので、手計算の答え合わせまで、この1記事の中で完結します。
はじめに
統計検定2級の試験はCBT方式で、試験時間は90分、出題は35問程度、4〜5肢の選択式です。100点満点で60点以上が合格で、試験中は四則演算・百分率・平方根ができる普通電卓のみが使えます(関数電卓は不可)。限られた時間で計算問題を落とさないためには、公式を覚えるだけでなく「どの分布の問題か」を一瞬で見分ける力が要ります。
出題範囲のうち確率分布の分野には、確率変数と確率分布、期待値・分散の計算、代表的な分布(二項・ポアソン・正規など)が含まれます。さらに標本分布の分野では、標本平均の分布、大数の法則、中心極限定理、カイ二乗分布・t分布・F分布が問われます。検定や区間推定の計算はすべてこの土台の上に乗っているため、ここでつまずくと第1弾の手続きも丸暗記になってしまいます。
本記事では、確率分布と標本分布の典型出題を例題7問に絞り、第1弾と同じ形式で解説します。各例題は「問題 → 普通電卓でできる手計算の途中式 → 数値表の値との照合 → Rでの答え合わせ → 解釈」の順に進めます。なお、二項分布の正規近似(連続修正)やF分布は本記事の例題の対象外とし、土台になる7問に絞りました。
確率分布が苦手になりやすいのは、\(\lambda\) や \(\Phi\) といった記号が先に立ち、具体的な数値のイメージが持てないまま公式だけを覚えようとするためです。本記事の例題は、身長・不良品の個数・問い合わせの件数といった身近な対象に数値を入れてあります。読み方は、まず答えを見ずに電卓で手計算し、詰まった箇所だけ解答の途中式と照らし合わせるのがおすすめです。Rのコードは答え合わせ専用ですので、Rが使えない環境でも学習に支障はありません。また、確率の数値表は丸暗記するものではなく、標準化した値を「どの行・どの列で読むか」に慣れるための道具です。本記事の例題で読み方を一度身につければ、表の形式が変わっても対応できます。
確率変数と期待値・分散 ― 分布表から計算する
確率分布の計算の出発点は、期待値と分散です。値と確率の対応がわかれば、代表的な分布も標本分布も同じ道具で扱えます。ここでは分布表から手計算し、Rで答え合わせします。
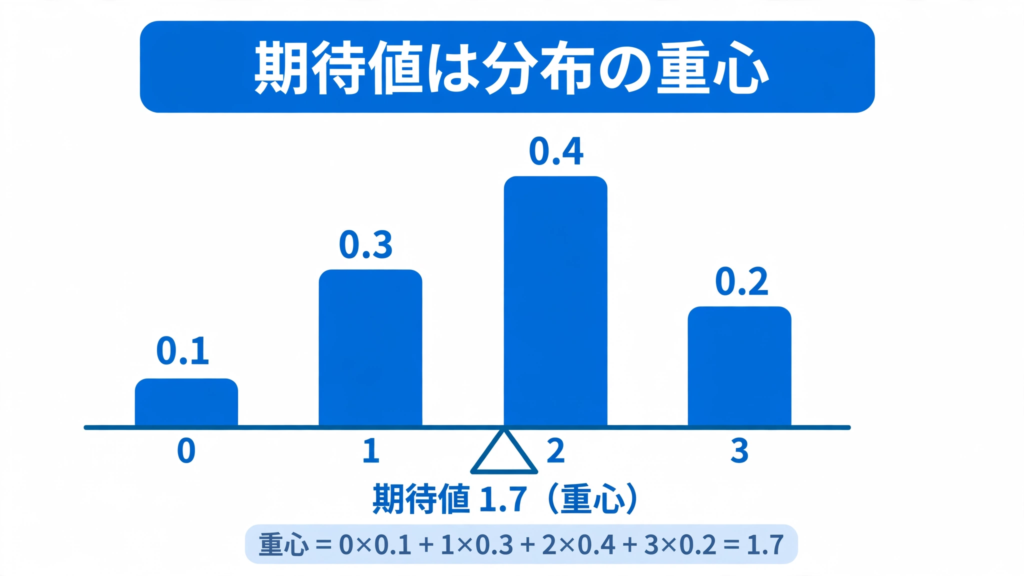
例題1 確率分布表から期待値と分散を求める
問題 確率変数 \(X\) が \(P(X=0)=0.1\)、\(P(X=1)=0.3\)、\(P(X=2)=0.4\)、\(P(X=3)=0.2\) の分布に従うとき、\(E[X]\)、\(V[X]\)、\(E[2X+3]\)、\(V[2X+3]\) を求めます。
解答 期待値は「値×確率」の合計です。
\[E[X]=0\times0.1+1\times0.3+2\times0.4+3\times0.2=1.7\]
分散は \(V[X]=E[X^2]-E[X]^2\) で計算します。\(E[X^2]=0\times0.1+1\times0.3+4\times0.4+9\times0.2=3.7\) なので \(V[X]=3.7-1.7^2=0.81\)、標準偏差は \(0.9\) です。一次式の性質から \(E[2X+3]=2\times1.7+3=6.4\)、\(V[2X+3]=2^2\times0.81=3.24\) となります。
検算 確率の合計は \(0.1+0.3+0.4+0.2=1\) で、期待値 \(1.7\) は取りうる値の範囲内に収まります。
Rで答え合わせします。
# 例題1:確率分布表から期待値と分散を求める
x <- 0:3
p <- c(0.1, 0.3, 0.4, 0.2)
EX <- sum(x * p)
EX2 <- sum(x^2 * p)
VX <- EX2 - EX^2
round(c(E_X = EX, E_X2 = EX2, V_X = VX, sd = sqrt(VX),
E_2X3 = 2 * EX + 3, V_2X3 = 4 * VX), 4)
  E_X  E_X2   V_X    sd E_2X3 V_2X3
 1.70  3.70  0.81  0.90  6.40  3.24
期待値 \(1.7\) は、確率の大きい \(2\) の近くに位置します。本番では、定数 \(3\) を分散にも足してしまう間違いが典型です。分散に効くのは係数 \(2\) の2乗だけだと押さえてください。
例題2 同時分布から共分散と相関係数を求める
問題 \(X\)、\(Y\) はそれぞれ \(0\) か \(1\) をとり、同時確率は次の表のとおりです。\(X\) と \(Y\) が独立か判定し、共分散と相関係数を求めます。
| \(X\) \ \(Y\) | 0 | 1 |
|---|---|---|
| 0 | 0.4 | 0.1 |
| 1 | 0.2 | 0.3 |
解答 まず周辺分布を求めます。\(P(X=1)=0.2+0.3=0.5\)、\(P(Y=1)=0.1+0.3=0.4\) なので、\(E[X]=0.5\)、\(E[Y]=0.4\) です。積 \(XY\) が \(1\) になるのは \((1,1)\) のときだけなので \(E[XY]=0.3\) で、共分散は \(\mathrm{Cov}(X,Y)=0.3-0.5\times0.4=0.1\) となります。独立の判定は、\(P(X=1)P(Y=1)=0.5\times0.4=0.2\) が \(P(1,1)=0.3\) と異なるため、独立ではありません。\(V[X]=0.5\times0.5=0.25\)、\(V[Y]=0.4\times0.6=0.24\) を使って、相関係数は \(0.1/\sqrt{0.25\times0.24}=0.1/0.2449=0.408\) です。
検算 同時確率の合計は \(0.4+0.1+0.2+0.3=1\) で、相関係数 \(0.408\) は \(-1\) から \(1\) の範囲内です。
Rで答え合わせします。
# 例題2:同時確率表から共分散と相関係数を求める
P <- matrix(c(0.4, 0.2, 0.1, 0.3), nrow = 2) # 行がX=0,1・列がY=0,1
px <- rowSums(P); py <- colSums(P)
EX <- sum(0:1 * px); EY <- sum(0:1 * py)
EXY <- P[2, 2] # XY=1 となるのは (1,1) のみ
cov_xy <- EXY - EX * EY
cor_xy <- cov_xy / sqrt(EX * (1 - EX) * EY * (1 - EY))
round(c(E_X = EX, E_Y = EY, E_XY = EXY, Cov = cov_xy, Cor = cor_xy), 4)
   E_X    E_Y   E_XY    Cov    Cor
0.5000 0.4000 0.3000 0.1000 0.4082
相関係数 \(0.408\) は中程度の正の関係です。製薬実務でも、投与群と副作用の有無のように2つの2値変数の関係を読む場面で、同じ考え方を使います。
共分散が \(0\) でも独立とは限りません。独立の判定は、必ず同時確率と周辺確率の積の一致で確認してください。
代表的な離散分布 ― 二項分布とポアソン分布
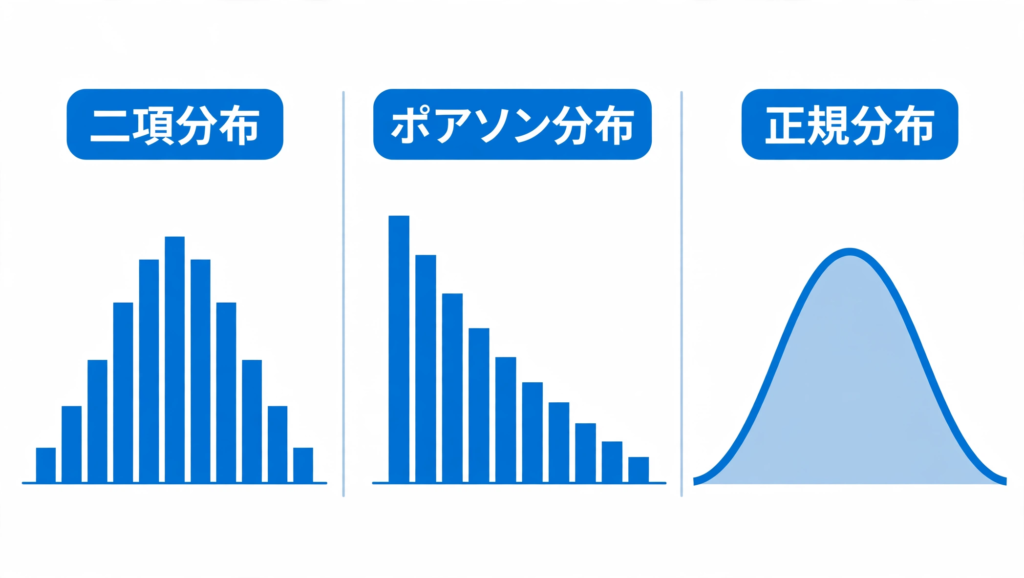
離散分布の主役は、成功の回数を数える二項分布と、発生件数を数えるポアソン分布です。まず、代表的な分布の期待値と分散を一覧で確認します。
| 分布名 | 何を表すか | 期待値 | 分散 |
|---|---|---|---|
| ベルヌーイ分布 | 成功か失敗か1回 | \(p\) | \(p(1-p)\) |
| 二項分布 | \(n\) 回中の成功回数 | \(np\) | \(np(1-p)\) |
| ポアソン分布 | 一定時間の発生回数 | \(\lambda\) | \(\lambda\) |
| 幾何分布 | 初めて成功するまでの試行回数 | \(1/p\) | \((1-p)/p^2\) |
| 一様分布 | 区間 \([a,b]\) のどこも同じ | \((a+b)/2\) | \((b-a)^2/12\) |
| 指数分布 | 次の発生までの待ち時間 | \(1/\lambda\) | \(1/\lambda^2\) |
| 正規分布 | 連続量全般 | \(\mu\) | \(\sigma^2\) |
例題3 二項分布で不良品の確率を求める
問題 ある部品の不良率は10%です。10個を無作為に抜き取るとき、不良品がちょうど2個である確率と、少なくとも1個含まれる確率、あわせて不良個数の期待値と分散を求めてください。
解答 成功確率 \(p=0.1\) の試行を \(n=10\) 回繰り返すので、不良品の個数 \(X\) は二項分布に従います。
\[P(X=2)={}_{10}C_2\times0.1^2\times0.9^8=45\times0.01\times0.4305=0.1937\]
少なくとも1個は余事象で考えます。\(P(X\geq1)=1-0.9^{10}=1-0.3487=0.6513\) です。期待値と分散は \(E[X]=np=1\)、\(V[X]=np(1-p)=0.9\) となります。検算として、ちょうど2個の確率0.1937が、少なくとも1個の確率0.6513以下であることを確認します。
Rで答え合わせをします。
# 例題3:不良率0.1の製品を10個抜き取るときの不良個数(二項分布)
round(c(P_X2 = dbinom(2, size = 10, prob = 0.1),
P_Xge1 = 1 - dbinom(0, size = 10, prob = 0.1)), 4)
  P_X2 P_Xge1
0.1937 0.6513
c(E = 10 * 0.1, V = 10 * 0.1 * 0.9)
  E   V
1.0 0.9
期待値は1個でも、「少なくとも1個」は0.6513と6割を超えます。治験で一定割合で起こる副作用の発現人数も、同じ二項分布で考えます。
例題4 ポアソン分布で問い合わせ件数を求める
問題 ある窓口への問い合わせは1時間に平均3件です。1時間に0件の確率、ちょうど5件の確率、1件以下の確率を求めてください。
解答 単位時間あたりの平均発生件数 \(\lambda=3\) のポアソン分布を使います。
\[P(X=0)=e^{-3}=0.0498\]
ちょうど5件は \(P(X=5)=e^{-3}\times3^5/5!=0.0498\times2.025=0.1008\) です。1件以下は \(P(X\leq1)=P(X=0)+P(X=1)=0.0498+0.1494=0.1991\)(\(P(X=1)=e^{-3}\times3=0.1494\))となります。期待値と分散はともに \(\lambda=3\) です。検算として、\(P(X\leq1)\) が \(P(X=0)\) の0.0498より大きいことを確認します。
Rで答え合わせをします。
# 例題4:1時間平均3件の問い合わせ件数(ポアソン分布)
round(c(P_X0 = dpois(0, lambda = 3),
P_X5 = dpois(5, lambda = 3),
P_Xle1 = ppois(1, lambda = 3)), 4)
  P_X0   P_X5 P_Xle1
0.0498 0.1008 0.1991
平均3件でも、0件が0.0498、1件以下が0.1991あります。来院件数のような「一定時間の発生件数」は、平均だけで判断せず分布で捉えることが大切です。
試行回数 \(n\) が決まっていれば二項分布、観察する時間や区間が決まっていればポアソン分布です。問題文の「何が固定されているか」で分布を選びます。
正規分布と標準化 ― 数値表で確率を読む
連続量を表す分布の代表が正規分布です。平均 \(\mu\) と標準偏差 \(\sigma\) で形が決まり、標準化すれば標準正規分布の数値表で確率が読めます。
例題5 正規分布で身長の確率と上位10%点を求める
問題 成人男性の身長は平均170cm・標準偏差6cmの正規分布に従います。176cm以上の人の割合、164cm以上176cm以下の人の割合、身長が高いほうから10%に入る境界値を求めてください。
解答 標準化は \(z=(x-\mu)/\sigma\) で行います。176cmは \(z=(176-170)/6=1\) なので、上側の確率は数値表 \(\Phi(1.00)=0.8413\) を使って求めます。
\[P(X\geq176)=1-\Phi(1)=1-0.8413=0.1587\]
164cmは \(z=-1\) で、区間の確率は \(\Phi(1)-\Phi(-1)=0.8413-0.1587=0.6827\) です。上位10%点は \(z=1.282\) なので、境界値は \(170+1.282\times6=177.69\)cm(約177.7cm)となります。検算として、平均の前後1標準偏差の範囲に約68%が入る性質と、0.6827が一致することを確認します。
Rで答え合わせをします。
# 例題5:平均170・標準偏差6の正規分布(身長)
round(c(P_ge176 = 1 - pnorm(176, mean = 170, sd = 6),
P_164_176 = pnorm(176, 170, 6) - pnorm(164, 170, 6),
top10 = qnorm(0.9, mean = 170, sd = 6)), 4)
  P_ge176 P_164_176     top10
   0.1587    0.6827  177.6893
176cm以上は0.1587で、上位10%の境界は177.69cmです。本番では「以上」と言われたら上側の確率を取る方向を間違えないようにします。
標本分布と中心極限定理 ― 検定の土台になる分布
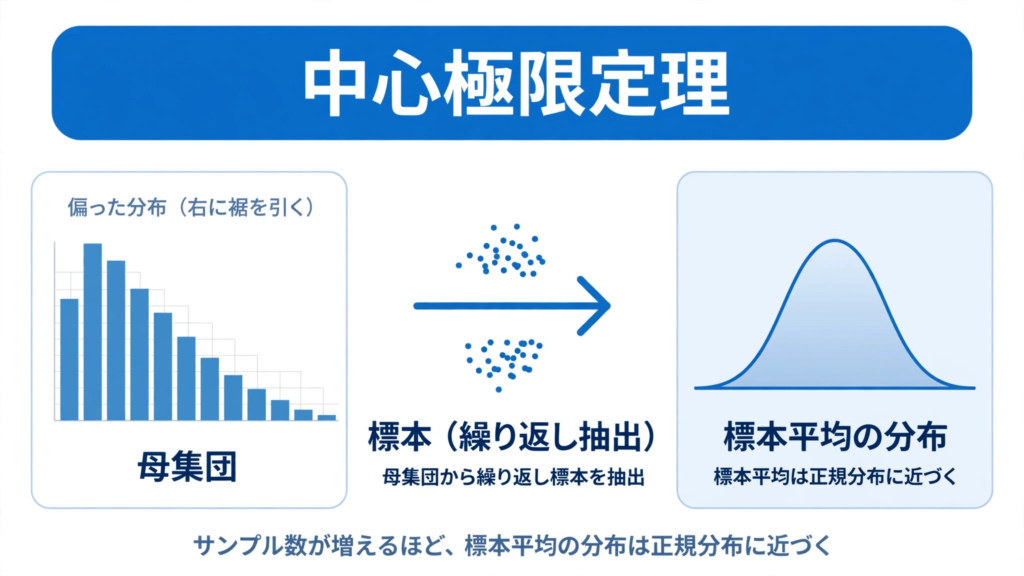
標本から計算した統計量が従う分布を標本分布といいます。標本平均の標本分布が分かれば、「平均がこれだけずれる確率」を計算でき、検定の考え方につながります。
例題6 中心極限定理 ― 標本平均が52以上になる確率
問題 母平均50・母標準偏差10の母集団から標本を抽出します。標本サイズが100のときと25のとき、標本平均が52以上になる確率をそれぞれ求めてください(標本平均の分布は正規分布で近似します)。
解答 ①中心極限定理により、標本平均は平均 \(\mu\)・標準偏差 \(\sigma/\sqrt{n}\)(標準誤差)の正規分布で近似できます。②標準誤差は \(n=100\) で \(10/\sqrt{100}=1\)、\(n=25\) で \(10/\sqrt{25}=2\) です。③ \(n=100\) では \(z=(52-50)/1=2\) から \(1-\Phi(2)=1-0.9772=0.0228\)、\(n=25\) では \(z=(52-50)/2=1\) から \(1-\Phi(1)=0.1587\) です。
検算:\(n\) が4倍で標準誤差は半分になり、同じずれでも \(z\) は2倍になります。
# 例題6:標本平均の分布(中心極限定理)n=100とn=25の比較
se <- function(n) 10 / sqrt(n)
round(c(SE_n100 = se(100), P_n100 = 1 - pnorm(52, mean = 50, sd = se(100)),
SE_n25 = se(25), P_n25 = 1 - pnorm(52, mean = 50, sd = se(25))), 4)
SE_n100  P_n100  SE_n25   P_n25
 1.0000  0.0228  2.0000  0.1587
同じ「平均から2のずれ」でも、確率は \(n=100\) で0.0228、\(n=25\) で0.1587と大きく違います。珍しさは標本サイズで決まるため、本番では先に標準誤差を計算してから標準化してください。
例題7 カイ二乗分布とt分布 ― 分散と平均の検定への橋渡し
問題 (1) 母分散 \(\sigma^2\) の正規母集団から大きさ11の標本をとり、不偏分散 \(s^2\) を計算しました。\(s^2\) が \(\sigma^2\) の1.831倍を超える確率を求めてください。(2) 第1弾の例題1(\(n=16\)、標本平均52.0、\(s=8.0\))で、母平均を50と仮定したときの \(t\) 値と、その絶対値以上になる確率をRで求めてください。
解答 ①(1) \((n-1)s^2/\sigma^2\) は自由度 \(n-1\) のカイ二乗分布に従い、\(s^2/\sigma^2>1.831\) は \(\chi^2>10\times1.831=18.31\) と同値です。②数値表の \(\chi^2_{0.05}(10)=18.307\) から、確率は5%です。③(2) \(t=(52-50)/(8/\sqrt{16})=2/2=1.0\) です。数値表では \(t_{0.025}(15)=2.131\) より小さいことしか確認できず、正確な確率はRで0.3332となります。
検算:(1)の比1.831はRの1.8307と一致し、(2)は \(|t|=1.0\) が2.131未満なので確率は5%より大きい値です。
# 例題7:カイ二乗分布とt分布の上側確率点
round(c(chi2_0.05_df10 = qchisq(0.95, df = 10),
ratio = qchisq(0.95, df = 10) / 10,
t_0.025_df15 = qt(0.975, df = 15),
p_T1 = 2 * (1 - pt(1.0, df = 15))), 4)
chi2_0.05_df10          ratio   t_0.025_df15           p_T1
       18.3070         1.8307         2.1314         0.3332
カイ二乗分布は分散、t分布は \(\sigma\) 未知の平均を扱う土台です。製薬実務でも、検査値のばらつきの評価や少数例での平均比較では、この2分布が検定統計量の参照先になります。
試験本番で差がつくポイント ― 分布の選び方と典型的な間違い
問われている対象から、使う分布を逆引きできるようにしておきましょう。
| 何を数える・測るか | 使う分布 |
|---|---|
| 成功・失敗の回数 | 二項分布 |
| 一定時間の発生回数 | ポアソン分布 |
| 連続量・標本平均 | 正規分布 |
| 分散/ \(\sigma\) 未知の平均 | カイ二乗分布・t分布 |
典型的な間違いは次の3つです。
- 標本平均の標準化に \(\sigma\) をそのまま使い、標準誤差 \(\sigma/\sqrt{n}\) に直し忘れる
- ポアソン分布で平均と分散が等しいことを忘れ、分散を別に計算しようとする
- t分布の自由度を \(n\) のままにし、\(n-1\) に直し忘れる
本番では、まず「何の確率か」を見て分布を決め、期待値と分散(標本平均なら標準誤差)を書き出してから計算に入ると、取り違えを防げます。
📚 この記事をより深く理解するための参考書籍
確率分布は「公式テキストで定義と公式を確認する」「過去の出題形式で手を慣らす」「理論の土台を固める」の3段階で学ぶと定着します。その3段階に対応する書籍を1冊ずつ選びました。



生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
- 統計検定2級「仮説検定・区間推定」攻略 ― t検定・カイ二乗検定・p値の典型出題を例題7問で解説 ―
- 統計検定2級の勉強法
- 標本分布を理解しよう
- 中心極限定理とは
- 標準偏差(SD)と標準誤差(SE)の違い
- 統計検定準1級 攻略ガイド
まとめ
本記事では、統計検定2級の確率分布と標本分布を、本番で出そうな例題7問を通して整理しました。
期待値と分散では、分布表から \(E[X]=1.7\)、\(V[X]=0.81\) を求め、一次式の分散に定数が効かないことを確認しました。同時分布では共分散 \(0.1\)、相関係数 \(0.408\) を計算し、独立の判定は周辺確率の積との一致で見ることが要点でした。離散分布では、二項分布で \(P(X=2)=0.1937\)、ポアソン分布で \(P(X\leq1)=0.1991\) を求め、「何が固定されているか」で分布を選ぶ感覚を押さえました。正規分布では標準化により \(P(X\geq176)=0.1587\)、上位10%点 \(177.69\)cm を数値表から読みました。標本分布では、同じ「平均から2のずれ」でも標本サイズで確率が \(0.0228\) と \(0.1587\) に変わることを中心極限定理で確認し、カイ二乗分布の \(\chi^2_{0.05}(10)=18.307\) とt分布の確率 \(0.3332\) が、第1弾の検定の棄却限界そのものであることを見ました。
本番で大切なのは、計算の速さよりも「何の確率を問われているかを見て分布を決め、期待値と分散(標本平均なら標準誤差)を書き出してから計算に入る」順序です。この順序は、臨床試験で発現件数や検査値のばらつきを評価する実務でもそのまま使える基本動作ですので、分布の選び方の一覧を手元に置き、公式問題集で繰り返し確かめていただければと思います。
定着させるコツは、例題を「読む」だけで終わらせないことです。数日置いてから本記事を閉じた状態で解き直し、分布の選択と標準誤差の計算を自分の手で再現できるか確かめてください。2回目に詰まった箇所が、そのまま公式問題集で重点的に潰すべき弱点になります。
次の一歩としては、学習計画を立て直すための統計検定2級の勉強法、標本分布の考え方を掘り下げた標本分布を理解しよう、本記事の続きにあたる統計検定2級「仮説検定・区間推定」攻略をあわせてご覧いただくと、分布から検定までの流れが確かなものになり、合格への大きな強みになります。