ベイズ階層モデル ― バスケット試験での借用と縮約をSASで実装 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
ベイズ階層モデル(BHM)によるバスケット試験の解析を、SASのPROC MCMCで実装します。データとモデルはR版と同一にそろえ、SASのコードの書き方と出力の読み方に絞って解説します。
この記事でわかること
- バスケット試験でBHMを使う理由と、独立解析・完全プーリングとの関係
- PROC MCMCでBerry型BHMを書く方法(random文による階層の宣言と、τへの半正規事前分布の書き方)
- 事後サンプル(outpost)を加工して、判定確率 \(\Pr(p_k > 0.20)\) を算出する手順
- τの事前分布を変えた感度分析の進め方と、結果の読み方
本記事は、ベイズ階層モデルでバスケット試験を解く|BHMの借用と縮約をRで実装のSAS実装版です。バスケット試験の背景や借用・縮約の考え方など概念面の詳しい解説はR版に譲り、本記事では要点の確認と、SASでの実装そのものに集中します。数値例はR版と完全に同じ、5バスケットのデータを使います。
はじめに
臨床試験の統計解析では、SASがいまも標準的な環境です。一方で、バスケット試験のような新しいデザインでは、ベイズ階層モデル(BHM)のように標準プロシジャへそのまま当てはめにくいモデルが求められます。「概念はR版で理解したけれど、実務のSAS環境ではどう実装するのか」という橋渡しが本記事の目的です。
実装の中心はPROC MCMCです。尤度・事前分布・階層構造をコードで明示的に宣言できるため、Berry型のBHMもモデルの定義どおりに書き下すことができます。独立解析はMCMCを使わず、共役なベータ事後分布で正確に計算する方法もあわせて示します。
はじめに断っておくと、本記事にはSASの出力(数値)を掲載していません。結果の数値が必要な箇所では、R版で同じデータ・同じモデルを実装して得られた値を、「R版の参照値」と明示して引用しています。サンプラーが異なるため、SASで実行した結果と厳密に一致するものではありませんが、近傍の値が得られているかの確認に使えます。コード自体はSASの公式ドキュメントに沿って確認済みのものだけを載せています。
バスケット試験とベイズ階層モデルの要点
バスケット試験は、1つの標的(バイオマーカーや遺伝子変異など)を共有する複数のがん種を、1つのプロトコルでまとめて評価するデザインです。がん種ごとに「バスケット」と呼ばれるコホートを設け、同じ治療を投与して奏効を測ります。複数の試験を1つの枠組みで効率よく進めるマスタープロトコルの代表例であり、扱う範囲の違いから次の3つに整理されます。
- バスケット試験:1つの標的に対して複数のがん種を評価する
- アンブレラ試験:1つのがん種の中で、標的ごとに治療を割り付ける
- プラットフォーム試験:治療の追加・削除を続けながら複数治療を評価する
本記事はR版のSAS実装版であり、使う数値例もR版と同一です。ここでは実装に必要な概念だけを要約します。
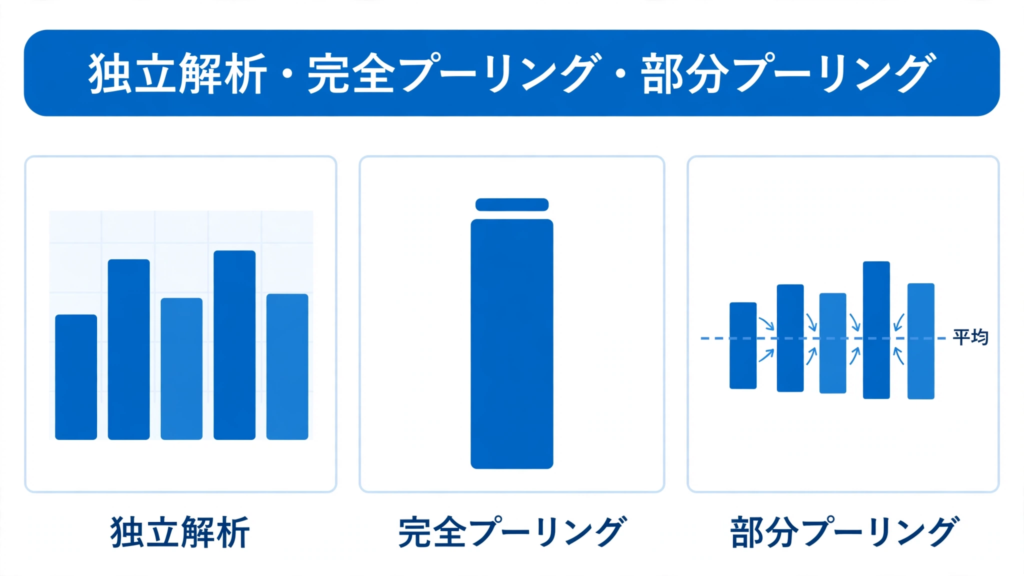
バスケットごとの奏効率をどう見積もるかには、大きく3つの戦略があります。各バスケットを別々に見積もる「独立解析」は素直ですが、1バスケットあたりの症例数が小さいため推定が不安定になります。逆に全バスケットを1つにまとめる「完全プーリング」は安定する一方で、効いているがん種と効いていないがん種の差を潰してしまいます。その中間が「部分プーリング」であり、ベイズ階層モデル(BHM)はこれを実現する標準的な方法です。本記事では、このBHMをSASのPROC MCMCで実装します。
BHMの定式化
第\(k\)バスケットの奏効数を \(y_k\)、症例数を \(n_k\)、真の奏効率を \(p_k\) とすると、尤度は二項分布です。
\[y_k \sim \mathrm{Binomial}(n_k, p_k)\]
奏効率をロジット変換した \(\theta_k=\mathrm{logit}(p_k)\) が、正規分布の階層に従うと仮定します。
\[\theta_k \sim \mathcal{N}(\mu, \tau^2)\]
ここで \(\mu\) はバスケット全体に共通する中心、\(\tau\) はバスケット間のばらつき(異質性)を表します。事前分布は次のとおりです。
| パラメータ | 事前分布 | 意味 |
|---|---|---|
| \(\mu\) | \(\mathcal{N}(-1, 1^2)\) | バスケット共通の中心。奏効率換算で約27%(\(\mathrm{logit}(0.27)\approx-1\))にあたり、弱情報的事前分布として置く |
| \(\tau\) | \(\mathrm{Half\text{-}Normal}(0, 1)\) | バスケット間のばらつき。借用の強さを決める |
縮約係数と借用の直感
\(\tau\) が小さいほど、各バスケットの推定は中心 \(\mu\) の方向へ引き寄せられます。この引き寄せの程度は、縮約係数 \(B_k\) で表すことができます。バスケット \(k\) の推定値は、バスケット単独の推定 \(\hat{\theta}_k^{\text{obs}}\) と全体の中心 \(\hat{\mu}\) の重み付き平均に近づきます。
\[\hat{\theta}_k \approx (1-B_k)\,\hat{\theta}_k^{\text{obs}} + B_k\,\hat{\mu}, \quad B_k \approx \frac{V_k}{V_k+\tau^2}\]
ここで \(V_k \approx \frac{1}{n_k p_k (1-p_k)}\) はバスケット単独で推定したときのばらつきです。極限で見ると、\(\tau \to 0\) では全バスケットが1つにまとまる完全プーリングに、\(\tau \to \infty\) では借用のない独立解析に一致します。つまりBHMは、データが示す異質性の大きさに応じて、2つの極端な戦略の間を自動で調整する仕組みだといえます。
この枠組みは Berry et al. (2013) がバスケット試験向けに整理したもので、本記事の実装もこれに沿います。発展形として、階層モデルと独立解析を混合して頑健化を図る EXNEX(Neuenschwander et al., 2016)もありますが、本記事では基本形のBHMを扱います。
意思決定は事後確率で行います。バスケット \(k\) の奏効率が目標値 \(p_{\text{target}}\) を超える事後確率が、あらかじめ定めたしきい値 \(\delta\)(例:0.80)以上であれば、そのバスケットを「有望」と判定します。
\[\Pr(p_k > p_{\text{target}} \mid \text{data}) \ge \delta\]
縮約の強さは、\(\tau\) の事前分布に大きく依存します。バスケット数が少ない設定ではデータだけから \(\tau\) を精度よく決めることは難しく、事前分布の置き方しだいで推定値が動いてしまいます。そのため、基本設定だけで結論を出さず、\(\tau\) の事前分布を変えた感度分析をセットで行うことが欠かせません。後の節では、この感度分析をSASでどう行うかも示します。
なお、バスケット試験の背景や借用・縮約の考え方など、概念面の詳しい解説はR版にまとめています。本記事では要点の確認にとどめ、次節からはSASでの実装そのものに入ります。
SASによるBHMの実装 ― PROC MCMCで組む
ここからは、R版と同じモデルをSASで実装していきます。本記事では汎用MCMCサンプラーのPROC MCMCを使います。PROC MCMCは尤度・事前分布・階層構造をコードで明示的に宣言できるため、Berry型BHMのように標準的な混合モデルプロシジャでは表しにくいモデルも、そのまま書き下すことができます。なお、階層ベイズモデル向けにはPROC BGLIMMという選択肢もありますが、事前分布の置き方を細かく制御できる点から、本記事ではPROC MCMCを採用します。
データの準備
まず、分析用データセットを作成します。数値はR版と完全に同一で、5つのバスケット(がん種)について、評価可能例数 n と奏効例数 y を並べたものです。
/* バスケット試験のデータ(R版と同じ数値例) */
data basket;
input basket n y;
datalines;
1 20 2
2 18 3
3 22 1
4 19 4
5 20 13
;
run;
| バスケット | n(評価可能例数) | y(奏効例数) | 粗奏効率 |
|---|---|---|---|
| 1 | 20 | 2 | 10.0% |
| 2 | 18 | 3 | 16.7% |
| 3 | 22 | 1 | 4.5% |
| 4 | 19 | 4 | 21.1% |
| 5 | 20 | 13 | 65.0% |
全バスケットを単純に合計した粗奏効率は23/99で約23%です。バスケット5の65.0%が突出して高い一方、バスケット3は4.5%にとどまっており、このばらつきをどう扱うかがBHMの主題になります。
ベースラインとしての独立解析
BHMの結果と比べるため、まずバスケットごとに独立に解析します。二項尤度に対してベータ分布は共役事前分布であり、事後分布もベータ分布になるため、MCMCを使わなくても正確な事後分布が得られます。ここではJeffreys事前分布 Beta(0.5, 0.5) を置き、事後分布 \(\mathrm{Beta}(y+0.5,\ n-y+0.5)\) から事後平均と95%信用区間、さらに目標値0.20を超える事後確率までを計算します。
/* 独立解析:Jeffreys事前分布 Beta(0.5, 0.5) のもとでの正確な事後分布 */
data independent;
set basket;
a = y + 0.5;
b = n - y + 0.5;
post_mean = a / (a + b);
lower = quantile('beta', 0.025, a, b);
upper = quantile('beta', 0.975, a, b);
prob_gt_20 = 1 - cdf('beta', 0.20, a, b);
format post_mean lower upper prob_gt_20 6.3;
run;

proc print data=independent noobs;
var basket n y post_mean lower upper prob_gt_20;
run;
なお、R版の独立解析は bhmbasket の stratified 分析であり、事前分布の置き方がこのJeffreys事前分布とは異なります。そのため、後述するR版の参照値とは近傍の値にはなりますが、厳密には一致しない点に注意してください。
PROC MCMCによるBHMの実装
次にBHM本体です。定式化はR版と同一で、\(\theta_k = \mathrm{logit}(p_k)\) に対して \(\theta_k \sim \mathcal{N}(\mu, \tau^2)\) の階層を置き、事前分布は \(\mu \sim \mathcal{N}(-1, 1^2)\)、\(\tau \sim \mathrm{Half\text{-}Normal}(0, 1)\) とします。
/* ベイズ階層モデル(Berry型):PROC MCMC */
proc mcmc data=basket outpost=post_bhm seed=2024 nmc=20000 nbi=2000
monitor=(pk);
array pk[5];
parms mu -1 tau 1;
prior mu ~ normal(-1, sd=1);
prior tau ~ normal(0, sd=1, lower=0);
random theta ~ normal(mu, sd=tau) subject=basket;
p = logistic(theta);
pk[basket] = p;
model y ~ binomial(n, p);
run;
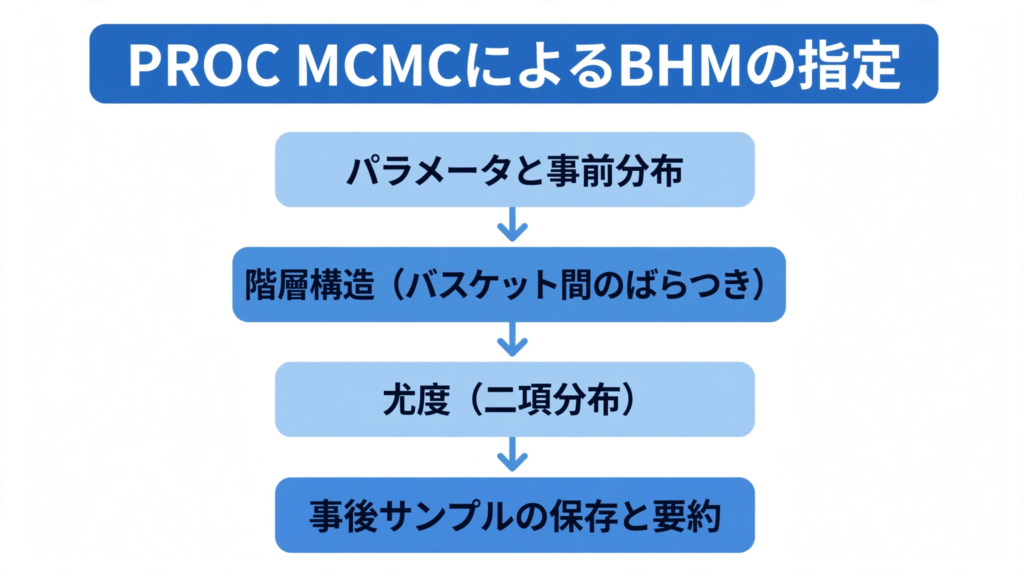
各ステートメントの役割は次のとおりです。
| PROC MCMCの要素 | 役割 |
|---|---|
| parms | パラメータ \(\mu\) と \(\tau\) の宣言と初期値の指定 |
| prior | \(\mu\) と \(\tau\) の事前分布の指定。\(\tau\) は lower=0 の下限付き正規分布として半正規分布を表す |
| random | \(\theta_k\) が \(\mathcal{N}(\mu, \tau^2)\) に従う階層構造を subject=basket で宣言し、バスケットごとに \(\theta\) を生成 |
| model | 尤度 \(y_k \sim \mathrm{Binomial}(n_k, p_k)\) の指定。\(p\) は logistic 関数で \(\theta\) から変換 |
| monitor | 事後サンプルを保存し、要約の対象とする量の指定。ここでは各バスケットの奏効率 \(p_k\) を収めた pk |
出力の読み方はシンプルです。PROC MCMCは既定で、パラメータの事後要約統計量(平均・標準偏差・分位点)と区間統計量(HPD区間)の表を出します。\(\mu\)・\(\tau\)・各バスケットの \(\theta\) に加えて、monitorで指定した pk も表に載るため、各バスケットの奏効率をそのまま読み取ることができます。コード中の pk[basket] = p; が、バスケットごとの \(p\) を配列 pk に格納する処理です。なお、結果を採用する前に、トレースプロットなどの診断出力でMCMCの収束を確認してください。
R版の参照値との対応
下表は、R版で同じデータ・同じモデルを実装して得られた事後平均と95%信用区間です。これはR版で得られた参照値であり、本記事のSASコードの出力ではありません。 SASで上のコードを実行すれば、サンプラーの違いによる誤差の範囲で、これらに近い値が得られる見込みです。
| バスケット(粗奏効率) | 独立解析の事後平均 [95% CrI] | BHMの事後平均 [95% CrI] |
|---|---|---|
| 1(10.0%) | 10.5% [1.6, 26.3] | 12.6% [2.9, 27.9] |
| 2(16.7%) | 16.8% [4.1, 36.1] | 17.6% [5.3, 35.5] |
| 3(4.5%) | 5.2% [0.2, 17.1] | 8.6% [1.3, 21.6] |
| 4(21.1%) | 21.0% [6.6, 40.8] | 20.9% [7.4, 39.4] |
| 5(65.0%) | 62.9% [41.8, 81.6] | 57.3% [35.1, 77.9] |
繰り返しになりますが、この表の数値はすべてR版で得られた参照値であり、SAS版の出力ではありません。とくに独立解析の列は、事前分布の置き方の違いから、コード2をSASで実行した結果と厳密には一致しません。対応づけは「近傍の値が得られているか」の確認にとどめてください。
参照値でBHMの動きを追うと、借用と縮約の特徴がよく分かります。
- バスケット5は62.9%から57.3%へ、全体平均(約23%)の方向に引き戻されました(縮約)。一方で信用区間の幅は約40ポイントから約43ポイントへむしろ広がっており、借用が常に区間を狭めるわけではありません。
- バスケット3は5.2%から8.6%へ引き上げられました。粗奏効率が極端に低いバスケットほど、他のバスケットからの借用の影響を受けやすくなります。
- バスケット4は21.0%から20.9%とほぼ動かず、区間だけがやや狭まりました。全体平均に近いバスケットでは、縮約の方向が定まらず推定値が安定します。
判定と感度分析をSASで行う
BHMを回しただけでは、試験の意思決定には使えません。各バスケットについて「奏効率が目標値を上回っているか」を事後確率で評価し、あらかじめ定めた基準を超えたバスケットを有効と判定するのが、ベイズ流の枠組みでした。ここでは、その判定確率の算出と、結果の頑健さを確かめる感度分析をSASで行います。
判定確率の算出
判定基準は次の形です。本記事の例では \(p_{\text{target}}=0.20\)、\(\delta=0.80\) を想定します。
\[\Pr(p_k > p_{\text{target}} \mid \text{data}) \ge \delta \]
この確率は、コード3の outpost(事後サンプル)に保存された \(p_k\) のサンプルのうち、0.20を超えたものの割合として計算できます。指示変数を作り、PROC MEANSで平均を取るだけです。
/* 判定:奏効率が目標値0.20を超える事後確率 */
data post_prob;
set post_bhm;
array pk[5];
array gt[5];
do k = 1 to 5;
gt[k] = (pk[k] > 0.20);
end;
run;

proc means data=post_prob mean maxdec=3;
var gt1-gt5;
run;
gt1〜gt5の平均が、そのまま各バスケットの \(\Pr(p_k > 0.20)\) になります。重要なのは、\(\delta\) のような判定基準は結果を見てから決めるものではなく、プロトコルで事前に規定しておく点です。基準を後付けにすると、判定全体の誤り率をコントロールできなくなります。
\(\tau\) の事前分布を変えた感度分析
借用の強さは、階層のばらつき \(\tau\) の事前分布に大きく左右されます。基本設定は半正規分布 \(\mathrm{Half\text{-}Normal}(0, 1)\) でした。感度分析では、prior 文の sd を0.5(狭い=強い縮約)と2(広い=弱い縮約)に変えて、同じモデルを回し直します。
/* 感度分析1:tauの事前分布を狭くする(強い縮約) */
proc mcmc data=basket outpost=post_strong seed=2024 nmc=20000 nbi=2000
monitor=(pk);
array pk[5];
parms mu -1 tau 0.5;
prior mu ~ normal(-1, sd=1);
prior tau ~ normal(0, sd=0.5, lower=0);
random theta ~ normal(mu, sd=tau) subject=basket;
p = logistic(theta);
pk[basket] = p;
model y ~ binomial(n, p);
run;

/* 感度分析2:tauの事前分布を広くする(弱い縮約) */
proc mcmc data=basket outpost=post_weak seed=2024 nmc=20000 nbi=2000
monitor=(pk);
array pk[5];
parms mu -1 tau 1;
prior mu ~ normal(-1, sd=1);
prior tau ~ normal(0, sd=2, lower=0);
random theta ~ normal(mu, sd=tau) subject=basket;
p = logistic(theta);
pk[basket] = p;
model y ~ binomial(n, p);
run;

/* バスケット5の奏効率とtauの事後平均・中央値を取り出す */
proc means data=post_strong mean median maxdec=3;
var pk5 tau;
run;

proc means data=post_weak mean median maxdec=3;
var pk5 tau;
run;
最後のPROC MEANSで、バスケット5の奏効率と \(\tau\) の事後平均・中央値を設定ごとに取り出します。
ここで注意点が1つあります。下の表の数値は、R版の感度分析(rstanarm)で得られた参照値です。R版では \(\tau\) の事前分布に decov(指数分布型)を使い、そのscaleを変えていました。SAS版の半正規のスケール変更とは事前分布そのものが異なるため、対応するのは縮約の強弱の方向だけで、数値が厳密に対応するわけではありません。
| \(\tau\) の事前分布(R版) | バスケット5の事後平均 [95% CrI] | \(\tau\) の事後中央値 | 縮約の強さ |
|---|---|---|---|
| decov(scale=0.5) | 55.8% [32.5, 77.3] | 1.04 | 強い |
| Half-Normal(0, 1)(基本設定) | 57.3% [35.1, 77.9] | 1.17 | 中程度 |
| decov(scale=2.0) | 59.2% [36.9, 79.2] | 1.41 | 弱い |
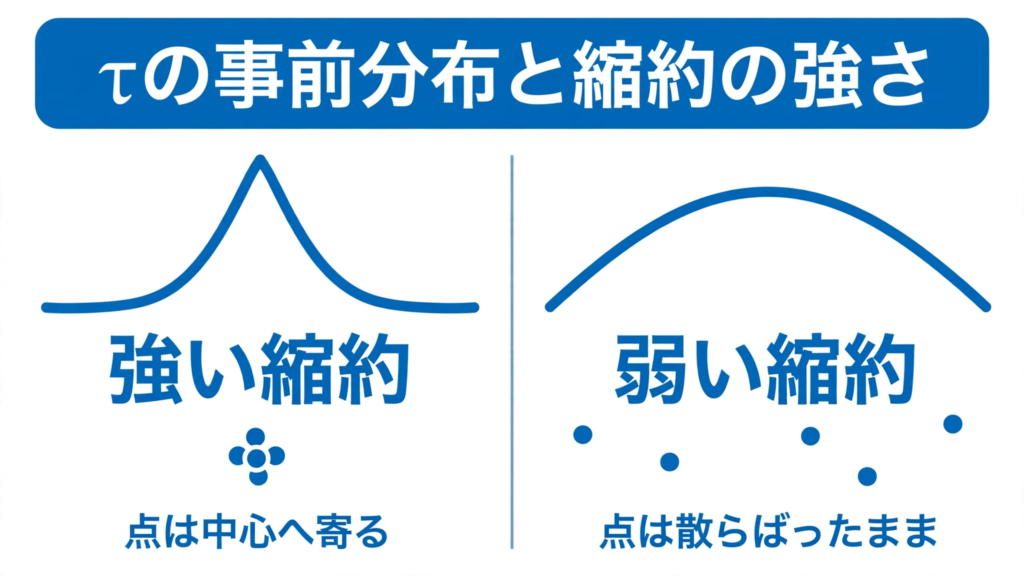
- 事前分布の置き方だけで、バスケット5の事後平均は55.8%から59.2%まで、約3ポイント動きます。
- 強い縮約は、効いているバスケットの推定を全体平均の側へ引っ張り、効果を薄めてしまうリスクがあります。
- 弱い縮約は、偶然高く出たバスケットをそのまま過大評価してしまうリスクがあります。
- どちらのリスクをどれだけ許容するかは統計だけでは決まらないため、感度分析の結果を並べたうえで、臨床側と事前に合意しておくことが大切です。
実務でのポイント
最後に、BHMを実際の試験で使うときの要点を、R版の内容をもとにSAS実務の観点でまとめます。
まず、\(\tau\) の事前分布と判定基準 \(\delta\) は、プロトコルとSAP(統計解析計画書)で事前に規定しておきます。感度分析で見たとおり、この2つは結果に直接響きます。解析の段階で調整できてしまうと「都合のよい借用」に見えかねず、規制当局との議論でも弱点になります。
次に、運用特性の評価です。BHMには頻度論的な検出力や有意水準に相当するものが直接はありません。その代わり、「本当に効いているバスケットを有効と判定できる確率」や「効いていないバスケットを誤って有効としてしまう確率」を、想定シナリオのもとでシミュレーションにより評価します。判定しきい値 \(\delta\) は、このシミュレーション結果から逆算して決めるのが実務的です。SASでも、シナリオごとのデータ生成とPROC MCMCの反復実行を組み合わせれば、同じ評価ができます。
借用の強さが諸刃の剣であることも、常に意識が必要です。情報を借りれば各バスケットの推定は安定しますが、効いていないバスケットに効いているバスケットの情報が流れ込めば誤判定につながり、逆に借用が弱すぎればBHMを使う意味が薄れます。
規制当局との対話も欠かせません。バスケット試験を含む複雑な革新的デザインについては、FDAがCID(Complex Innovative Trial Design)パイロットプログラムを用意し、デザイン段階から相談できる枠組みがあります。国内でもPMDAとの早期相談を通じて、借用の前提や判定基準を合意しておくことが重要です。適応的デザインを扱うICH E20でも、シミュレーションによる運用特性の評価と、解析方針の事前規定が議論の中心になっています。
- SASでのBHMはPROC MCMCで実装でき、判定確率は事後サンプルの加工で算出できます。
- 結果は \(\tau\) の事前分布に敏感です。感度分析は必須であり、設定と判定基準はプロトコル/SAPに事前規定します。
- 誤判定のリスクはシミュレーションで評価し、規制当局とは早期に合意しておきます。
📚 この記事をより深く理解するための参考書籍
BHMを「試験デザイン全体の中でどう位置づけるか」まで含めて学ぶための3冊を選びました。デザインと統計解析の土台になる国内のハンドブックと、SASによる実装を扱う専門書2冊です。



生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
- ベイズ階層モデルでバスケット試験を解く|BHMの借用と縮約をRで実装
- がん臨床試験におけるベイズ流バスケットデザインの理論と実装 ― 階層ベイズモデル・EXNEXモデル・モデル平均化の応用 ―
- マスタープロトコル試験とは|バスケット・アンブレラの違い
まとめ
本記事では、バスケット試験のベイズ階層モデル(BHM)を、SASのPROC MCMCで実装する手順を整理しました。
モデルの指定は、parmsとpriorでパラメータと事前分布を宣言し、random文で \(\theta_k \sim \mathcal{N}(\mu, \tau^2)\) の階層を subject=basket で表し、model文で二項分布の尤度につなぐ、という流れです。\(\tau\) への半正規事前分布は、lower=0 の下限付き正規分布として書けます。判定に使う \(\Pr(p_k > 0.20)\) は、outpostに保存した事後サンプルを加工すれば算出できます。独立解析は、共役なベータ事後分布で正確に計算できる点もSASならではの書き分けです。
結果を読むうえで大切なのは、縮約の強さが \(\tau\) の事前分布に敏感だという点です。R版の参照値でも、事前分布の置き方だけでバスケット5の事後平均は約3ポイント動きました。基本設定の結果だけで結論を出さず、感度分析を並べて示し、設定と判定基準をプロトコルとSAPに事前規定しておくことが、規制当局との議論にも耐える進め方です。
Rで概念をつかみ、SASで実務に落とす。本記事がその橋渡しになれば幸いです。概念面をもう一度確認したい方はR版を、EXNEXを含む発展形に進みたい方は関連記事のベイズ流バスケットデザインの記事をあわせてご覧ください。