統計検定準1級「統計的因果推論」攻略 ― 潜在的結果・傾向スコア・操作変数法の典型出題対策 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
統計検定準1級の対策として、2027年の出題範囲改訂で新しく加わる「統計的因果推論」を取り上げます。
例題は、筆者(生物統計家)が本番で出そうなものを選定しました。
数値はすべてRで検算したうえで掲載しています。
この記事でわかること
- 潜在的結果の枠組みで、平均因果効果(ATE)と選択バイアスを分けて計算する方法
- ランダム化がある場合とない場合で、群間差の意味がどう変わるか
- 交絡を標準化と傾向スコア(IPTW)で調整する計算手順
- 操作変数法のWald推定量と、オッズ比の非収縮性という落とし穴
本記事は、統計検定準1級の攻略シリーズの1本です。
因果推論は、相関と因果を分けるための理論です。
「処置を受けた群の方が回復した」という観察だけでは、処置の効果とは言い切れません。
受けた人と受けなかった人の顔ぶれが違うためです。
本記事では、この「顔ぶれの違い」を数値でほぐしながら、効果を取り出す方法を例題7問で整理します。
各例題にはRのコードと出力を併記し、手計算の答え合わせまで1記事で完結します。
はじめに ― 準1級における「統計的因果推論」の位置づけ
統計検定準1級は、統計学の実務的な運用能力を測る試験です。
試験方式はCBT(コンピュータを使った受験)で、試験時間は90分、出題数はおおむね20〜30問、100点満点で60点以上が合格ラインとされています(最新の正確な情報は公式サイトでご確認ください)。
試験中は四則演算・百分率・平方根ができる普通電卓のみが使えます(関数電卓は不可)。
「統計的因果推論」は、2027年1月1日の出題範囲改訂で準1級に加わる新分野です。
公式ワークブックの増補版(2026年)には、因果推論の章が追加されました。
今のうちに土台を作っておくと、改訂直後の試験で差がつきます。
当サイトには製薬実務向けの因果推論の連載もあります。
ただし本記事は試験対策に絞り、潜在的結果の枠組みから計算問題として解ける形に整理しました。
範囲は次のとおりです。
- 含める範囲:潜在的結果とATE、ランダム化と識別、交絡と標準化、傾向スコアとIPTW、操作変数法、効果の尺度
- 対象外:do演算とバックドア条件の本格展開(既存記事で扱いました)、g法などの発展手法、製薬実務の事例
詰まった箇所だけ途中式と照らし合わせてください。
Rのコードは答え合わせ専用です。
潜在的結果の枠組み ― ATEと因果推論の根本問題
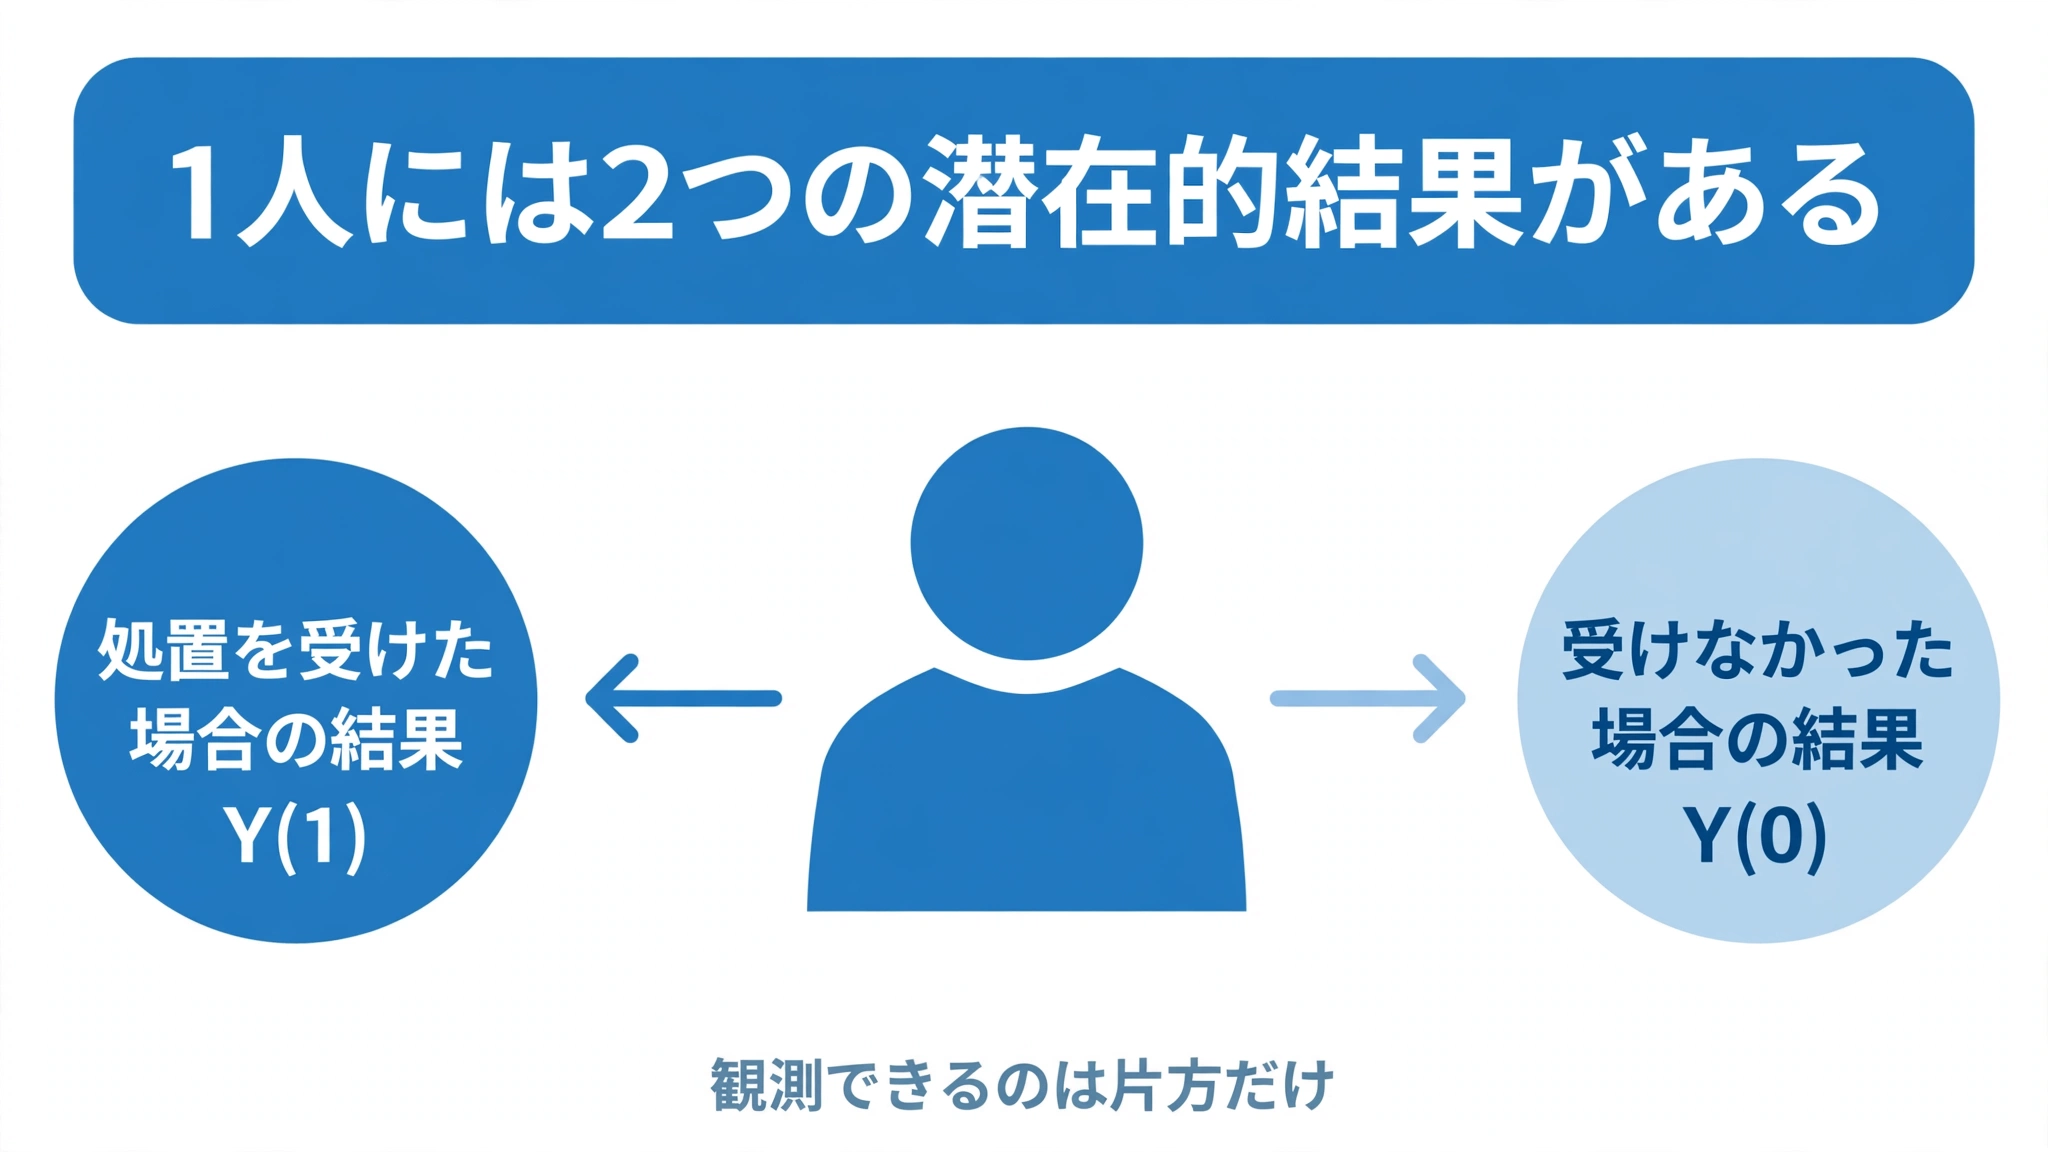
処置の効果を考えるとき、同じ人について「処置を受けた場合の結果」と「受けなかった場合の結果」を比べるのが出発点です。
この2つを潜在的結果と呼びます。
ただし現実には、1人について片方しか観測できません。
この「もう片方が原理的に見えない」ことが、因果推論の根本問題です。
例題1 潜在的結果からATEと選択バイアスを求める
問題 8人について、処置を受けた場合の結果 \(Y(1)\)、受けなかった場合の結果 \(Y(0)\)、実際の処置 \(A\)、観測された結果 \(Y\) が次の表のとおりだったとします。
本来は \(Y(1)\) と \(Y(0)\) の片方しか観測できませんが、ここでは両方見えるものとして考えます。
| 人 | \(Y(1)\) | \(Y(0)\) | \(A\) | \(Y\) |
|---|---|---|---|---|
| 1 | 10 | 6 | 1 | 10 |
| 2 | 9 | 5 | 1 | 9 |
| 3 | 12 | 8 | 1 | 12 |
| 4 | 7 | 4 | 0 | 4 |
| 5 | 8 | 3 | 0 | 3 |
| 6 | 11 | 7 | 0 | 7 |
| 7 | 6 | 2 | 1 | 6 |
| 8 | 13 | 9 | 0 | 9 |
(1) 平均因果効果 \(ATE=E[Y(1)-Y(0)]\) を求めてください。
(2) 観測データだけから計算できる素朴な群間差(処置群の平均 − 対照群の平均)を求めてください。
(3) 両者の差(選択バイアス)を、処置群と対照群の \(Y(0)\) の平均の差として表し、数値を求めてください。
解答
(1) 使う考え方は、潜在的結果の平均の差です。
ATEは個別効果 \(Y(1)-Y(0)\) の平均で定義されます。
個別効果は順に 4, 4, 4, 3, 5, 4, 4, 4 です。
合計は32なので、\(ATE=32/8=4.0\) となります。
(2) 素朴な群間差は、観測された \(Y\) だけで計算します。
処置群の平均は \((10+9+12+6)/4=9.25\) です。
対照群の平均は \((4+3+7+9)/4=5.75\) です。
よって素朴な差は \(9.25-5.75=3.5\) です。
(3) 選択バイアスは、処置を受けなかった場合の結果 \(Y(0)\) の群間差です。
\[E[Y(0)\mid A=1]-E[Y(0)\mid A=0]=5.25-5.75=-0.5\]
処置群は、処置なしでも結果が低めに出る集団だったことが分かります。
検算 処置群での平均効果(ATT)も4.0です。
素朴な差3.5は「ATT 4.0 + 選択バイアス (−0.5)」と分解でき、一致します。
Rで答え合わせをします。
# 例題1:潜在的結果と選択バイアス
y1 <- c(10, 9, 12, 7, 8, 11, 6, 13)
y0 <- c(6, 5, 8, 4, 3, 7, 2, 9)
a  <- c(1, 1, 1, 0, 0, 0, 1, 0)
y  <- ifelse(a == 1, y1, y0)
c(ATE = mean(y1 - y0),
  naive = mean(y[a == 1]) - mean(y[a == 0]),
  bias = mean(y0[a == 1]) - mean(y0[a == 0]))
  ATE naive  bias
  4.0   3.5  -0.5
ATEは4.0なのに、観測データの群間差は3.5しかありません。
差の −0.5 は、処置群と対照群の「もともとの違い」です。
本番では、群間差 = 因果効果 + 選択バイアス、という分解を書けるかが問われます。
ランダム化が支える比較 ― RCTで因果効果を読む
処置の割り付けをくじ引きで決めるのがランダム化です。
ランダム化により、割り付けは潜在的結果と無関係になります。
そのため、群間差がそのまま因果効果の推定になります。
例題2 ランダム化比較試験のリスク差と信頼区間を求める
問題 ある治療のランダム化比較試験で、処置群100人のうち60人が回復し、対照群100人のうち45人が回復しました。
(1) リスク差で因果効果を推定してください。
(2) 標準誤差と95%信頼区間を求めてください。
(3) ランダム化のもとで、この素朴な群間差がATEの推定量になる理由を述べてください。
解答
(1) 効果の尺度は、回復割合の差であるリスク差を使います。
リスク差は \(0.60-0.45=0.15\) です。
(2) 標準誤差は、2群の分散の和の平方根です。
\[\sqrt{0.6\times0.4/100+0.45\times0.55/100}=\sqrt{0.004875}=0.0698\]
95%信頼区間は \(0.15\pm1.96\times0.0698\) で、\((0.0132,\ 0.2868)\) です。
(3) ランダム化では、割り付けが潜在的結果と独立になります(交換可能性)。
したがって処置群と対照群に「もともとの違い」は生じず、選択バイアスは0です。
群間差はATEの推定量になります。
検算 信頼区間の下限0.0132が0を上回っています。
5%水準で有意な差があることと対応します。
Rで答え合わせをします。
# 例題2:ランダム化比較試験のリスク差
p1 <- 0.60; p0 <- 0.45; n1 <- 100; n0 <- 100
rd <- p1 - p0
se <- sqrt(p1 * (1 - p1) / n1 + p0 * (1 - p0) / n0)
round(c(RD = rd, SE = se, lower = rd - 1.96 * se, upper = rd + 1.96 * se), 4)
    RD     SE  lower  upper
0.1500 0.0698 0.0132 0.2868
リスク差は0.15、95%信頼区間は (0.0132, 0.2868) です。
ランダム化が効いているからこそ、例題1で見たバイアスの補正なしに因果効果と読めます。
製薬の臨床試験がランダム化を原則とする理由も、ここにあります。
ランダム化が保証するのは「平均として」偏りがないことです。
実際の試験では、割付後の脱落や欠測で交換可能性が崩れることがあります。
交絡と標準化 ― シンプソンのパラドックスを解く
観察研究では、処置を受けるかどうかが本人の状態に左右されます。
そのため群の間には、もともとの構成の違い(交絡)が生まれます。
粗い比較では効果の向きさえ逆に見えることがあり、これがシンプソンのパラドックスです。
例題3 年齢で層別すると符号が逆転する
問題 ある観察研究で、年齢層別の回復者数は次の表のとおりでした。
| 年齢層 | 処置群(回復者数/人数) | 対照群(回復者数/人数) |
|---|---|---|
| 若年層 | 80/100 | 210/300 |
| 高齢層 | 90/300 | 20/100 |
| 全体 | 170/400 | 230/400 |
(1) 層別のリスク差を求めてください。
(2) 年齢を無視した粗のリスク差を求めてください。
(3) 全体の年齢構成(若年・高齢が半々)で標準化したリスク差を求め、(2) と符号が逆転する理由を述べてください。
解答
(1) 層別の回復率を計算します。
- 若年層:処置 \(0.80\)、対照 \(0.70\)
- 高齢層:処置 \(0.30\)、対照 \(0.20\)
(2) 粗の回復率は、処置群が \((80+90)/400=0.425\)、対照群が \((210+20)/400=0.575\) です。
\[\text{粗のリスク差}=0.425-0.575=-0.15\]
(3) 標準化では、両群の回復率を同じ年齢構成(半々)で加重平均します。
\[\text{処置}=0.5\times0.8+0.5\times0.3=0.55,\quad \text{対照}=0.5\times0.7+0.5\times0.2=0.45\]
標準化したリスク差は \(0.55-0.45=+0.10\) です。
逆転の理由は年齢構成の偏りです。
回復しにくい高齢層が処置群に多く、回復しやすい若年層が対照群に多く含まれていました。
検算 標準化したリスク差 \(+0.10\) は、層別リスク差 \(+0.10\) と一致します。
Rで答え合わせをします。
# 例題3:交絡と標準化(シンプソンのパラドックス)
crude_t <- (80 + 90) / 400
crude_c <- (210 + 20) / 400
std_t <- 0.5 * 0.80 + 0.5 * 0.30
std_c <- 0.5 * 0.70 + 0.5 * 0.20
round(c(crude_diff = crude_t - crude_c, std_diff = std_t - std_c), 4)
crude_diff   std_diff
     -0.15       0.10
答えは、粗のリスク差が \(-0.15\)、標準化したリスク差が \(+0.10\) です。
層別では両層とも処置が有利なのに、全体では逆に見えるのがシンプソンのパラドックスです。
本番では、粗の値と層別の値が食い違ったら、まず層の構成比を比べることが手順になります。
傾向スコアとIPTW ― 観察データのバランスを取り直す
標準化は層が少ないときに有効ですが、交絡因子が増えると層が細かくなりすぎます。
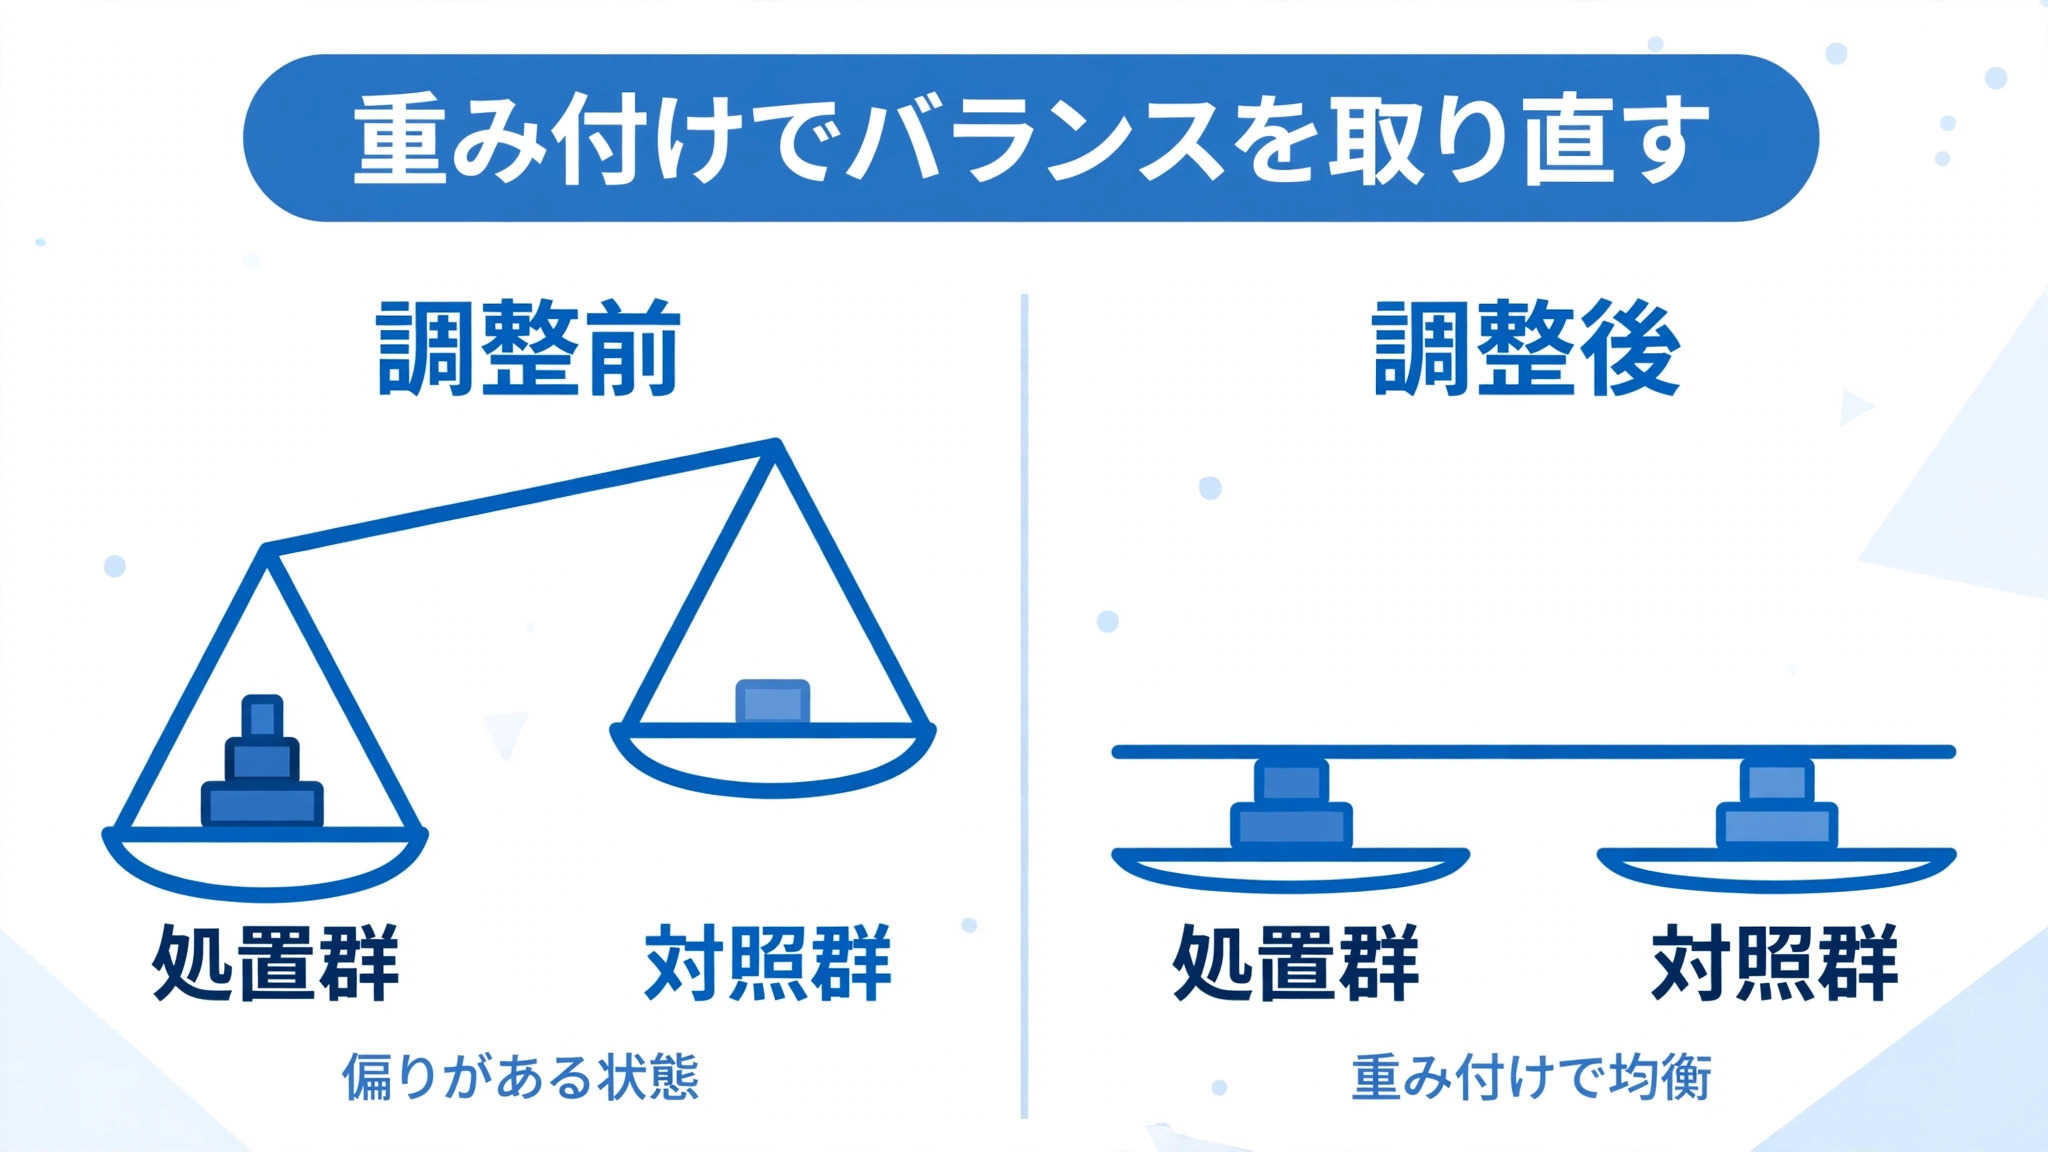
そこで、交絡因子を傾向スコアという1つの数値に圧縮し、逆確率の重みでバランスを取り直すのがIPTWです。
例題4と例題5は、同じ観察研究の続きとして解きます。
例題4 傾向スコアで疑似集団の大きさを求める
問題 重症度(軽症・重症)だけが交絡因子である観察研究を考えます。
傾向スコアは軽症で \(e=0.2\)、重症で \(e=0.8\) でした。
実際の人数は、軽症で処置20人・対照80人、重症で処置80人・対照20人(合計200人)でした。
(1) 処置群と対照群で重症の割合を比べてください。
(2) 逆確率重みで重み付けしたとき、処置側・対照側の疑似集団の大きさ(重みの合計)を求めてください。
解答
(1) 重症の割合は、処置群で \(80/100=0.8\)、対照群で \(20/100=0.2\) です。
処置群に重症が大きく偏っています。
(2) 処置側の重みは \(A/e\) です。
軽症の処置者は \(1/0.2\) 倍、重症の処置者は \(1/0.8\) 倍に重み付けます。
\[\text{処置側の重みの合計}=20/0.2+80/0.8=100+100=200\]
対照側の重みは \((1-A)/(1-e)\) です。
\[\text{対照側の重みの合計}=80/0.8+20/0.2=100+100=200\]
検算 両側とも、元の集団の大きさ200と一致します。
Rで答え合わせをします。
# 例題4:傾向スコアと重み(疑似集団の大きさ)
pseudo_t <- 20 / 0.2 + 80 / 0.8
pseudo_c <- 80 / 0.8 + 20 / 0.2
c(pseudo_treated = pseudo_t, pseudo_control = pseudo_c)
pseudo_treated pseudo_control
           200            200
疑似集団が両側とも200になるのは、偶然ではありません。
重み付けによって、各群が「全員がその処置を受けた場合」の集団を模擬できているからです。
本番では、重みの合計が元の人数と一致するかどうかを検算に使えます。
例題5 IPTWでATEを推定する
問題 例題4の研究で、回復者数は軽症で処置12人・対照40人、重症で処置24人・対照4人でした。
(1) IPTWで \(E[Y(1)]\)、\(E[Y(0)]\) とATEを推定してください。
(2) 粗のリスク差と比べてください。
解答
(1) \(E[Y(1)]\) は、処置を受けた回復者を重み付きで数え、疑似集団の大きさ200で割ります。
\[E[Y(1)]\text{の推定}=(12/0.2+24/0.8)/200=(60+30)/200=0.45\]
\(E[Y(0)]\) も同様に、対照の回復者を重み付きで数えます。
\[E[Y(0)]\text{の推定}=(40/0.8+4/0.2)/200=(50+20)/200=0.35\]
ATEの推定は \(0.45-0.35=+0.10\) です。
(2) 粗のリスク差は、処置群が \(36/100=0.36\)、対照群が \(44/100=0.44\) で \(-0.08\) です。
検算 層別のリスク差は、軽症で \(0.60-0.50=+0.10\)、重症で \(0.30-0.20=+0.10\) です。
IPTWの推定 \(+0.10\) と一致し、交絡が取り除けていることが確認できます。
Rで答え合わせをします。
# 例題5:IPTWによるATE推定
ey1 <- (12 / 0.2 + 24 / 0.8) / 200
ey0 <- (40 / 0.8 + 4 / 0.2) / 200
crude5 <- 36 / 100 - 44 / 100
round(c(EY1 = ey1, EY0 = ey0, IPTW = ey1 - ey0, crude = crude5), 4)
  EY1   EY0  IPTW crude
 0.45  0.35  0.10 -0.08
粗のリスク差 \(-0.08\) が、IPTWでは \(+0.10\) になり、符号が入れ替わりました。
実務の観察研究やリアルワールドデータでも、粗い比較の符号をそのまま信じないことが出発点になります。
傾向スコアが0や1に近い人がいると、その人の重みが極端に大きくなります。
推定が少数の人に引っ張られて不安定になるため、重みの分布の確認が前提です。
操作変数法 ― 割り付けを道具にする
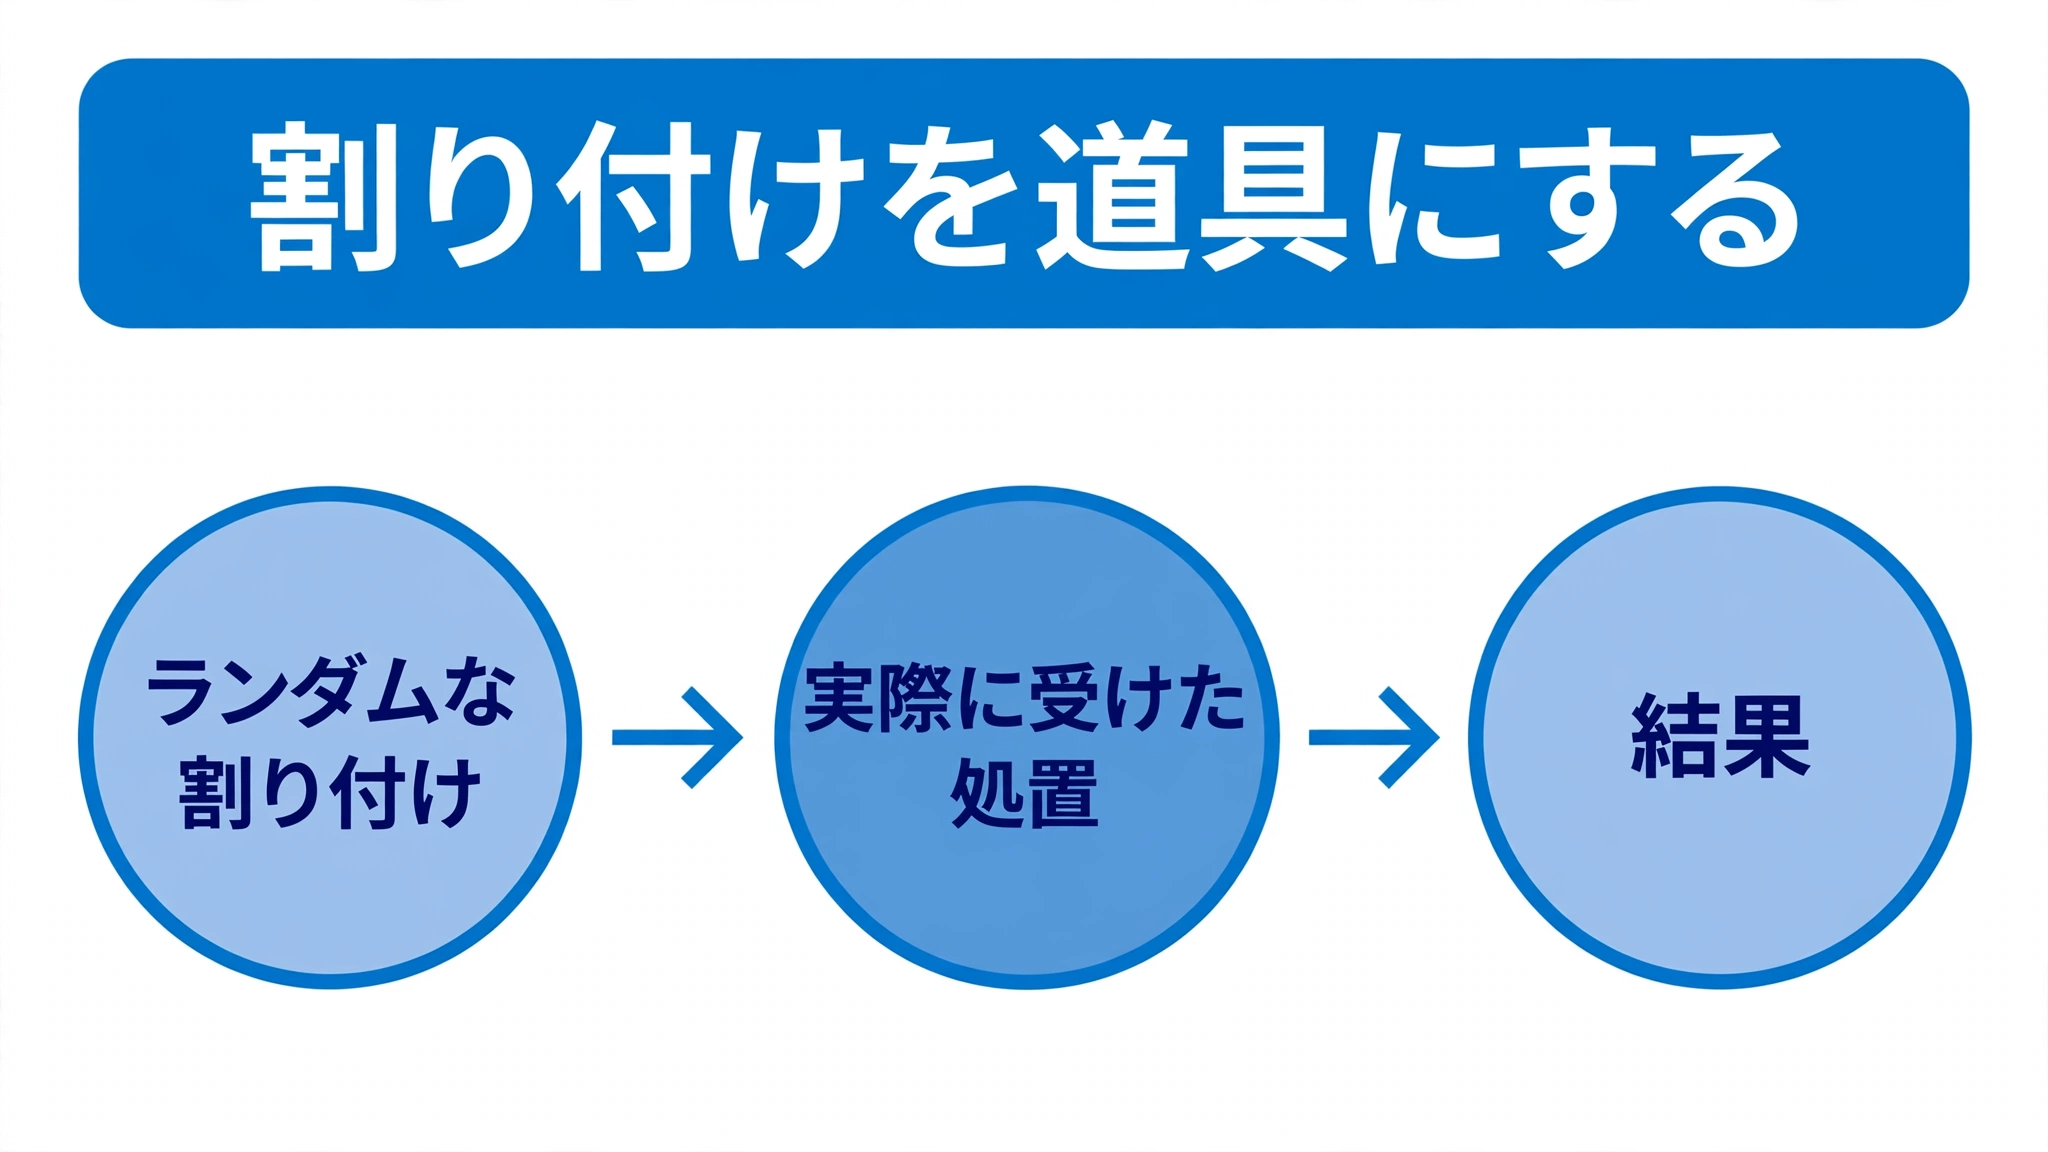
割り付けどおりに処置を受けない人がいると、ITT(割り付けの効果)は処置そのものの効果より小さく出ます。
操作変数法は、ランダムな割り付けを「道具(操作変数)」として使います。割り付けの効果を、実際に処置を受けた割合の差で割り戻すのが基本の発想です。
例題6 操作変数法で処置そのものの効果に換算する
問題 ランダム化比較試験で、割り付けへのノンコンプライアンスがありました。設定は次のとおりです。
| 群 | 人数 | 実際に処置を受けた割合 | 回復率 |
|---|---|---|---|
| 処置割付群 | 200人 | 0.70 | 0.52 |
| 対照割付群 | 200人 | 0.10 | 0.40 |
(1) 割り付けに基づく効果(ITT)を求めてください。
(2) Wald推定量で、実際に処置を受けたことの効果を推定してください。
解答
使うのは、ITTを実施率の差で割り戻すWald推定量です。
(1) ITTは、割り付け群同士の回復率の差です。
\[ITT=0.52-0.40=0.12\]
(2) 実際に処置を受けた割合の差は \(0.70-0.10=0.60\) です。
割り戻すと、処置そのものの効果が得られます。
\[\text{Wald推定量}=\frac{0.12}{0.60}=0.20\]
検算 \(0.20\times0.60=0.12\) で、ITTと一致します。
Rで答え合わせをします。
# 例題6:操作変数法(Wald推定量)
itt <- 0.52 - 0.40
compliance <- 0.70 - 0.10
round(c(ITT = itt, compliance = compliance, Wald = itt / compliance), 4)
       ITT compliance       Wald
      0.12       0.60       0.20
ITTの0.12は「割り付けの効果」です。Wald推定量の0.20は、割り付けに従うかどうかで処置が決まる人(コンプライヤー)における局所平均因果効果(LATE)です。
臨床試験で服薬遵守が不完全なとき、ITTだけを見ると処置の効き目を薄めて読んでしまいます。その橋渡しがこの換算です。
Wald推定量には3つの前提があります。
- 関連性:割り付けが、実際に処置を受ける割合に影響すること
- 除外制約:割り付けは、処置を通してのみ結果に影響すること
- 単調性:割り付けに逆らって行動する人がいないこと
効果の測り方 ― オッズ比の非収縮性
効果の尺度には、リスク差・リスク比・オッズ比があります。このうちオッズ比だけは、層をまとめると値が変わる性質(非収縮性)を持ちます。
交絡がなくても起こる点が、試験で問われやすいところです。
例題7 層別オッズ比と周辺オッズ比を比べる
問題 交絡のない集団を、軽症・重症の2層に分けました。各層とも、処置群・対照群は各100人です。回復率は次のとおりでした。
| 層 | 処置群の回復率 | 対照群の回復率 |
|---|---|---|
| 軽症 | 0.90 | 0.80 |
| 重症 | 0.36 | 0.20 |
(1) 層別のオッズ比を求めてください。
(2) 層をまとめた周辺オッズ比を求め、(1) と比べてください。
(3) 一致しない理由は交絡かどうか、述べてください。
解答
(1) オッズは「回復率 ÷(1 − 回復率)」です。オッズ比は、処置群と対照群のオッズの比です。
軽症層は \((0.9/0.1)/(0.8/0.2)=9/4=2.25\) です。
重症層は \((0.36/0.64)/(0.20/0.80)=0.5625/0.25=2.25\) です。
(2) 周辺の回復率は、処置群が \((90+36)/200=0.63\)、対照群が \(0.50\) です。
\[\text{周辺オッズ比}=\frac{0.63/0.37}{0.5/0.5}=1.7027\]
層別値2.25と一致しません。
(3) の答えは「交絡ではない」です。各層で両群100人ずつであり、処置と重症度に関連はありません。
検算 リスク差で見ると、層別は軽症 \(0.10\)・重症 \(0.16\) です。周辺は \(0.63-0.50=0.13\) で、その中間に収まります。オッズ比のような食い違いは起きていません。
Rで答え合わせをします。
# 例題7:オッズ比の非収縮性
or_light <- (0.90 / 0.10) / (0.80 / 0.20)
or_heavy <- (0.36 / 0.64) / (0.20 / 0.80)
pt7 <- (90 + 36) / 200
or_marginal <- (pt7 / (1 - pt7)) / (0.5 / 0.5)
round(c(OR_light = or_light, OR_heavy = or_heavy,
        OR_marginal = or_marginal), 4)
   OR_light    OR_heavy OR_marginal
     2.2500      2.2500      1.7027
層別オッズ比はどちらも2.25です。それなのに周辺では1.7027まで下がります。
不一致の正体は交絡ではなく、オッズ比の非収縮性そのものです。リスク差・リスク比では起こりません。実務では、ロジスティック回帰の調整オッズ比と粗オッズ比の差を、そのまま交絡の大きさと読まないことが大切です。
受験対策・実務でのポイント
例題1〜7を通して問われたのは、「どの比較が、どの仮定のもとで因果効果になるか」でした。最後に整理します。
- 素朴な群間差は選択バイアスを含む:観察データの差は、そのままでは因果効果ではない(例題1)
- ランダム化が識別の土台:割り付けが潜在的結果と独立になるため、群間差がATEの推定になる(例題2)
- 調整の発想は共通:層別・標準化も傾向スコアも、「背景をそろえてから比べる」点は同じ(例題3〜5)
- IPTWの重みは疑似集団を作る:処置確率の逆数で重み付けし、両群に全体集団を模擬させる(例題4・5)
- 操作変数は換算の道具:ITTを実施率の差で割り、処置の効果(LATE)に直す(例題6)
- オッズ比は周辺化で保たれない:層別と周辺の差は、交絡とは限らない(例題7)
本番での手順は3つです。(1) まず「反事実と比べられているか」を確認する。(2) ランダム化か、調整か、操作変数か、識別の道具を見分ける。(3) 尺度(リスク差・リスク比・オッズ比)で結論が変わらないか点検する。
この3手順で、因果推論の計算問題はほぼ処理できます。
📚 この記事をより深く理解するための参考書籍
『統計検定準1級対応 統計学実践ワークブック』日本統計学会 編(学術図書出版社)

『日本統計学会公式認定 統計検定 準1級 公式問題集』日本統計学会 編(実務教育出版、2021年)

『調査観察データの統計科学 ― 因果推論・選択バイアス・データ融合』星野崇宏(岩波書店)

生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
- 統計検定準1級「統計的推定」攻略 ― 最尤法・十分統計量・フィッシャー情報量・クラメール–ラオの不等式の典型出題対策 ―
- 逆確率重み付け(IPTW)によるATE推定 ― 傾向スコア分析の実践的応用とR・SAS実装 ―
- 因果推論の”識別”を数学的に理解する:do演算・操作変数・バックドア条件
- 統計検定準1級 攻略ガイド ― 出題範囲・勉強法・おすすめ参考書を生物統計家が徹底解説 ―
まとめ
本記事では、統計検定準1級の新分野「統計的因果推論」を、例題7問で整理しました。
潜在的結果の枠組みでは、真のATE \(4.0\) に対して素朴な群間差が \(3.5\) にずれることを確認しました。
ずれの正体は、選択バイアス \(-0.5\) です。
ランダム化がある試験では、リスク差 \(0.15\)(95%信頼区間 \(0.0132\)〜\(0.2868\))がそのまま因果効果の推定になります。
観察データでは調整が必要です。
年齢の交絡がある例では、粗のリスク差 \(-0.15\) が標準化で \(+0.10\) に反転しました。
傾向スコアを使うIPTWでも、粗の \(-0.08\) から \(+0.10\) が取り出せました。
割り付けにノンコンプライアンスがある場合は操作変数法を使います。
ITT \(0.12\) を受けた割合の差 \(0.60\) で割ると、Wald推定量 \(0.20\) が得られました。
最後に、オッズ比には非収縮性があります。
層別オッズ比 \(2.25\) と周辺オッズ比 \(1.7027\) の不一致は、交絡ではなく尺度そのものの性質です。
本番で大切なのは、計算の前に「いま比べている2群は、もともと比較可能か」を問うことです。
この問いは、観察研究やリアルワールドデータで効果を推定する実務でも、最初の判断になります。
定着させるコツは、数日置いてから例題を解き直すことです。
とくに例題3と例題5は、同じ「交絡の調整」を標準化とIPTWで解き直す形になっています。
両方を再現できれば、調整の発想は身についたと言えます。
次の一歩としては、推定の土台を固める統計検定準1級「統計的推定」攻略と、IPTWの実装を扱う逆確率重み付け(IPTW)によるATE推定をあわせてご覧ください。