一元配置分散分析(ANOVA)とは ― F検定の仕組み・前提条件・多重比較までをRとSASでわかりやすく解説 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- 分散分析(ANOVA)とは何か、どんなときに使うのか
- t検定を繰り返してはいけない理由(誤り率をシミュレーションで実測)
- F統計量の仕組みと平方和の分解(手計算で再現)
- 前提条件の確認方法と、Welchの分散分析・Kruskal-Wallis検定の使い分け
- 有意だったあとの多重比較(Tukey)と、SAS(PROC GLM)での実装
はじめに
3つのクラスのテストの平均点に差があるか、3種類の肥料で収穫量が違うか。このように「3つ以上のグループの平均値を比べたい」場面は、日常にも仕事にもよくあります。医療・製薬では、プラセボ・低用量・高用量の3群で効果を比べる場面が典型です。
2群ならt検定を使いますが、3群以上ではどうすればよいのでしょうか。その答えが分散分析です。この記事は、統計を学び始めた社会人・大学生、製薬企業で働く非統計職の方、若手の生物統計担当者、統計検定2級〜準1級を目指す方に向けて、仕組みからRでの実践までをやさしく解説します。Rを触ったことがない方はR入門を、2群の比較を復習したい方はt検定の数理的導出とRによる実装例をあわせてご覧ください。
分散分析とは ― 3群以上の平均値をまとめて比べる方法
一元配置分散分析(one-way ANOVA)は、1つの要因(例:投与群)で分けた3つ以上の群の平均値に差があるかを、1回の検定でまとめて調べる方法です。「一元」は要因が1つという意味で、考案したのは統計学者のFisherです。名前は「分散」分析ですが、比べているのは平均値です。平均値の差を、ばらつき(分散)の大きさを使って判定するので、この名前がついています。
帰無仮説は「すべての群の母平均が等しい」(\(H_0:\mu_1=\mu_2=\cdots=\mu_k\))、対立仮説は「少なくとも1つの群の母平均が異なる」です。有意になっても、どの群とどの群が違うかまではわかりません。それを調べるのが多重比較です。検定の判断に使うp値の意味はp値とは?意味・求め方・0.05の基準と3つの誤解で確認できます。
t検定を繰り返してはいけない理由
「3群ならt検定を3回やればよいのでは?」と思うかもしれません。3群のペアは A-B、A-C、B-C の3通りです。1回の検定で、差がないのに差ありと誤る確率(第1種の過誤)を5%にしていても、3回のうちどれか1つでも誤る確率は5%より大きくなります。これが多重性の問題です。実際にシミュレーションで確かめてみましょう。
# 3群とも母平均が同じ(本当は差がない)データを1万回作り、「差あり」と誤る割合を数える
set.seed(1)
g <- factor(rep(c("A", "B", "C"), each = 20))
res <- replicate(10000, {
  y  <- rnorm(60, mean = 0, sd = 8)
  pt <- pairwise.t.test(y, g, p.adjust.method = "none")$p.value   # 調整なしのt検定を3回
  pa <- summary(aov(y ~ g))[[1]]$`Pr(>F)`[1]                      # 分散分析を1回
  c(t検定3回のどれかが有意 = any(pt < 0.05, na.rm = TRUE), 分散分析が有意 = pa < 0.05)
})
rowMeans(res)
1 - 0.95^3   # 3回の検定が独立だと仮定したときの理論値
t検定3回のどれかが有意         分散分析が有意
                0.1207                 0.0503
[1] 0.142625
rnorm() で平均0の乱数を60個作っているので、3群とも差がない世界です。pairwise.t.test() は全ペアのt検定をまとめて行う関数で、p.adjust.method = "none" は「調整なし」を意味します。これを replicate() で1万回くり返し、rowMeans() で「有意になった割合」を出しています。
3回の検定が独立なら \(1-0.95^3=0.143\)(14.3%)です。実際は同じ群を使い回すので検定どうしが独立ではなく、シミュレーションでは 12.1% でした。いずれにせよ5%の約2.4倍です。一方、分散分析は1回の検定なので 5.0% に保たれます。群が増えるほどペアの数は増え(4群で6通り、5群で10通り)、問題はさらに深刻になります。多重性の考え方は多重比較法の基礎と活用で詳しく解説しています。
群間のばらつきと群内のばらつきを比べる
分散分析の考え方は、「信号と雑音の比」で説明できます。3つのクラスの平均点が60点・65点・70点だったとします。クラス内の点数が50〜80点とバラバラなら、この平均点の差は「たまたま」かもしれません。逆にクラス内がほぼ全員同じ点数なら、5点の差でも本物の差らしく見えます。
平均点どうしの離れ具合が群間のばらつき(信号)、同じ群の中での人による違いが群内のばらつき(雑音=偶然の誤差の大きさ)です。この2つの比がF統計量です。
F=群間のばらつき ÷ 群内のばらつき
考え方を図にすると次のようになります。
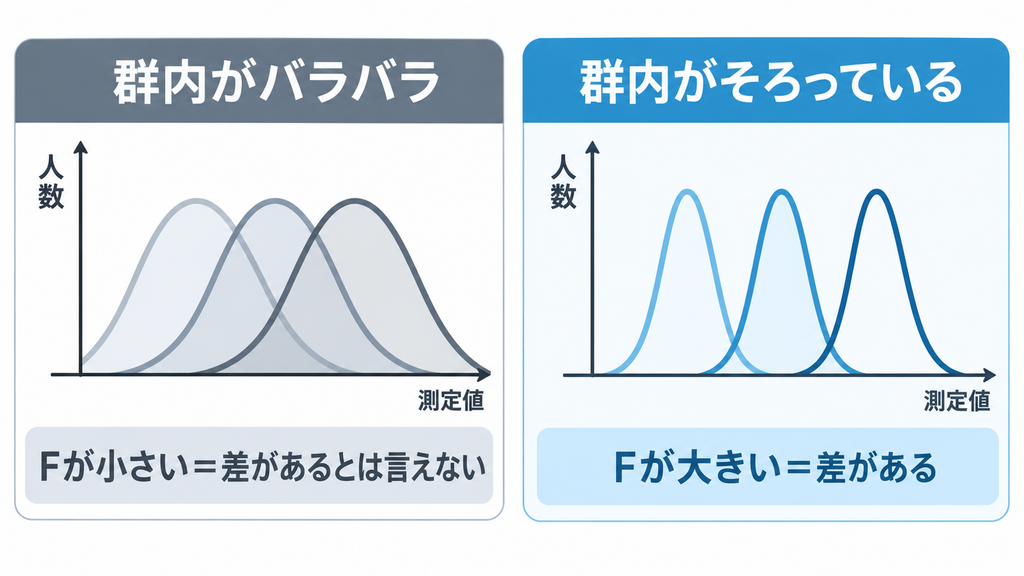
正式な式は次章で示します。2つのパターンを対比すると、次のとおりです。
| 状況 | 群間のばらつき | 群内のばらつき | Fの値 | 判断 |
|---|---|---|---|---|
| 群の平均は離れているが群内もバラバラ | 大 | 大 | 1に近い | 差があるとは言えない |
| 群の平均が離れていて群内はそろっている | 大 | 小 | 大きい | 差がある |
分散分析は統計検定2級でも頻出のテーマです。試験対策には統計検定2級「仮説検定・区間推定」攻略も役立ちます。
ここまでのまとめ
- 一元配置分散分析は、3群以上の平均値に差があるかを1回の検定で調べる方法です
- t検定を繰り返すと、差がないのに「差あり」と誤る割合が12.1%に膨らみます。分散分析なら5.0%に保たれます
- 判断の鍵は、群間のばらつきと群内のばらつきの比(F統計量)です
分散分析の数理 ― 平方和の分解とF分布
数式が苦手な方は、この章を飛ばして次章のRの実行例に進んでも大丈夫です。ここでは、F統計量がなぜ「差の有無」の物差しになるのかを、結果と意味だけ確認します。最尤推定量や期待値、F分布に従うことの証明を順に追いたい方は、一元配置分散分析(One-way ANOVA)の数理的導入とRによる実装をご覧ください。
モデル:各人の値を「全体平均+所属群の効果+誤差」と考えます。
\[ Y_{ij}=\mu+\alpha_i+\varepsilon_{ij},\qquad \varepsilon_{ij}\sim N(0,\sigma^2) \]
\(\mu\) は全体平均、\(\alpha_i\) は第 \(i\) 群の効果(全体平均からのずれ。\(\sum_i n_i\alpha_i=0\) の制約を置きます)、\(\varepsilon_{ij}\) は互いに独立な誤差です。帰無仮説「すべての群の母平均が等しい」は、\(\alpha_1=\cdots=\alpha_k=0\) と同じ意味になります。
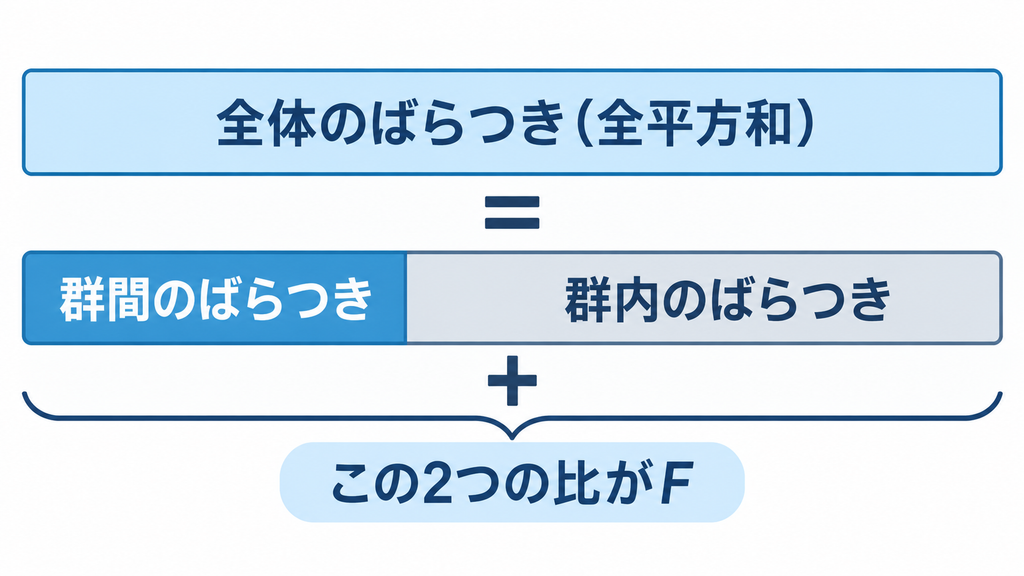
平方和の分解:全体のばらつきは、群間と群内の2つに過不足なく分けられます。
\[ \sum_{i=1}^{k}\sum_{j=1}^{n_i}(Y_{ij}-\bar{Y}_{\cdot\cdot})^2=\sum_{i=1}^{k}n_i(\bar{Y}_{i\cdot}-\bar{Y}_{\cdot\cdot})^2+\sum_{i=1}^{k}\sum_{j=1}^{n_i}(Y_{ij}-\bar{Y}_{i\cdot})^2 \]
左辺が全平方和 \(S_T\)、右辺第1項が群間平方和 \(S_B\)、第2項が群内平方和(誤差平方和)\(S_W\) で、\(S_T=S_B+S_W\) です。
| 変動 | 記号 | 意味 | 自由度 |
|---|---|---|---|
| 群間 | \(S_B\) | 群の平均と全体平均のずれ | \(k-1\) |
| 群内(誤差) | \(S_W\) | 各人の値と群の平均のずれ | \(N-k\) |
| 全体 | \(S_T\) | 各人の値と全体平均のずれ | \(N-1\) |
平方和を自由度で割ったものが平均平方で、\(MS_B=S_B/(k-1)\)、\(MS_W=S_W/(N-k)\) です。
期待値:平均平方が平均的にどんな値になるかを見ると、F統計量の意味がわかります。
\[ E(MS_W)=\sigma^2,\qquad E(MS_B)=\sigma^2+\frac{1}{k-1}\sum_{i=1}^{k}n_i\alpha_i^2 \]
群内の平均平方は、群に差があってもなくても誤差分散 \(\sigma^2\) を推定します。群間の平均平方は、差がなければ(すべての \(\alpha_i=0\))同じく \(\sigma^2\)、差があればその分だけ大きくなります。だから比
\[ F=\frac{MS_B}{MS_W}=\frac{S_B/(k-1)}{S_W/(N-k)} \]
は、差がなければ1前後、差があれば1より大きくなります。
分布:正規性と等分散性のもとで、\(S_W/\sigma^2\) は自由度 \(N-k\) のカイ二乗分布に従います。帰無仮説のもとでは \(S_B/\sigma^2\) も自由度 \(k-1\) のカイ二乗分布に従い、両者は独立です。「独立な2つのカイ二乗変数を、それぞれの自由度で割った比」がF分布の定義なので、F統計量は自由度 \((k-1,\,N-k)\) のF分布に従います。つまり前提条件(正規性・等分散性・独立性)は、この導出のために必要なのです。F分布やカイ二乗分布などの標本分布は統計検定2級「確率分布」攻略で、二元配置・乱塊法などより進んだ内容は統計検定準1級「分散分析・実験計画法」攻略で学べます。
Rで一元配置分散分析を実行する ― 3つの用量群の血圧変化量を比べる
ここからは説明用の架空データで実際に動かします。高血圧の患者60人をプラセボ・低用量・高用量の3群に20人ずつランダムに割り付け、12週後の収縮期血圧の変化量(mmHg、マイナスが大きいほど血圧が下がった)を比べる想定です。Rの乱数で作ったデータなので、実在の薬の効果を示すものではありません。
Rでの実装
データを作って要約する:まず架空データを作り、群ごとの人数・平均・標準偏差を確認します。
# 架空の臨床試験:3つの群に20人ずつ割り付け、12週後の収縮期血圧の変化量(mmHg)を測定
set.seed(2026)
dat <- data.frame(
  group  = factor(rep(c("プラセボ", "低用量", "高用量"), each = 20),
                  levels = c("プラセボ", "低用量", "高用量")),
  change = c(rnorm(20, mean = -2, sd = 8),    # プラセボ群
             rnorm(20, mean = -6, sd = 8),    # 低用量群
             rnorm(20, mean = -10, sd = 8))   # 高用量群
)
head(dat, 3)
# 群ごとの人数・平均・標準偏差
data.frame(
  n    = tapply(dat$change, dat$group, length),
  mean = round(tapply(dat$change, dat$group, mean), 2),
  sd   = round(tapply(dat$change, dat$group, sd), 2)
)
round(mean(dat$change), 2)   # 全体の平均
     group      change
1 プラセボ   2.1647126
2 プラセボ -10.6375261
3 プラセボ  -0.8860951
          n   mean   sd
プラセボ 20  -5.15 7.70
低用量   20  -3.51 7.42
高用量   20 -11.98 6.59
[1] -6.88
rnorm() で、母平均が −2・−6・−10、標準偏差が8の正規分布から20人ずつ乱数を作っています。factor() の levels は群の並び順の指定、tapply() は群ごとに関数を当てはめる関数です。
標本平均はプラセボ −5.15、低用量 −3.51、高用量 −11.98、全体平均は −6.88 です。標準偏差は 6.59〜7.70 で、3群とも近い値です。20人ずつの標本では、標本平均は母平均(−2・−6・−10)からこのくらいずれます。低用量がプラセボより下がっていないのは偶然のばらつきです。だからこそ「見た目の差が偶然で説明できるか」を検定で確かめます。標準偏差の意味は【やさしく解説】標準偏差(SD)と標準誤差(SE)の違いをご覧ください。
aov() で分散分析:Rでは aov() 1行で一元配置分散分析ができます。
fit <- aov(change ~ group, data = dat)   # 一元配置分散分析
summary(fit)
            Df Sum Sq Mean Sq F value  Pr(>F)
group        2    807   403.5   7.671 0.00112 **
Residuals   57   2998    52.6
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
change ~ group は「変化量を群で説明する」という式です。出力は分散分析表と呼ばれ、次のように読みます。
| 列名 | 意味 | この例の値 |
|---|---|---|
| Df | 自由度 | 群間 2(=3−1)、群内 57(=60−3) |
| Sum Sq | 平方和 | 807、2998 |
| Mean Sq | 平均平方(平方和÷自由度) | 403.5、52.6 |
| F value | F統計量(群間÷群内の平均平方) | 7.671 |
| Pr(>F) | p値 | 0.00112 |
group の行が群間、Residuals(残差)の行が群内です。F=7.671 は「群間のばらつきが群内のばらつきの約7.7倍」という意味で、p=0.0011 は0.05を下回るため、「3群の母平均がすべて等しい」という帰無仮説は棄却されます。ただしどの群が違うかはまだわかりません。全体のばらつきが群間と群内に分かれる様子を、図でも確認しておきます。
分散分析表を手計算で再現する:aov() の中身を、平方和の定義から自分で計算して確かめます。
grand <- mean(dat$change)                        # 全体平均
m     <- tapply(dat$change, dat$group, mean)     # 群ごとの平均
n     <- tapply(dat$change, dat$group, length)   # 群ごとの人数
SSB <- sum(n * (m - grand)^2)                    # 群間平方和
SSW <- sum((dat$change - m[dat$group])^2)        # 群内平方和
SST <- sum((dat$change - grand)^2)               # 全平方和
round(c(SSB = SSB, SSW = SSW, SST = SST, check = SSB + SSW), 1)
MSB <- SSB / (3 - 1)     # 群間の平均平方(自由度 = 群数 - 1)
MSW <- SSW / (60 - 3)    # 群内の平均平方(自由度 = 全人数 - 群数)
Fval <- MSB / MSW
round(c(MSB = MSB, MSW = MSW, F = Fval), 3)
pf(Fval, df1 = 2, df2 = 57, lower.tail = FALSE)  # F分布の上側確率 = p値
   SSB    SSW    SST  check
 807.0 2998.3 3805.3 3805.3
    MSB     MSW       F
403.485  52.602   7.671
[1] 0.001121903
前半で3種類の平方和を式どおりに求め、後半で自由度で割って平均平方とF値を出し、pf()(F分布の確率を求める関数)で上側確率、つまりp値を計算しています。
群間平方和 807.0+群内平方和 2998.3=全平方和 3805.3 で、
check が SST と一致し、平方和の分解が数値で確認できます。F=403.485÷52.602=7.671、p=0.00112 で、aov() の結果と一致しました。aov() は中でこの計算をしているだけです。群内の平均平方 52.602 は「3群に共通の分散の推定値」で、その平方根は約7.25(\(\sqrt{52.602}\approx7.25\))と、データを作るときに設定した標準偏差8に近い値です。2群なら F=t² になる:分散分析とt検定の関係を、プラセボと高用量の2群だけで確かめます。
# 2群だけ(プラセボと高用量)を取り出して、t検定と分散分析を比べる
d2 <- droplevels(subset(dat, group != "低用量"))
tt <- t.test(change ~ group, data = d2, var.equal = TRUE)   # 等分散を仮定したt検定
a2 <- summary(aov(change ~ group, data = d2))[[1]]
round(c(t = unname(tt$statistic), t_squared = unname(tt$statistic)^2, F = a2$`F value`[1]), 4)
c(p_ttest = tt$p.value, p_anova = a2$`Pr(>F)`[1])
        t t_squared         F
   3.0157    9.0943    9.0943
    p_ttest     p_anova
0.004553268 0.004553268
subset() と droplevels() で2群だけを取り出し、等分散を仮定したt検定(var.equal = TRUE)と分散分析を同じデータに当てはめています。
t統計量 3.0157 を2乗した 9.0943 が分散分析のF値と一致し、p値(0.00455)も完全に同じです。つまり分散分析は「等分散を仮定した2標本t検定」を3群以上に拡張したもので、両者は別物ではなく地続きです。さらに一般化すると、どちらも「線形モデル」の特別な場合です。詳しくは一般線形モデルと一般化線形モデルの違いを徹底解説をご覧ください。
ここまでのまとめ
- 全体のばらつきは「群間+群内」に分解でき、F統計量はその平均平方の比で、帰無仮説のもとでF分布に従います
aov()の分散分析表は、平方和の手計算(F=7.671、p=0.0011)で完全に再現できます- 2群なら F=t² となり、分散分析は等分散を仮定したt検定の拡張です
SASでの実装
製薬業界の解析ではSASを使う場面も多いので、同じ解析をSASで書くとどうなるかを紹介します。まず、Rで作ったデータをCSVに書き出しておきます。write.csv(dat, "anova_bp.csv", row.names = FALSE) を実行すれば作れます。群の名前が日本語のままだと文字コードの違いで文字化けすることがあるので、環境に合わせて文字コードを指定するか、群の名前を英字(placebo・low・high など)にしておくと扱いやすくなります。
/* Rで作ったデータをCSV(列:group, change)に書き出し、SASに読み込む */
proc import datafile="anova_bp.csv" out=bp dbms=csv replace;
  getnames=yes;
run;

/* 一元配置分散分析・等分散性の検定・Welchの分散分析・Tukeyの多重比較 */
proc glm data=bp;
  class group;
  model change = group;
  means group / hovtest=bartlett welch;
  lsmeans group / pdiff=all adjust=tukey cl;
run;
quit;

/* Kruskal-Wallis検定 */
proc npar1way data=bp wilcoxon;
  class group;
  var change;
run;
このコードが何をしているかを順に説明します。
PROC GLM(一般線形モデルのプロシジャ)のCLASS文で群を表す変数(分類変数)を指定し、MODEL文に目的変数 = 要因の形でモデルを書きます。分散分析表(平方和・平均平方・F値・p値)が出力されますMEANS文のHOVTEST=BARTLETTで等分散性のBartlett検定、WELCHでWelchの分散分析を追加できます。HOVTESTを値なしで指定したときの既定はLevene検定ですLSMEANS文のPDIFF=ALL ADJUST=TUKEYで全ペアの差をTukeyの方法で調整して比較し、CLで信頼区間を出します。対照群との比較だけならADJUST=DUNNETTを使いますPROC GLMは対話型のプロシジャなので、最後にQUIT;で終了させますPROC NPAR1WAYにWILCOXONオプションを付けると、3群以上ではKruskal-Wallis検定が出力されます- SASには
PROC ANOVAもありますが、各群の人数がそろったデータ(釣り合い型)向けです。人数が不揃いでも使えるPROC GLMを覚えておけば足ります
SASの出力で、分散分析表のF値と自由度がRの summary(fit) と対応しているかを確かめると、実装の検算になります。
前提条件の確認と、崩れたときの代替手法
分散分析のF検定が正しく働くには、3つの前提条件があります。前章で作った dat と fit を使って、確認の仕方と、崩れたときの代替手法を見ていきましょう。なお、独立性は検定で確かめるものではなく、試験デザイン(データの取り方)で判断します。
| 前提 | 意味 | 崩れやすい場面 | 対処 |
|---|---|---|---|
| 独立性 | 各観測値が互いに影響しない | 同じ人を複数回測定したデータ、同じ施設・家族のデータ | 反復測定や混合モデルなど別の方法 |
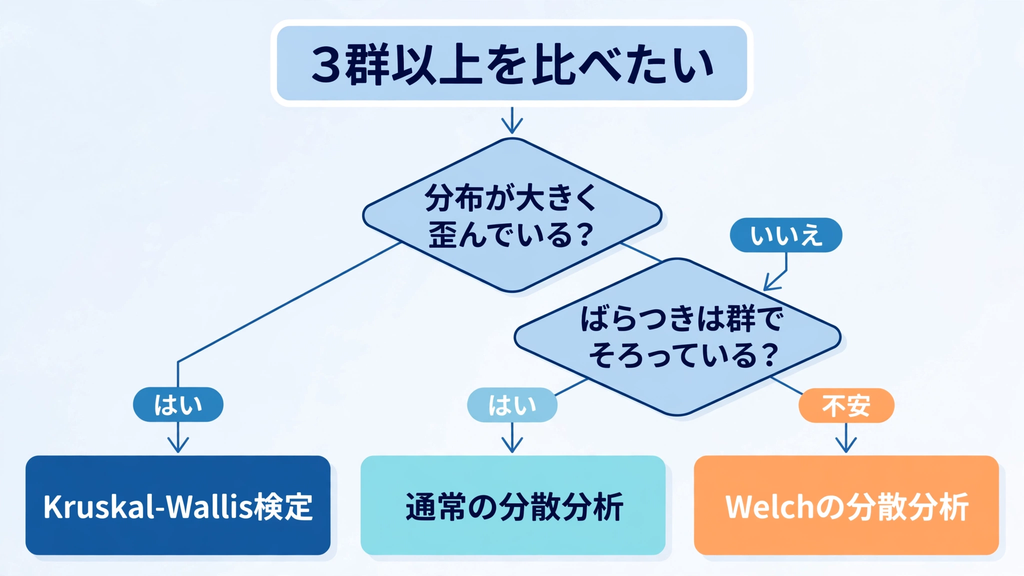
| 正規性 | 各群の誤差が正規分布に従う | 外れ値、強く歪んだ分布 | Kruskal-Wallis検定や変数変換(対数変換など) |
| 等分散性 | 各群の母分散が等しい | 群によってばらつきが大きく違う | Welchの分散分析 |
等分散性と正規性を確認する
まず、等分散性をBartlett検定で、正規性を残差のShapiro-Wilk検定で調べます。
bartlett.test(change ~ group, data = dat)   # 等分散性の検定(Bartlett検定)
shapiro.test(residuals(fit))                # 残差の正規性の検定(Shapiro-Wilk検定)
	Bartlett test of homogeneity of variances

data:  change by group
Bartlett's K-squared = 0.48519, df = 2, p-value = 0.7846


	Shapiro-Wilk normality test

data:  residuals(fit)
W = 0.98374, p-value = 0.6048
Bartlett検定の帰無仮説は「3群の分散が等しい」です。p=0.78 なので、等分散を疑う証拠はありません。残差(各人の値からその群の平均を引いたもの)のShapiro-Wilk検定もp=0.60で、正規性を疑う証拠はありません。ただしp値が大きいことは、前提が成り立つ証明ではありません。人数が少ないと検定はずれを見つけにくく、多いと実害のない小さなずれまで拾います。p値だけで機械的に判断せず、箱ひげ図や残差のQ-Qプロット(
plot(fit, which = 2) で描けます)を目で見るのが基本です。詳しくは正規性の検定(Shapiro-Wilk)とはをご覧ください。なおBartlett検定は、正規分布からのずれに敏感な性質があります。前提が怪しいときの代替手法が、Welchの分散分析とKruskal-Wallis検定です。
oneway.test(change ~ group, data = dat)     # Welchの分散分析(等分散を仮定しない)
kruskal.test(change ~ group, data = dat)    # Kruskal-Wallis検定(順位にもとづく)
	One-way analysis of means (not assuming equal variances)

data:  change and group
F = 8.2862, num df = 2.00, denom df = 37.82, p-value = 0.001037


	Kruskal-Wallis rank sum test

data:  change by group
Kruskal-Wallis chi-squared = 11.945, df = 2, p-value = 0.002548
| 方法 | Rの関数 | 前提 | この例のp値 |
|---|---|---|---|
| 通常の分散分析 | aov() | 正規性・等分散性 | 0.0011 |
| Welchの分散分析 | oneway.test() | 正規性(等分散は不要) | 0.0010 |
| Kruskal-Wallis検定 | kruskal.test() | 分布の形を仮定しない(順位を使う) | 0.0025 |
この例は前提が成り立つデータなので、3つとも同じ結論です。Welchの分散分析は分母の自由度が37.82と小数になります。分散の違いに応じて自由度を調整するためで、2群のWelchのt検定と同じ発想です。
oneway.test() は既定で等分散を仮定しません(var.equal = FALSE)。Kruskal-Wallis検定は値を順位に置き換えて比べる方法で、外れ値や歪んだ分布に強い反面、見ているのは「平均値の差」ではなく「分布の位置のずれ」です。詳しくは統計検定準1級「ノンパラメトリック法」攻略と【やさしく解説】平均値と中央値の違いをご覧ください。等分散が崩れると何が起きるか
等分散が崩れると、通常の分散分析の誤り率がどうなるかを実測します。3群とも母平均は0(本当は差がない)ですが、人数が少ない群ほどばらつきが大きい設定です。
# 差がない3群。ただし人数が少ない群ほどばらつきが大きい(n = 30, 15, 15、SD = 5, 10, 10)
set.seed(2)
g2 <- factor(rep(c("A", "B", "C"), times = c(30, 15, 15)))
res2 <- replicate(10000, {
  y <- c(rnorm(30, 0, 5), rnorm(15, 0, 10), rnorm(15, 0, 10))
  c(通常の分散分析 = summary(aov(y ~ g2))[[1]]$`Pr(>F)`[1] < 0.05,
    Welchの分散分析 = oneway.test(y ~ g2)$p.value < 0.05)
})
rowMeans(res2)
 通常の分散分析 Welchの分散分析
         0.1044          0.0502
このコードは、人数とばらつきが違う3群のデータを1万回作り、通常の分散分析とWelchの分散分析がそれぞれ「差あり」と判定した割合を rowMeans() で出しています。
差がないのに、通常の分散分析は10.4%の割合で「差あり」と誤りました。有意水準5%のつもりが約2倍です。Welchの分散分析は5.0%に保たれています。通常の分散分析は3群の分散を1つにまとめて(プールして)誤差を見積もります。人数の多い群(ばらつき小)に引っ張られて誤差を小さく見積もるため、ばらつきの大きい少人数の群の平均が偶然ずれただけで「差あり」と判定しやすくなるのです。人数がそろっていれば影響は比較的小さい一方、人数が不揃いで少人数の群ほどばらつきが大きいときに影響が大きくなります。
「等分散性の検定で有意でなければ通常の分散分析、有意ならWelch」という2段階の手順は、検定を重ねることで全体の誤り率がずれるため、推奨されないことが多いです。等分散に自信がなければ、最初からWelchの分散分析を使うのが実務的です(2群のt検定で最初からWelchを使うのと同じ考え方です)。臨床試験では解析方法を事前に統計解析計画書で決めておくので、データを見てから方法を選ぶことは避けます。
ここまでの使い分けを図にまとめます。
群に順序がある(低用量→高用量など)ときに「用量が上がるほど効果が大きくなる」という傾向を調べたいなら、Jonckheere の順位和検定を徹底解説で紹介している傾向検定もあります。各群の人数がごく少ないときの考え方は、症例数が少ないときの統計解析をご覧ください。
ここまでのまとめ
- 独立性は試験デザインで、正規性と等分散性は検定と図で確認します。ただしp値が大きくても前提が証明されたわけではありません。
- 前提が怪しいときは、Welchの分散分析(平均値を比べる)かKruskal-Wallis検定(順位を使う)が代替になります。
- 人数が不揃いで等分散が崩れると通常の分散分析の誤り率は10.4%に膨らむので、自信がなければ最初からWelchを使いましょう。
有意だったあとにすること ― 多重比較・効果量と実務でのポイント
分散分析が有意でも、わかるのは「どこかの群の平均が違う」ことだけです。どの群とどの群が違うのかを調べるのが多重比較です。ここでは前章までに作った fit を使います。
Tukeyの方法でどの群に差があるかを調べる
3つの群のすべてのペアを、全体の誤り率を保ったまま比べるのがTukeyの方法です。あわせて効果量のイータ2乗も計算します。
TukeyHSD(fit)   # Tukeyの方法による全ペアの比較
# 効果量イータ2乗 = 群間平方和 / 全平方和
ss <- summary(fit)[[1]]$`Sum Sq`
round(ss[1] / sum(ss), 3)
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = change ~ group, data = dat)

$group
                     diff        lwr       upr     p adj
低用量-プラセボ  1.633192  -3.885949  7.152333 0.7573714
高用量-プラセボ -6.833391 -12.352532 -1.314250 0.0116272
高用量-低用量   -8.466583 -13.985724 -2.947442 0.0014327

[1] 0.212
TukeyHSD() は分散分析の結果に対して全ペアの比較をまとめて行う関数です。後半は、群間平方和を全平方和で割って効果量を求めています。
diff は平均値の差、lwr・upr は3つの比較全体で95%を保証する同時信頼区間の下限・上限、p adj は多重性を調整したp値です。高用量−プラセボは差 −6.83 mmHg(95%信頼区間 −12.35〜−1.31)、調整p=0.012。高用量−低用量は差 −8.47 mmHg(−13.99〜−2.95)、調整p=0.0014で、どちらも信頼区間が0を含まず有意です。
低用量−プラセボは差 +1.63(−3.89〜7.15)、調整p=0.76で有意ではなく、信頼区間が0をまたいでいます。これは「差がない」と証明されたのではなく、この人数では差を検出できなかったという意味です。
効果量のイータ2乗(\(\eta^2\))は0.212で、変化量のばらつき全体のうち約21%が「群の違い」で説明できます。式は \(\eta^2=S_B/S_T\)(807.0÷3805.3≒0.212)です。p値は人数に左右されるので、差の大きさ・信頼区間・効果量も一緒に報告しましょう。詳しくは効果量(Effect Size)を理解すると統計が一気に実務的になるをご覧ください。
Tukeyの方法は全ペアを比べたいときの方法です。プラセボ(対照群)との比較だけに関心があるなら、Dunnettの方法のほうが検出力が高くなります。方法の使い分けは次の表のとおりで、実装は多重比較法をRで実装するで解説しています。
| 方法 | 比べる組み合わせ | 向いている場面 |
|---|---|---|
| Tukey | すべてのペア | 群どうしを総当たりで比べたい |
| Dunnett | 対照群と各群 | プラセボと各用量を比べたい |
| Bonferroni・Holm | あらかじめ決めた任意の組み合わせ | 比較の数が少ない・分散分析以外の検定にも使いたい |
臨床試験での使いどころと注意点
分散分析は「入口」とは限りません。 「まず分散分析、有意なら多重比較」という手順は必須ではありません。TukeyやDunnettはそれ自体で全体の誤り率を制御するので、関心のある比較が決まっているなら最初から多重比較法を使ってかまいません。検証的な臨床試験では、比較と多重性の調整方法を事前に決めておきます。考え方はGatekeeping法とはが参考になります。
用量反応を見たいときは、群を単なるカテゴリとして扱う分散分析より、用量の順序や用量反応曲線を使う方法のほうが適しています。代表的なものがMCP-Mod(多重比較とモデリング)で用量反応を解析するで紹介している方法です。
ベースライン値で調整することも大切です。臨床試験では、投与前の値(ベースライン)を共変量に入れた共分散分析(ANCOVA)が主解析になることが多く、これは分散分析に連続量の共変量を加えたものです。詳しくは共変量調整(ANCOVA)徹底解説をご覧ください。
要因が2つ(例:薬剤と性別)なら二元配置分散分析で、交互作用も調べられます。製薬業界での二元配置分散分析入門に進んでみてください。
ランダム化しているからこそ、群間の差を薬の効果と解釈できます。【やさしく解説】RCT(ランダム化比較試験)とはで基本を確認しておきましょう。
分散分析を使うときのチェックリストです。
- 比べたいのは3群以上の平均値か(2群ならt検定)
- データは互いに独立か(同じ人の反復測定ではないか)
- ばらつきが群で大きく違わないか(不安ならWelchの分散分析)
- 有意だったあと、どの群間を比べるかを事前に決めたか(Tukey・Dunnett)
- p値だけでなく、差の大きさ・信頼区間・効果量を報告したか
📚 この記事をより深く理解するための参考書籍
分散分析を「操作しながら」「計画の立て方から」「理論から」の3方向で深められる3冊を紹介します。



生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
分散分析をさらに広げたい方は、本記事で結果だけを示した定理の証明を一元配置分散分析(One-way ANOVA)の数理的導入とRによる実装で、要因が2つの場合を製薬業界での二元配置分散分析入門で、ベースライン値を共変量に加える方法を共変量調整(ANCOVA)徹底解説でご覧ください。乱塊法や直交表まで含めた整理は統計検定準1級「分散分析・実験計画法」攻略にまとめています。
有意だったあとの比較を詳しく知りたい方は、考え方を多重比較法の基礎と活用で、Dunnettや閉検定手順の実装を多重比較法をRで実装するで確かめられます。
2群の比較から復習したい方は、t検定の数理的導出とRによる実装例と対応のあるt検定とウィルコクソン符号順位検定がおすすめです。資格の勉強に活かしたい方は統計検定2級「仮説検定・区間推定」攻略・統計検定2級「確率分布」攻略・統計検定2級「データの記述と相関・回帰」攻略もあわせてどうぞ。
まとめ
本記事では、3群以上の平均値をまとめて比べる一元配置分散分析を、架空の臨床試験データとRで確かめながら整理しました。
分散分析の中心にあるのは、「群間のばらつき」と「群内のばらつき」の比であるF統計量です。3つの用量群の例では、群間平方和807.0と群内平方和2998.3から F=7.671、p=0.0011 が得られ、aov() の分散分析表を手計算で再現できました。2群に絞ると F=t² となり、分散分析が等分散を仮定したt検定の拡張であることも確かめました。
t検定を3回繰り返すと、本当は差がないのに「差あり」と誤る割合は12.1%に膨らみますが、分散分析なら5.0%に保たれます。一方で、人数が不揃いで等分散が崩れると通常の分散分析の誤り率は10.4%になり、Welchの分散分析なら5.0%のままでした。等分散に自信がなければ最初からWelchの分散分析を選ぶ、という判断が実務では有用です。
分散分析が有意でもわかるのは「どこかに差がある」ことまでです。Tukeyの方法では、高用量がプラセボ(差 −6.83 mmHg)・低用量(差 −8.47 mmHg)の両方と有意に異なりました。p値だけでなく、差の大きさと信頼区間、効果量(\(\eta^2=0.212\))を添えて報告することが大切です。次の一歩として、比較の組み立て方を多重比較法をRで実装するで、要因が増えた場合を製薬業界での二元配置分散分析入門で確かめていただければと思います。