統計検定2級「データの記述と相関・回帰」攻略 ― 要約統計量・箱ひげ図・相関係数と回帰直線の典型出題を例題7問で解説 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
統計検定2級の対策として、出題範囲のうち「データの記述」と「相関・回帰」に絞り、本番で出そうな例題を筆者(生物統計家)が選定しました。数値はすべてRで検算したうえで掲載しています。この記事でわかること
💡 この記事でわかること
本記事は、統計検定2級の攻略シリーズの第3弾です。第1弾統計検定2級「仮説検定・区間推定」攻略では信頼区間と検定の手続きを、第2弾統計検定2級「確率分布」攻略では分布そのものを例題7問で解説しました。本記事はその前段にあたり、検定に入る前にデータを要約する「データの記述」と、2変数の関係を見る「相関・回帰」を扱います。各例題にはRのコードと出力を併記し、手計算の答え合わせまで1記事で完結します。- データを代表値と散らばりで要約し、平均と中央値の使い分け、四分位数と外れ値の判定を電卓で進める方法
- 標準化(Z得点・偏差値)と変動係数で、条件の異なるデータを同じ物差しで比べる方法
- 成長率の平均に幾何平均を使う理由と、時系列データの基本的な処理
- 偏差積和から相関係数を計算し、回帰直線と決定係数で予測までつなげる手順
はじめに
統計検定2級の試験はCBT方式で、試験時間は90分、出題は35問程度、4〜5肢の選択式です。100点満点で60点以上が合格で、試験中は四則演算・百分率・平方根ができる普通電卓のみが使えます(関数電卓は不可)。計算の速さそのものよりも、問題が「中心を聞いているのか、散らばりを聞いているのか、関係と予測を聞いているのか」を見分ける力が問われます。 出題範囲のうち1変数データの分野には、中心傾向の指標、散らばりの指標、中心と散らばりの活用(標準化・変動係数)、時系列データの処理が含まれます。2変数以上のデータの分野では、散布図と相関(相関係数・共分散・みかけの相関)、単回帰と予測(最小二乗法・決定係数・残差)が問われます。推定や検定の計算も、元をたどればこの要約の積み重ねです。 本記事では、データの記述と相関・回帰の典型出題を例題7問に絞り、前2弾と同じ形式で解説します。各例題は「問題 → 普通電卓でできる手計算の途中式 → 検算 → Rでの答え合わせ → 解釈」の順に進めます。なお、カテゴリカルデータ(分割表と独立性)は第1弾のカイ二乗検定で扱ったため本記事の対象外とし、重回帰も線形モデルを扱う回に譲ります。また、四分位数の求め方は流儀で値が変わるため、本記事ではヒンジ法(中央値で上下半分に分け、各半分の中央値をとる方法)で統一し、Rの答え合わせには fivenum() を使います。 データの要約が苦手になりやすいのは、平均・分散・相関係数といった言葉が先に立ち、「どの指標を、どんなデータに使うのか」の判断が抜けたまま公式だけを覚えようとするためです。本記事の例題は、得点・来客数・勉強時間といった身近な対象に数値を入れてあります。読み方は、まず答えを見ずに電卓で手計算し、詰まった箇所だけ途中式と照らし合わせるのがおすすめです。Rのコードは答え合わせ専用ですので、Rが使えない環境でも支障はありません。要約方法の選び方は、臨床試験で検査値の報告形式を決める実務でも判断の土台になります。データの要約 ― 代表値と散らばり
データを手にしたとき、最初に行うのが要約です。代表値で中心を、散らばりの指標でばらつきを押さえることで、全体の姿が見えてきます。臨床試験で検査値の分布を確認するときも、まずはこの組み合わせから入ります。本章では、普通電卓で追える計算の流れに沿って2問を解きます。例題1 テスト得点から代表値と散らばりを求める
問題 10人のテスト得点(点)は50, 55, 60, 60, 65, 70, 75, 80, 85, 100です。平均値・中央値・最頻値・範囲と、分散(分母を \(n\) とするもの)・不偏分散・不偏標準偏差を求めてください。 解答 平均値は合計を人数で割ることで求めます。\[\bar{x}=\frac{50+55+\cdots+100}{10}=\frac{700}{10}=70\]
中央値は、真ん中の2つ(5番目の65と6番目の70)の平均で \(67.5\) です。最頻値は2回現れる \(60\)、範囲は \(100-50=50\) となります。散らばりは偏差平方和から求めます。各得点から平均 \(70\) を引いて2乗すると400, 225, 100, 100, 25, 0, 25, 100, 225, 900となり、合計は \(2100\) です。\[\sigma^2=\frac{2100}{10}=210,\quad s^2=\frac{2100}{9}=233.33,\quad s=\sqrt{233.33}=15.2753\]
検算 偏差の合計は \(-20-15-10-10-5+0+5+10+15+30=0\) となり、平均の計算と矛盾しません。 Rで答え合わせをします。# 例題1:10人のテスト得点の代表値と散らばりを求める
score <- c(50, 55, 60, 60, 65, 70, 75, 80, 85, 100)
n <- length(score)
mean_score <- mean(score)
median_score <- median(score)
var_pop <- sum((score - mean_score)^2) / n
var_unbiased <- var(score)
round(c(n = n, mean = mean_score, median = median_score,
range = max(score) - min(score), var_pop = var_pop,
var_unbiased = var_unbiased, sd_unbiased = sqrt(var_unbiased)), 4)
           n         mean       median        range      var_pop var_unbiased
     10.0000      70.0000      67.5000      50.0000     210.0000     233.3333
 sd_unbiased
     15.2753
📝 解釈・補足
平均 \(70\) は中央値 \(67.5\) より大きく、100点という右端の大きな値に平均が引っ張られています。右に裾を引くデータでは代表値を平均だけで示すと実態より高く見えるため、中央値も併記するのが安全です。本番では、分散の分母が \(n\) か \(n-1\) かの指示を見落とさないことが大切です。
平均 \(70\) は中央値 \(67.5\) より大きく、100点という右端の大きな値に平均が引っ張られています。右に裾を引くデータでは代表値を平均だけで示すと実態より高く見えるため、中央値も併記するのが安全です。本番では、分散の分母が \(n\) か \(n-1\) かの指示を見落とさないことが大切です。
例題2 来客数から四分位数と外れ値を判定する
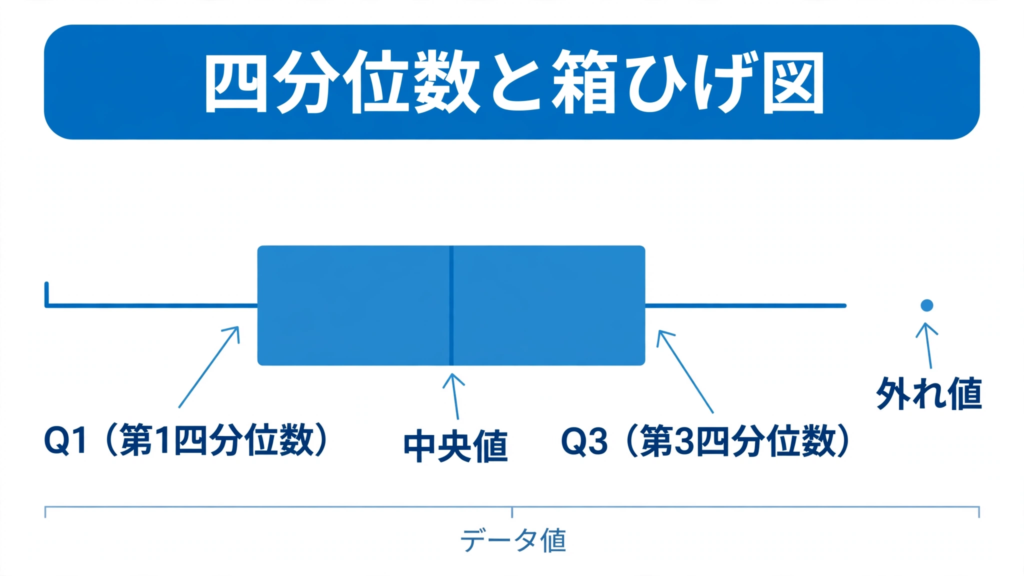
問題 ある店舗の12日間の来客数(人)は22, 25, 28, 30, 32, 34, 36, 38, 40, 42, 45, 78です。四分位数はヒンジ法(中央値で上下半分に分け、各半分の中央値をとる方法)で求めるものとして、中央値・第1四分位数・第3四分位数・四分位範囲を求め、外れ値があるか判定してください。 解答 中央値は6番目の34と7番目の36の平均で \(35\) です。下半分(22〜34)の中央値は28と30の平均で \(Q_1=29\)、上半分(36〜78)の中央値は40と42の平均で \(Q_3=41\) となります。\[IQR=Q_3-Q_1=41-29=12\]
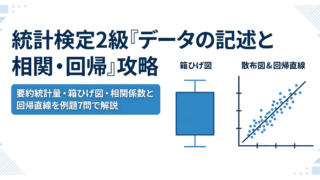
外れ値の上限は \(Q_3+1.5\times IQR=41+1.5\times12=59\)、下限は \(Q_1-1.5\times IQR=29-18=11\) です。\(78\) は上限を超えるため、外れ値と判定されます。箱ひげ図では、箱の両端が \(Q_1\) と \(Q_3\)、箱の中の線が中央値、上限を超えた点が個別に打たれる形になります。 検算 \(Q_1=29\) <中央値 \(35\) < \(Q_3=41\) の順序が成り立ち、78以外の値はすべて11〜59の範囲内です。 Rで答え合わせをします。# 例題2:四分位数と外れ値の判定
visitors <- c(22, 25, 28, 30, 32, 34, 36, 38, 40, 42, 45, 78)
fv <- fivenum(visitors)
fv
iqr_x <- fv[4] - fv[2]
upper_fence <- fv[4] + 1.5 * iqr_x
c(IQR = iqr_x, upper_fence = upper_fence)
quantile(visitors, probs = c(0.25, 0.75))
[1] 22 29 35 41 78
        IQR upper_fence
         12          59
 25%  75%
29.5 40.5
⚠️ 注意
四分位数の求め方には流儀があります。Rの quantile() の既定の計算方法では \(Q_1=29.5\)、\(Q_3=40.5\) となり、本記事のヒンジ法とは少しずれるため、答え合わせには fivenum() を使います。試験でも、採用されている定義に沿って上下半分の中央値をとる手順を確実に再現することが大切です。
四分位数の求め方には流儀があります。Rの quantile() の既定の計算方法では \(Q_1=29.5\)、\(Q_3=40.5\) となり、本記事のヒンジ法とは少しずれるため、答え合わせには fivenum() を使います。試験でも、採用されている定義に沿って上下半分の中央値をとる手順を確実に再現することが大切です。
📝 解釈・補足
78人は、通常の来客数(最大でも45人)の範囲を大きく外れています。ただし外れ値は「除外してよい値」ではなく、イベントなど原因を確認すべき値です。来院件数や検査件数の集計でも、まず箱ひげ図でこうした日を見つけることが実務の第一歩になります。
78人は、通常の来客数(最大でも45人)の範囲を大きく外れています。ただし外れ値は「除外してよい値」ではなく、イベントなど原因を確認すべき値です。来院件数や検査件数の集計でも、まず箱ひげ図でこうした日を見つけることが実務の第一歩になります。
中心と散らばりの活用と時系列 ― 標準化・変動係数・成長率
平均と標準偏差は、そのまま比べるだけでなく、標準化して「集団の中の位置」に直したり、平均で割って「相対的なばらつき」に直したりして活用します。どちらも、条件の異なる数値を同じ物差しに載せ替える工夫です。時系列データでは、変化率の平均の取り方が論点になります。例題3 標準化と変動係数で相対的な位置とばらつきを比べる
問題 (1) ある受験者の得点は英語85点(受験者全体の平均70点・標準偏差10点)、数学78点(平均64点・標準偏差7点)です。どちらの科目のほうが相対的に良い成績か、Z得点と偏差値で比べてください。(2) 2つの測定法A(平均50・標準偏差5)とB(平均20・標準偏差3)では、相対的なばらつきが大きいのはどちらか、変動係数で比べてください。 解答 (1) 平均も標準偏差も異なる科目どうしは、素点では比べられません。平均からのずれを標準偏差で割る標準化を使います。\[Z=\frac{x-\bar{x}}{s}\]
英語は \(Z=(85-70)/10=1.5\) で、偏差値は \(50+10\times1.5=65\) です。数学は \(Z=(78-64)/7=2.0\) で、偏差値は \(50+10\times2.0=70\) です。素点は英語が高いものの、集団の中の位置では数学のほうが上になります。標準化した値は平均0・標準偏差1になるため、単位や分布が異なるデータでも位置を直接比べられます。(2) 単位や平均の異なる測定どうしのばらつきは、標準偏差を平均で割った変動係数で比べます。Aは \(5/50=0.10\)、Bは \(3/20=0.15\) です。標準偏差そのものはAが大きいですが、相対的なばらつきはBが大きくなります。 検算 偏差値はZ得点に10を掛けて50を足したものなので、Zが大きい数学のほうが偏差値も大きくなります。 Rで答え合わせをします。# 例題3:標準化(Z得点・偏差値)と変動係数
z_eng <- (85 - 70) / 10
z_math <- (78 - 64) / 7
round(c(Z_eng = z_eng, T_eng = 50 + 10 * z_eng,
Z_math = z_math, T_math = 50 + 10 * z_math), 4)
round(c(CV_A = 5 / 50, CV_B = 3 / 20), 4)
 Z_eng  T_eng Z_math T_math
   1.5   65.0    2.0   70.0
CV_A CV_B
0.10 0.15
📝 解釈・補足
英語のZ得点1.5(偏差値65)に対し数学は2.0(偏差値70)で、相対的には数学が良い成績です。変動係数はAの0.10に対しBが0.15で、平均の小さいBのほうが相対的にばらつきます。製薬実務でも、平均の水準が異なる検査項目のばらつきを比べるときは、標準偏差ではなく変動係数で比較するのが基本です。本番では「標準偏差が大きい=ばらつきが大きい」と即断しないことが大切です。
英語のZ得点1.5(偏差値65)に対し数学は2.0(偏差値70)で、相対的には数学が良い成績です。変動係数はAの0.10に対しBが0.15で、平均の小さいBのほうが相対的にばらつきます。製薬実務でも、平均の水準が異なる検査項目のばらつきを比べるときは、標準偏差ではなく変動係数で比較するのが基本です。本番では「標準偏差が大きい=ばらつきが大きい」と即断しないことが大切です。
例題4 成長率の平均を幾何平均で求める
問題 ある指標が3年間で+10%、+25%、−20%と変化しました。年平均の成長率を幾何平均で求め、算術平均と比べてください。あわせて、初年度を100とした3年後の指数を求めてください。 解答 成長率は「掛け算」で積み上がるため、平均も掛け算に対応した幾何平均で求めます。各年の変化を倍率に直すと1.10、1.25、0.80で、その積は \(1.10\times1.25\times0.80=1.10\) です。\[\left(1.10\times1.25\times0.80\right)^{1/3}-1=\left(1.10\right)^{1/3}-1=0.0323\]
年平均の成長率は3.23%です。一方、算術平均は \((10+25-20)/3=5\%\) で、3年間続ければ \(1.05^3=1.158\) 倍となり、実際の1.10倍と合いません。3年後の指数は \(100\times1.10=110\) です。 検算 幾何平均3.23%で3年続けると \(1.0323^3\) はほぼ1.10となり、倍率の積と一致します。 Rで答え合わせをします。# 例題4:成長率の平均(幾何平均と算術平均)
growth <- c(0.10, 0.25, -0.20)
geo_mean <- prod(1 + growth)^(1 / length(growth)) - 1
round(c(geo_mean = geo_mean, arith_mean = mean(growth)), 4)
  geo_mean arith_mean
    0.0323     0.0500
📝 解釈・補足
幾何平均は0.0323(3.23%)、算術平均は0.0500(5%)で、算術平均のほうが大きく出ます。成長率や増加率の平均には幾何平均を使うのが試験の定番のひっかけです。来院件数や処方量の年次推移を評価する実務でも、年平均の伸びは同じ考え方で求めます。
幾何平均は0.0323(3.23%)、算術平均は0.0500(5%)で、算術平均のほうが大きく出ます。成長率や増加率の平均には幾何平均を使うのが試験の定番のひっかけです。来院件数や処方量の年次推移を評価する実務でも、年平均の伸びは同じ考え方で求めます。
散布図と相関 ― 相関係数を計算する
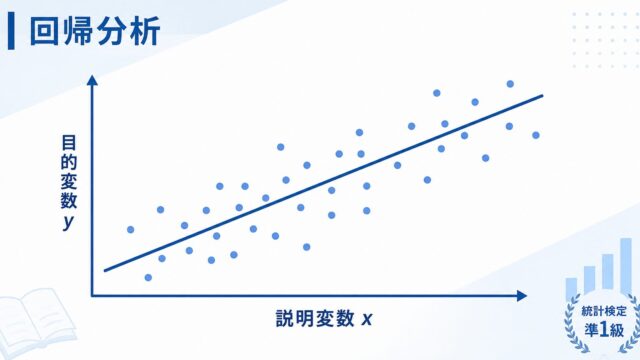
2つの変数の関係は、散布図で全体の形を確かめてから、相関係数で強さと向きを数値化します。ここでは偏差の積和から相関係数を組み立てる計算を押さえます。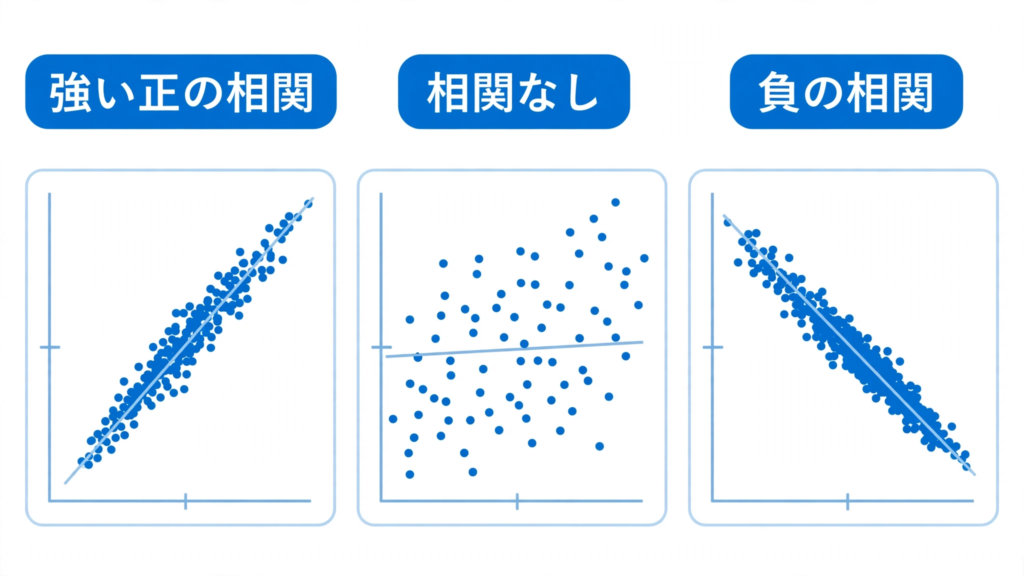
例題5 偏差積和から相関係数を求める
問題 5人の勉強時間 \(x\)(時間)とテスト得点 \(y\)(点)が次の表のとおりです。相関係数 \(r\) を求めてください。| 人 | 勉強時間 \(x\) | テスト得点 \(y\) |
|---|---|---|
| 1 | 1 | 50 |
| 2 | 2 | 45 |
| 3 | 3 | 65 |
| 4 | 4 | 60 |
| 5 | 5 | 80 |
\[r=\frac{S_{xy}}{\sqrt{S_{xx}S_{yy}}}=\frac{75}{\sqrt{10\times750}}=\frac{75}{86.60}=0.866\]
検算 \(r\) は \(-1\) から \(1\) の範囲にあり、正の \(S_{xy}\) と符号も一致します。 Rで答え合わせをします。# 例題5:散布図のデータから相関係数を求める
x <- 1:5
y <- c(50, 45, 65, 60, 80)
Sxy <- sum((x - mean(x)) * (y - mean(y)))
Sxx <- sum((x - mean(x))^2)
Syy <- sum((y - mean(y))^2)
round(c(Sxy = Sxy, Sxx = Sxx, Syy = Syy,
r = Sxy / sqrt(Sxx * Syy), cor = cor(x, y)), 4)
    Sxy     Sxx     Syy       r     cor
 75.000  10.000 750.000   0.866   0.866
📝 解釈・補足
\(r=0.866\) は強い正の相関を示し、勉強時間が長い人ほど得点が高い傾向があります。ただし、これは2変数が一緒に動くという関係の強さであり、「勉強時間が得点を押し上げた」という因果関係まで証明するものではありません。
\(r=0.866\) は強い正の相関を示し、勉強時間が長い人ほど得点が高い傾向があります。ただし、これは2変数が一緒に動くという関係の強さであり、「勉強時間が得点を押し上げた」という因果関係まで証明するものではありません。
⚠️ 注意
第3の変数が両方に影響すると、直接の関係がなくても強い相関が現れる「みかけの相関」が起こります。相関は因果を意味しない、という一文は本番でも実務でも繰り返し問われる要点です。また、外れ値が1点あるだけで相関係数が大きく動くこともあるため、散布図で点の散らばりを確かめてから解釈することが大切です。
第3の変数が両方に影響すると、直接の関係がなくても強い相関が現れる「みかけの相関」が起こります。相関は因果を意味しない、という一文は本番でも実務でも繰り返し問われる要点です。また、外れ値が1点あるだけで相関係数が大きく動くこともあるため、散布図で点の散らばりを確かめてから解釈することが大切です。
単回帰と予測 ― 回帰直線と決定係数
散布図で関係が見えたら、次は直線で表して予測に使います。最小二乗法は、各点の残差(実測値と予測値の差)の二乗和が最も小さくなる直線を選ぶ方法です。本番では、生データから求める形と、要約統計量だけから求める形の両方が出ますので、順に確認します。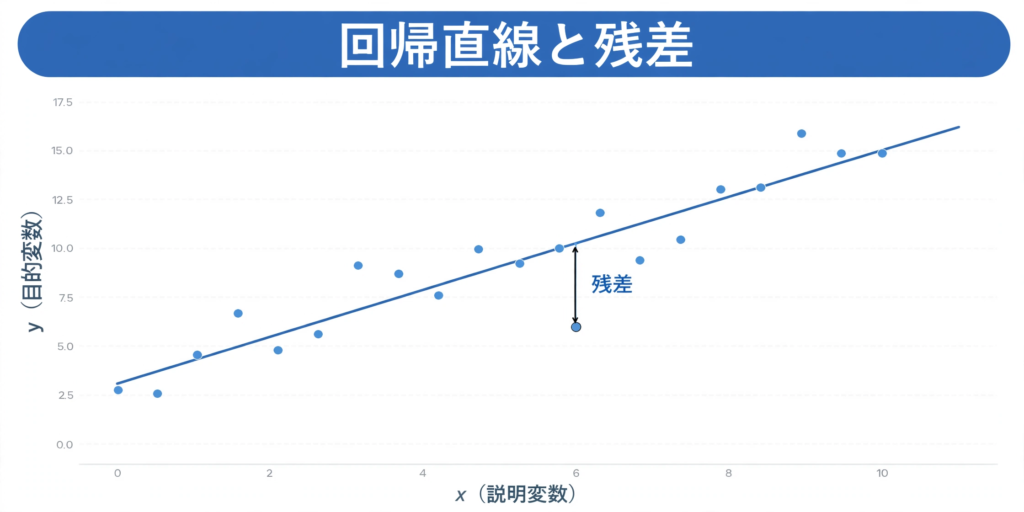
例題6 生データから回帰直線と予測値を求める
問題 例題5と同じ5人のデータ(勉強時間 \(x\)、得点 \(y\))について、すでに \(\bar{x}=3\)、\(\bar{y}=60\)、\(S_{xy}=75\)、\(S_{xx}=10\)、\(r=0.866\) が分かっています。回帰直線を求め、決定係数 \(R^2\) と勉強時間6時間のときの予測値、あわせて \(x=3\) の人の残差を求めます。 解答 ①傾きは偏差積和を \(x\) の偏差平方和で割り、切片は「回帰直線は \((\bar{x},\bar{y})\) を通る」ことから求めます。\[a=\frac{S_{xy}}{S_{xx}}=\frac{75}{10}=7.5\]
②切片は \(b=\bar{y}-a\bar{x}=60-7.5\times3=37.5\) です。回帰直線は \(\hat{y}=37.5+7.5x\) になります。③決定係数は \(R^2=r^2=0.866^2=0.75\) です。④予測値は \(x=6\) を代入して \(37.5+7.5\times6=82.5\) 点、残差は \(x=3\) の予測値が \(37.5+7.5\times3=60\) 点なので、実測65点との差で \(65-60=5\) 点です。 検算 \(x=3\) の実測は直線の上側にあるため残差は正になり、符号が合います。 Rで答え合わせ# 例題6:最小二乗法による回帰直線と予測
x <- 1:5
y <- c(50, 45, 65, 60, 80)
slope <- sum((x - mean(x)) * (y - mean(y))) / sum((x - mean(x))^2)
intercept <- mean(y) - slope * mean(x)
model <- lm(y ~ x)
round(c(intercept = intercept, slope = slope,
R2 = summary(model)$r.squared,
pred_x6 = intercept + slope * 6), 4)
intercept     slope        R2   pred_x6
    37.50      7.50      0.75     82.50
📝 解釈・補足
傾き7.5は、勉強時間が1時間増えると予測得点が7.5点上がることを表します。\(R^2=0.75\) は、得点のばらつきの75%が勉強時間で説明できるという意味です。ただし予測82.5点は、観測範囲(1〜5時間)のすぐ外側の値です。範囲から大きく離れた予測ほど当てにならない点は、例題7でも確認します。
傾き7.5は、勉強時間が1時間増えると予測得点が7.5点上がることを表します。\(R^2=0.75\) は、得点のばらつきの75%が勉強時間で説明できるという意味です。ただし予測82.5点は、観測範囲(1〜5時間)のすぐ外側の値です。範囲から大きく離れた予測ほど当てにならない点は、例題7でも確認します。
例題7 要約統計量から回帰直線を求める
問題 ある調査で \(n=20\)、\(\bar{x}=5\)、\(\bar{y}=40\)、\(x\) の標準偏差 \(s_x=2\)、\(y\) の標準偏差 \(s_y=10\)、相関係数 \(r=0.6\) が分かっています。回帰直線を求め、\(x=8\) のときの予測値と決定係数を求めます。 解答 ①生データが手元になくても、傾きは相関係数と標準偏差の比から求められます。\[a=r\times\frac{s_y}{s_x}=0.6\times\frac{10}{2}=3\]
②切片は \(b=\bar{y}-a\bar{x}=40-3\times5=25\) です。回帰直線は \(\hat{y}=25+3x\) になります。③予測値は \(x=8\) を代入して \(25+3\times8=49\)、決定係数は \(R^2=0.6^2=0.36\) です。 検算 直線に \((\bar{x},\bar{y})=(5,40)\) を代入すると \(25+3\times5=40\) となり、平均の点を通ることが確認できます。 Rで答え合わせ# 例題7:要約統計量から回帰直線を求める
r <- 0.6; sx <- 2; sy <- 10; xbar <- 5; ybar <- 40
slope7 <- r * sy / sx
intercept7 <- ybar - slope7 * xbar
round(c(slope = slope7, intercept = intercept7,
pred_x8 = intercept7 + slope7 * 8, R2 = r^2), 4)
    slope intercept   pred_x8        R2
     3.00     25.00     49.00      0.36
📝 解釈・補足
\(R^2=0.36\) ですので、\(y\) のばらつきのうち \(x\) で説明できるのは36%にとどまります。傾き3と相関係数0.6は別の量ですので、取り違えないでください。また要約統計量だけでは \(x\) の観測範囲が分かりません。\(x=8\) が範囲の外にある可能性を考えると、外挿した予測は根拠が弱くなります。用量と反応の関係でも、観測した用量の範囲を超えた予測は慎重に扱います。
\(R^2=0.36\) ですので、\(y\) のばらつきのうち \(x\) で説明できるのは36%にとどまります。傾き3と相関係数0.6は別の量ですので、取り違えないでください。また要約統計量だけでは \(x\) の観測範囲が分かりません。\(x=8\) が範囲の外にある可能性を考えると、外挿した予測は根拠が弱くなります。用量と反応の関係でも、観測した用量の範囲を超えた予測は慎重に扱います。
試験本番で差がつくポイント ― 要約の選び方と典型的な間違い
最後に、記事全体を通した落とし穴を整理します。典型的な間違いは、公式の当てはめ先の間違いです。- 要約の選び方:右に裾を引く分布や外れ値があるデータでは、平均は大きな値に引っ張られます。中心は中央値、散らばりは四分位範囲が向きます。左右対称に近い分布では平均と標準偏差が向きます
- 分散の分母:データそのものの分散は分母が \(n\)、標本から母分散を推定する不偏分散は分母が \(n-1\) です。問題文がどちらを求めているかを先に確認します
- 四分位数:求め方には流儀があります。本記事のヒンジ法と、Rの quantile() の既定では値がずれますので、試験では中央値で上下に分ける手順を手で再現できるようにしておきます
- 標準化と変動係数:単位も平均も違う得点同士の比較はZ得点、平均が違う測定法の相対的なばらつきの比較は変動係数で判断します
- 成長率の平均:率の変化を重ねる場合は幾何平均を使います。算術平均で代用すると、実際の伸びより大きく見積もってしまいます
- 相関の読み方:相関係数は直線的な関係の強さを示すだけで、因果関係は示しません。外れ値や層別の有無で値が変わる、みかけの相関にも注意します
- 回帰の読み方:傾きと相関係数は別の量で、単回帰では \(R^2=r^2\) が成り立ちます。予測は観測範囲の中で行い、残差が特定の点に偏っていないかも確認します
🔑 まとめ・実務ポイント
本番では、計算に入る前に「中心を聞かれているのか、散らばりを聞かれているのか、関係と予測を聞かれているのか」を見分けます。そのうえで、選んだ指標の定義どおりに途中式を書くと、取り違えの多くは防げます。この見分け方は、臨床試験で検査値の分布を見て要約方法を選ぶ場面でも、そのまま役に立ちます。
本番では、計算に入る前に「中心を聞かれているのか、散らばりを聞かれているのか、関係と予測を聞かれているのか」を見分けます。そのうえで、選んだ指標の定義どおりに途中式を書くと、取り違えの多くは防げます。この見分け方は、臨床試験で検査値の分布を見て要約方法を選ぶ場面でも、そのまま役に立ちます。
📚 この記事をより深く理解するための参考書籍
データの要約と相関・回帰は「公式テキストで定義と公式を確認する」「過去の出題形式で手を慣らす」「理論の土台を固める」の3段階で学ぶと定着します。その3段階に対応する書籍を1冊ずつ選びました。 確率分布は「公式テキストで定義と公式を確認する」「過去の出題形式で手を慣らす」「理論の土台を固める」の3段階で学ぶと定着します。その3段階に対応する書籍を1冊ずつ選びました。
『改訂版 日本統計学会公式認定 統計検定2級対応 統計学基礎』日本統計学会 編(東京図書、2015年)

日本統計学会が編集した2級対応の公式テキストです。データの記述(代表値・散らばり・四分位数)、相関係数、回帰分析の定義・公式を2級の水準で体系的に確認できます。本記事の例題で「なぜこの公式になるのか」で手が止まったときに、該当する章へ戻る使い方がおすすめです。出題範囲は改訂されることがあるため、最新の範囲は公式サイトとあわせて確認してください。
統計検定2級公式問題集 日本統計学会公式認定

CBT方式の出題範囲と形式に沿った問題と解説を収録した公式問題集です。本記事で計算の流れをつかんだら、次は4〜5肢選択の形で、制限時間内に要約統計量を見分けて計算する練習が必要です。分散の分母の取り違えや、成長率に算術平均を使ってしまうといった本記事の「典型的な間違い」を、実際の問題で確かめるのに最適です。
『統計学入門(基礎統計学Ⅰ)』東京大学教養学部統計学教室 編(東京大学出版会)

記述統計から相関・回帰分析までを、定義に立ち返って積み上げて説明する定番書です。最小二乗法や決定係数が「なぜ成り立つのか」を一度理解しておくと、公式を忘れても平均と偏差の関係から再現できるようになります。2級合格後に準1級へ進む方にとっても土台になる一冊です。
生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
- 統計検定2級「仮説検定・区間推定」攻略 ― t検定・カイ二乗検定・p値の典型出題を例題7問で解説 ―
- 統計検定2級「確率分布」攻略 ― 二項・ポアソン・正規分布と標本分布の典型出題を例題7問で解説 ―
- 統計検定2級の勉強法
- 平均値と中央値の違いとは?外れ値・歪んだ分布での使い分けをやさしく解説
- 回帰分析と相関の違い|因果を見抜くための基礎と実務
- データ可視化の中級:箱ひげ図・バイオリンプロット・散布図行列の読み方