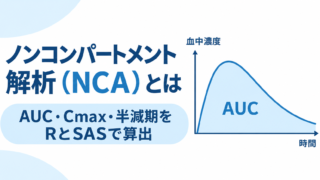
ノンコンパートメント解析(NCA)とは ― AUC・Cmax・半減期をRとSASで算出する薬物動態解析入門 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- ノンコンパートメント解析(NCA)とは何か、コンパートメントモデルとの違い
- AUC・Cmax・Tmax・半減期・クリアランスの定義と計算式
- Rの組み込みデータを使ったNCAの手計算と、外挿率が20%を超える例
- PKNCAパッケージによる全例解析と、手計算とのQC(突き合わせ)
- SASでの実装と、実務で解析計画に書くべきこと
はじめに
新薬の開発では、臨床試験のフェーズ(第I相〜第IV相)とはで整理したとおり、第I相試験で初めてヒトに薬を投与します(用量の決め方は第I相がん臨床試験の用量探索デザインを参照)。このとき、薬が血中でどのくらいの濃度になり、どのくらいで消えるのかを必ず調べます。この「血中濃度の時間推移」を扱う分野が薬物動態(PK)で、その標準的な解析方法がノンコンパートメント解析(NCA)です。
ジェネリック医薬品の生物学的同等性試験(BE)でも、評価の中心は NCA で求める AUC と Cmax です。生物統計担当者や統計プログラマーは、NCAの結果を要約・解析する立場になることが多いため、中身を知っておくと仕事の質が大きく変わります。
この記事は、薬物動態は初めてという方に向けて、計算式、Rの手計算、PKNCAパッケージ、SASの順に、手を動かしながら理解できるよう構成しました。t検定や回帰分析、対数変換を知っていれば十分に読めます。
ノンコンパートメント解析(NCA)とは ― 薬物動態パラメータの定義と計算式
コンパートメントモデルを使わない「モデル非依存」の解析
薬物動態(PK:pharmacokinetics)とは、投与された薬が体内でどう吸収・分布・代謝・排泄されるか(ADME)を、血中濃度の時間推移から調べる分野です。「体が薬に何をするか」を表します。
ノンコンパートメント解析(NCA)は、体をいくつかの箱(コンパートメント)に分けたモデルを仮定せず、観測された血中濃度そのものから台形法などでパラメータを計算する方法です。モデルに依存しないので「モデル非依存」の解析と呼ばれます。計算が単純で再現性が高く、第I相試験、食事の影響を調べる試験、薬物相互作用試験、BE試験などで標準的に使われます。
一方、コンパートメントモデルは体を1〜数個の箱で表す微分方程式モデルを当てはめる方法で、母集団薬物動態(PopPK)解析は、多くの被験者のまばらな採血データを非線形混合効果モデルで解析し、体重や腎機能などの影響を調べます。違いを表にまとめます。
| 観点 | NCA | コンパートメントモデル・PopPK解析 |
|---|---|---|
| モデルの仮定 | 体のモデルは置かない(終末相で一次消失のみ仮定) | 体を1〜数個の箱で表すモデルを当てはめる |
| 必要な採血 | 1人ひとりの密な採血データ | PopPKでは、まばらな採血でも多数の被験者を併せて解析できる |
| 主な用途 | 第I相試験、BE試験、食事の影響・薬物相互作用試験 | 背景因子の影響の評価、投与方法の検討 |
| 得られるもの | AUC・Cmaxなどの要約パラメータ | 体重などの影響と、個人ごとの予測 |
NCAが置いている主な仮定は、終末相(濃度が下がりきる最後の局面)で濃度が指数関数的に減る、つまり対数をとると直線になる(一次消失)ことです。なお、PKは民族差の評価でも使われます。詳しくはICH E5(外国臨床データの受け入れ)とはをご覧ください。
主な薬物動態パラメータと計算式
NCAで求める主なパラメータは次の8つです。
| パラメータ | 意味 | 求め方 |
|---|---|---|
| Cmax | 最高血中濃度 | 観測値の最大値 |
| Tmax | Cmaxに到達した時間 | Cmaxを示した観測時点 |
| AUC0-t | 時間0から最後に測れた時点までの濃度−時間曲線下面積(曝露量の指標) | 台形法で面積を足し合わせる |
| λz | 終末相の消失速度定数 | log(濃度)を時間に回帰した直線の傾きの符号を反転 |
| t1/2 | 消失半減期(濃度が半分になるまでの時間) | ln 2 ÷ λz |
| AUC0-∞ | 無限大時間までのAUC | AUC0-t + 最後の濃度 ÷ λz |
| 外挿率 | AUC0-∞のうち外挿で足した部分の割合 | 下の式を参照 |
| CL/F | 見かけの全身クリアランス | 投与量 ÷ AUC0-∞ |
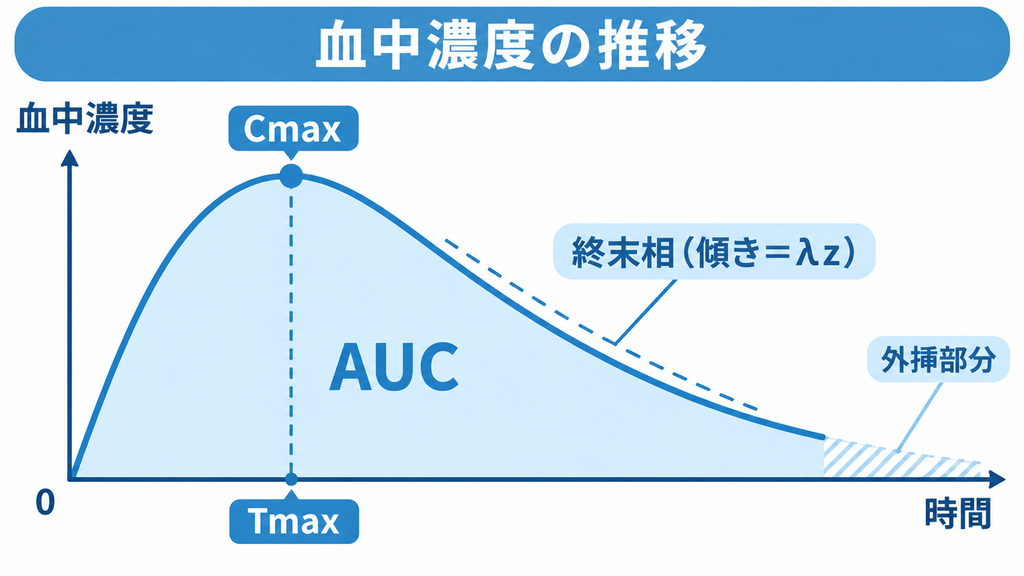
AUC0-t は、隣り合う採血点を直線で結んでできる台形の面積を足し合わせる線形台形法で求めます。
\[ \mathrm{AUC}_{0\text{-}t}=\sum_{i=1}^{n-1}\frac{(t_{i+1}-t_i)(C_i+C_{i+1})}{2} \]
ここで \(t_i\) は i 番目の採血時刻、\(C_i\) はそのときの濃度、\(n\) は採血点の数です。
\[ \ln C(t)=a-\lambda_z t,\qquad t_{1/2}=\frac{\ln 2}{\lambda_z} \]
終末相では対数濃度が時間に対して直線で下がり、その傾きの大きさが \(\lambda_z\) です。
\[ \mathrm{AUC}_{0\text{-}\infty}=\mathrm{AUC}_{0\text{-}t}+\frac{C_{\text{last}}}{\lambda_z},\qquad \mathrm{CL/F}=\frac{\text{Dose}}{\mathrm{AUC}_{0\text{-}\infty}} \]
\(C_{\text{last}}\) は最後に測れた濃度です。外挿率は \(100\times(\mathrm{AUC}_{0\text{-}\infty}-\mathrm{AUC}_{0\text{-}t})/\mathrm{AUC}_{0\text{-}\infty}\) で計算します。経口投与では投与量のうち全身循環に届く割合 F が分からないため、「見かけの」クリアランスとして CL/F と書きます。同様に、見かけの分布容積 Vz/F は CL/F ÷ λz で求めます。
AUC・Cmax・CL/F は右に裾を引く(対数正規分布に近い)ことが多いため、幾何平均と幾何変動係数で要約します。一方、Tmax は観測時点のとびとびの値なので、平均値と中央値の違いで説明した中央値と範囲で要約するのが一般的です。
Cmax と Tmax は観測された点そのものなので、採血時刻の設定に強く依存します。真の最高濃度が採血と採血の間にあれば、見逃してしまいます。
ここまでのまとめ
- NCAはモデルを仮定せず、観測濃度から台形法などでパラメータを計算する方法
- AUC0-t は台形法、半減期は終末相の回帰、AUC0-∞ は AUC0-t に Clast ÷ λz を足して求める
- AUC・Cmax は幾何平均、Tmax は中央値で要約する
RでNCAを手計算する ― AUC・Cmax・半減期を1例で求める
専用パッケージを使う前に、1人分のデータで計算式どおりに手を動かしてみましょう。パラメータの意味と落とし穴が、パッケージ任せでは見えない形で分かります。使うのはRに最初から入っているデータ Theoph です。12人にテオフィリンを経口で1回投与し、約25時間にわたって血清中濃度を測ったもので、濃度の単位は mg/L、時間は h です。したがって AUC は mg·h/L、λz は 1/h、CL/F は L/h になります。
血中濃度推移データを確認する
まず被験者1のデータを取り出します。Rが初めての方は、先にR入門の記事をご覧ください。
d <- as.data.frame(Theoph)              # Rの組み込みデータ:テオフィリン経口投与12例
d$Subject <- as.character(d$Subject)
d$DoseMg  <- d$Dose * d$Wt              # 体重あたり投与量(mg/kg) × 体重(kg) → 投与量(mg)
s1 <- d[d$Subject == "1", c("Time", "conc")]
s1
    Time  conc
1   0.00  0.74
2   0.25  2.84
3   0.57  6.57
4   1.12 10.50
5   2.02  9.66
6   3.82  8.58
7   5.10  8.36
8   7.03  7.47
9   9.05  6.89
10 12.12  5.94
11 24.37  3.28
被験者1は11時点で採血されています。濃度は1.12時間で最大の 10.50 mg/L に達し、その後ゆっくり下がって、最後の24.37時間で 3.28 mg/L です。投与前(時間0)の濃度が 0.74 と0ではない点は、このデータの特徴です。
DoseMg は体重あたり投与量に体重を掛けて投与量(mg)にしたもので、後でクリアランスの計算に使います。縦軸を対数にした片対数グラフで描くと、後半の濃度は右下がりの直線に見えます。これが「終末相では濃度が指数関数的に減る」という意味です。台形法でAUCを求め、終末相から半減期を推定する
Cmax・Tmax・AUC0-t を求め、終末相の3点で回帰して λz と半減期を出します。
tm <- s1$Time; cc <- s1$conc
cmax <- max(cc)                                          # 最高血中濃度
tmax <- tm[which.max(cc)]                                # 最高血中濃度到達時間
auc_t <- sum(diff(tm) * (head(cc, -1) + tail(cc, -1)) / 2)  # 線形台形法によるAUC0-t
fit <- lm(log(cc) ~ tm, subset = tm >= 9)                # 終末相:最後の3点で log(濃度) を時間に回帰
lz  <- unname(-coef(fit)[2])                             # 消失速度定数 λz(傾きの符号を反転)
auc_inf <- auc_t + tail(cc, 1) / lz                      # AUC0-∞ = AUC0-t + Clast / λz
round(c(Cmax = cmax, Tmax = tmax, AUC0t = auc_t, lambda_z = lz,
        t_half = log(2) / lz, AUC0inf = auc_inf,
        extrap_pct = 100 * (auc_inf - auc_t) / auc_inf), 3)
      Cmax       Tmax      AUC0t   lambda_z     t_half    AUC0inf extrap_pct
    10.500      1.120    148.923      0.048     14.304    216.612     31.249
diff(tm) は隣り合う時点の時間差、head(cc, -1) と tail(cc, -1) は各区間の始まりと終わりの濃度です。台形の面積(上底+下底)×高さ÷2 を全区間で合計しています。終末相は subset = tm >= 9 で最後の3点(9.05・12.12・24.37時間)を選び、lm() で log(濃度) を時間に回帰しました。log() は自然対数です。回帰の読み方は線形回帰の“本質”をつかむで確認できます。
- Cmax は 10.5 mg/L、Tmax は 1.12時間、AUC0-t は 148.923 mg·h/L です。
- λz は 0.048(1/h)、半減期は 14.304時間 です。
- AUC0-∞ は 216.612 mg·h/L、外挿率は 31.249% で、目安の20%を大きく超えます。AUC0-∞ の約3割を、観測していない部分の外挿に頼っていることになります。
- 原因は採血の打ち切りです。最終採血の24.37時間は、半減期14.304時間の約1.7倍しかありません。終末相に使った3点の時間幅(9.05〜24.37時間の15.32時間)も半減期の約1.1倍で、傾きの推定が不安定になりやすい状況です。
- 実務上は、採血計画の段階で、想定される半減期の数倍の時間まで採血を続ける必要があります。
線形台形法と線形アップ/対数ダウン法の違い
線形台形法は、濃度が下がる区間でも点と点を直線で結びます。実際の濃度は指数関数的に下がるので、直線は曲線より上を通り、面積はわずかに大きくなります。そこで、濃度が上がる区間は線形台形、下がる区間は対数台形(対数をとると直線になるとみなす)で計算するのが線形アップ/対数ダウン法です。PKNCAの既定もこの方法です。
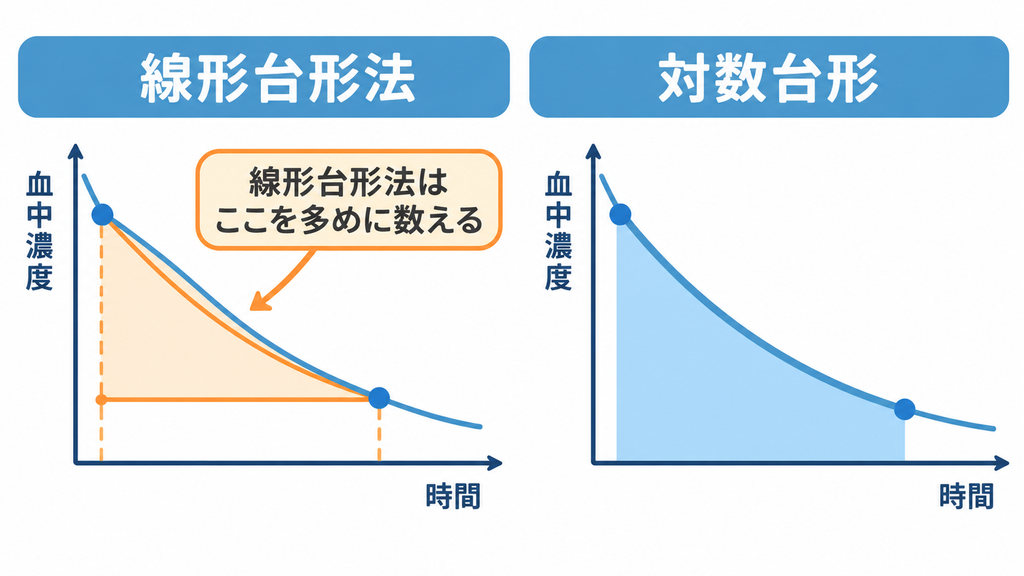
対数台形の面積は次の式で求めます。
\[ \text{対数台形の面積}=\frac{(t_{i+1}-t_i)(C_i-C_{i+1})}{\ln(C_i/C_{i+1})} \]
\(C_i\) から \(C_{i+1}\) へ指数関数的に下がるとみなしたときの、区間の面積です。
# 線形アップ/対数ダウン法:濃度が下がる区間だけ対数台形で面積を計算する
c1 <- head(cc, -1); c2 <- tail(cc, -1); dt <- diff(tm)
seg <- ifelse(c2 < c1 & c2 > 0,
              dt * (c1 - c2) / log(c1 / c2),             # 下降区間:対数台形
              dt * (c1 + c2) / 2)                        # 上昇区間:線形台形
round(c(linear = sum(dt * (c1 + c2) / 2), linup_logdown = sum(seg)), 3)
       linear linup_logdown
      148.923       147.235
線形台形法は 148.923、線形アップ/対数ダウン法は 147.235 で、差は 1.688(約1.1%)です。特に採血間隔が広い区間(この例では12.12〜24.37時間)で差が出やすくなります。どちらの方法を使うかで結果が変わるため、解析計画書で事前に指定しておきましょう。
ここまでのまとめ
- 被験者1の手計算では Cmax 10.5 mg/L、AUC0-t 148.923 mg·h/L、半減期14.304時間でした。
- 外挿率は31.249%と20%を超え、原因は最終採血が半減期の約1.7倍で打ち切られたことです。
- AUCの計算方法で値が変わるため、線形台形法か線形アップ/対数ダウン法かを事前に決めます。
PKNCAパッケージで全例のNCAを実行する ― RとSASでの実装
手計算は理解には役立ちますが、実際の試験では数十〜数百人分を同じルールで計算します。Rでは、CRANで公開されているNCA用パッケージ PKNCA を使うと、12例の解析を数行で書けます。ここではまず12例を一括で解析し、最後に手計算と結果を突き合わせます。
Rでの実装
まず、12例をまとめて解析します。
library(PKNCA)                                                  # 初回のみ install.packages("PKNCA")
conc_obj <- PKNCAconc(d, conc ~ Time | Subject)                 # 濃度データ:濃度 ~ 時間 | 被験者
dose_obj <- PKNCAdose(d[d$Time == 0, ], DoseMg ~ Time | Subject) # 投与データ:投与量 ~ 投与時刻 | 被験者
iv <- data.frame(start = 0, end = Inf,                          # 0〜∞の区間で算出するパラメータを指定
                 cmax = TRUE, tmax = TRUE, auclast = TRUE, aucinf.obs = TRUE,
                 half.life = TRUE, aucpext.obs = TRUE, cl.obs = TRUE)
res <- pk.nca(PKNCAdata(conc_obj, dose_obj, intervals = iv))
summary(res)
出力です(パッケージ読み込み時のメッセージは省略しています)。
 start end  N     auclast        cmax               tmax   half.life aucinf.obs
     0 Inf 12 98.7 [22.5] 8.65 [17.0] 1.14 [0.630, 3.55] 8.18 [2.12] 115 [28.4]
 aucpext.obs      cl.obs
 13.8 [6.34] 2.74 [27.9]

Caption: auclast, cmax, aucinf.obs, cl.obs: geometric mean and geometric coefficient of variation; tmax: median and range; half.life, aucpext.obs: arithmetic mean and standard deviation; N: number of subjects
PKNCAは「濃度データ」「投与データ」「計算する区間とパラメータ」の3つを組み合わせて解析します。conc ~ Time | Subject は「濃度を時間に対して、被験者ごとに」という意味の式です。intervals で区間(0〜∞)と、計算したいパラメータ(TRUE にしたもの)を指定します。aucinf.obs の「obs」は、外挿に観測された最終濃度 Clast を使うという意味です(予測値を使う aucinf.pred もあります)。pk.nca() が計算を実行します。
- Caption(説明文)のとおり、AUC・Cmax・CL/F は幾何平均[幾何CV%]、Tmax は中央値[範囲]、半減期と外挿率は算術平均[標準偏差]で自動的に要約されています。AUC や Cmax は右に裾を引くため、対数をとって平均する幾何平均が使われます。
- 12例の AUC0-t の幾何平均は 98.7 mg·h/L(幾何CV 22.5%)、Cmax は 8.65 mg/L(17.0%)、Tmax の中央値は 1.14時間(範囲 0.63〜3.55時間)です。
- 半減期の平均は 8.18時間(SD 2.12)、AUC0-∞ の幾何平均は 115 mg·h/L(28.4%)、外挿率の平均は 13.8%(SD 6.34)、CL/F の幾何平均は 2.74 L/h(27.9%)です。
- この1行の要約表が、治験の総括報告書に載る「薬物動態パラメータの要約」の原型になります。
次に、被験者ごとの結果を見ます。
w <- as.data.frame(as.data.frame(res, out_format = "wide"))     # 被験者ごとに1行の横長形式
w <- w[order(as.numeric(w$Subject)), ]
data.frame(ID = w$Subject, Cmax = w$cmax, Tmax = w$tmax,
           AUClast = round(w$auclast, 1), AUCinf = round(w$aucinf.obs, 1),
           extrap = round(w$aucpext.obs, 1), t_half = round(w$half.life, 2),
           n_lz = w$lambda.z.n.points, CL_F = round(w$cl.obs, 2), row.names = NULL)
   ID  Cmax Tmax AUClast AUCinf extrap t_half n_lz CL_F
1   1 10.50 1.12   147.2  214.9   31.5  14.30    3 1.49
2   2  8.33 1.92    88.7   97.4    8.9   6.66    4 3.27
3   3  8.20 1.02    95.9  106.1    9.7   6.77    3 3.01
4   4  8.60 1.07   102.6  114.2   10.1   6.98    3 2.80
5   5 11.40 1.00   118.2  136.3   13.3   8.00    4 2.35
6   6  6.44 1.15    71.7   82.2   12.8   7.89    7 3.89
7   7  7.09 3.48    88.0  101.0   12.9   7.85    4 3.17
8   8  7.56 2.02    86.8  102.2   15.0   8.51    6 3.13
9   9  9.03 0.63    83.9   97.5   13.9   8.41    3 2.75
10 10 10.21 3.55   135.6  167.9   19.2   9.25    3 1.91
11 11  8.00 0.98    77.9   86.9   10.4   7.26    3 3.68
12 12  9.75 3.52   115.2  125.8    8.4   6.29    3 2.55
as.data.frame(res, out_format = "wide") で、被験者ごとに1行・パラメータごとに1列の表に変換し、被験者番号の順に並べ替えて主な列を取り出しました。n_lz は λz の推定に自動で選ばれた点の数です。PKNCAの既定では、調整済み決定係数が最大値から 0.0001 以内に収まる点の組合せのうち、最も多くの点を使うものが選ばれます。Cmax の点は含まれず、終末相の少なくとも3点が使われます。
- 被験者1は半減期 14.30時間・外挿率 31.5% で、他の11例(半減期 6.29〜9.25時間)から大きく外れています。CL/F も 1.49 L/h と12例で最も小さい値です。
- 外挿率が20%を超えたのは被験者1だけです。被験者10の 19.2% も目安に近い値です。
- λz に使う点の数は被験者ごとに 3〜7点 の範囲で自動選択されています(被験者6は7点)。
- 被験者1の AUClast 147.2 は、前章の線形アップ/対数ダウン法の手計算 147.235 と一致します(PKNCAの既定が線形アップ/対数ダウン法だからです)。AUCinf 214.9 が手計算の 216.612 と違うのは、AUCの計算方法の違いによります。
- こうした被験者を要約から除くかどうかは、データを見てから決めるのではなく、解析計画で事前に決めておきます。
最後に、要約表の読み方を整理します。
| パラメータ | 要約の仕方 | 12例の結果 |
|---|---|---|
| AUC0-t | 幾何平均[幾何CV%] | 98.7 mg·h/L[22.5%] |
| Cmax | 幾何平均[幾何CV%] | 8.65 mg/L[17.0%] |
| Tmax | 中央値[範囲] | 1.14時間[0.63〜3.55] |
| 半減期 | 算術平均[SD] | 8.18時間[2.12] |
| AUC0-∞ | 幾何平均[幾何CV%] | 115 mg·h/L[28.4%] |
| 外挿率 | 算術平均[SD] | 13.8%[6.34] |
| CL/F | 幾何平均[幾何CV%] | 2.74 L/h[27.9%] |
手計算とPKNCAの結果を突き合わせる
パッケージの結果が正しいかを確かめるには、独立に書いた計算と突き合わせます。被験者1について、手計算と同じ条件(線形台形法・最後の3点)をPKNCAで指定してみます。
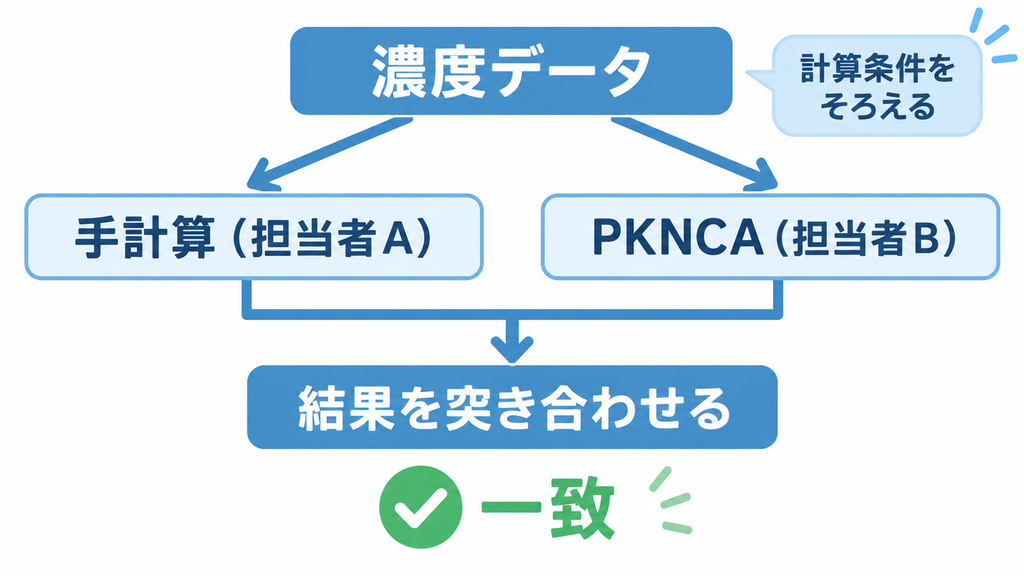
# 手計算(線形台形法・最後の3点)と同じ条件をPKNCAで指定して突き合わせる
d1 <- d[d$Subject == "1", ]
d1$use_lz <- d1$Time >= 9                                        # 終末相に使う点を明示
qc <- pk.nca(PKNCAdata(PKNCAconc(d1, conc ~ Time | Subject, include_half.life = "use_lz"),
                       PKNCAdose(d1[d1$Time == 0, ], DoseMg ~ Time | Subject),
                       intervals = data.frame(start = 0, end = Inf, auclast = TRUE,
                                              aucinf.obs = TRUE, half.life = TRUE),
                       options = list(auc.method = "linear")))
q <- as.data.frame(as.data.frame(qc, out_format = "wide"))
round(unlist(q[, c("auclast", "lambda.z", "half.life", "aucinf.obs")]), 3)
   auclast   lambda.z  half.life aucinf.obs
   148.923      0.048     14.304    216.612
include_half.life = "use_lz" で λz に使う点を手計算と同じ最後の3点に固定し、options = list(auc.method = "linear") で AUC を線形台形法に切り替えました。
- AUC0-t 148.923・λz 0.048・半減期 14.304・AUC0-∞ 216.612 の4つが、前章の手計算と完全に一致しました。
- 計算条件(AUCの計算方法・λz の点の選び方)をそろえれば、独立に書いたプログラムどうしで結果が一致します。これがダブルプログラミングによるQCの考え方です。
- 結果が食い違ったときは、まず「AUCの計算方法」「λz の点」「BLQの扱い」「実測時間か計画時間か」の4点を確認します。
BE試験で得た AUC と Cmax は、対数変換したうえでクロスオーバー試験として解析します。詳しくはクロスオーバー試験の理論と実務をご覧ください。
ここまでのまとめ
- PKNCAは、濃度・投与・区間の3つを指定するだけで、12例のNCAを一括で実行し、幾何平均や中央値で自動的に要約します。
- 被験者ごとの結果を見ると、被験者1だけ外挿率が20%を超えており、要約から除くかどうかは解析計画で事前に決めます。
- 計算条件をそろえると、手計算とPKNCAの4つの値が完全に一致し、ダブルプログラミングによるQCになります。
SASでの実装
実務のNCAは Phoenix WinNonlin などの専用ソフトや、SASの社内マクロで行うことが多いのですが、計算の中身を理解するため、ここでは DATAステップと PROC REG で手計算と同じ処理(線形台形法・最後の3点で λz)を書きます。
/* R側で write.csv(d, "theoph.csv", row.names = FALSE) として書き出したデータを読み込む */
proc import datafile="theoph.csv" out=theoph dbms=csv replace;
run;

proc sort data=theoph;
  by subject time;
run;

/* Cmax・Tmax・線形台形法によるAUC0-t(被験者ごとに1行を出力) */
data auc;
  set theoph;
  by subject;
  retain cmax tmax;
  lagt = lag(time);
  lagc = lag(conc);
  if first.subject then do;
    auct = 0;
    cmax = conc;
    tmax = time;
  end;
  else do;
    auct + (time - lagt) * (conc + lagc) / 2;
    if conc > cmax then do;
      cmax = conc;
      tmax = time;
    end;
  end;
  if last.subject then do;
    clast = conc;
    output;
  end;
  keep subject dosemg cmax tmax auct clast;
run;

/* 終末相:各被験者の最後の3点を取り出す */
proc sort data=theoph out=desc;
  by subject descending time;
run;

data term;
  set desc;
  by subject;
  if first.subject then n = 0;
  n + 1;
  if n <= 3 and conc > 0;
  logc = log(conc);
run;

/* log(濃度) を時間に回帰し、傾きを OUTEST= のデータセットに保存する */
proc reg data=term outest=est noprint;
  by subject;
  model logc = time;
run;
quit;

/* λz・半減期・AUC0-∞・外挿率・CL/F を計算する */
data nca;
  merge auc est(keep=subject time rename=(time=slope));
  by subject;
  lambda_z = -slope;
  t_half   = log(2) / lambda_z;
  aucinf   = auct + clast / lambda_z;
  extrap   = 100 * (aucinf - auct) / aucinf;
  cl_f     = dosemg / aucinf;
run;

proc print data=nca noobs;
  var subject cmax tmax auct lambda_z t_half aucinf extrap cl_f;
run;
コードの読み方
PROC IMPORTで、Rから書き出したCSVファイルを読み込みます。BY処理の前にはPROC SORTで並べ替えが必要です。LAG()関数は1つ前の行の値を返します。FIRST.SUBJECT・LAST.SUBJECTはBY変数の各グループの最初・最後の行で1になる自動変数で、被験者が変わるところで AUC をリセットし、最後の行だけを出力しています。auct + 式;は合計ステートメント(sum statement)で、値を行をまたいで累積します(自動的に RETAIN されます)。- 終末相は、時間の降順に並べ替えて各被験者の先頭から3行(=最後の3点)を取り出しています。λz の点を調整済み決定係数で自動選択する処理はこのコードには含まれません(実務では専用ソフトやマクロで行います)。
PROC REGのOUTEST=オプションで回帰係数をデータセットに保存すると、説明変数timeの係数(傾き)がtimeという名前の変数に入ります。それをslopeに名前を変えて結合しています。PROC REGは対話型のプロシジャなのでQUIT;で終了します。
線形アップ/対数ダウン法にする場合は、濃度が下がる区間(conc < lagc)だけ台形の式を \(\Delta t\,(C_1-C_2)/\ln(C_1/C_2)\) に置き換えます。
なお、SASの出力をRの結果と突き合わせると、実装の検算(ダブルプログラミング)になります。
実務でのポイント ― 採血計画・BLQ・外挿率とNCAの品質管理
採血計画で結果の質が決まる
Cmax 付近は密に、終末相は想定される半減期の数倍まで採血します。本記事の被験者1は、最終採血が半減期の約1.7倍しかなく、外挿率が31.249%になりました。解析で後から救うことはできないので、計画段階の設計が重要です。
計算ルールを事前に決める
AUCの計算方法(線形台形法か線形アップ/対数ダウン法か)、λz に使う点の選び方、外挿率20%超の扱い、BLQ(定量下限未満)の扱い、実測時間を使うことは、解析計画書に書いておきます。詳しくは統計解析計画書(SAP)の書き方をご覧ください。
要約は幾何平均と幾何CV
AUC・Cmax は対数変換して扱います。BE試験の解析も対数スケールです。
QCとデータ標準
専用ソフトの結果を、独立に書いたプログラムで検算するのがダブルプログラミングです。濃度は SDTM の PC ドメイン、算出したパラメータは PP ドメインに格納します(CDISC標準(SDTM・ADaM)とは)。
PKの先にある解析
算出した濃度やパラメータは、濃度とQTc延長の関係を調べる解析や、用量反応の評価にもつながります(ICH E14とConcentration-QTcモデリング)。
NCAのチェックリストです。
- 採血は想定半減期の数倍まで続ける計画か
- AUCの計算方法と λz の点の選び方を事前に指定したか
- 外挿率が20%を超える被験者の扱いを決めたか
- BLQ と実測時間の扱いを決めたか
- 独立したプログラムで結果を突き合わせたか
📚 この記事をより深く理解するための参考書籍
薬物動態の考え方を、計算の背景から深めるための3冊を紹介します。



生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
NCAで求めたAUC・Cmaxを統計解析につなげたい方は、生物学的同等性試験(BE)とはで対数変換と90%信頼区間による同等性評価を、クロスオーバー試験の理論と実務でその土台となる試験デザインを確認できます。BE試験の症例数設計は非劣性試験と同等性試験における症例数設計が続きになります。
薬物濃度を使う応用解析に進みたい方は、ICH E14とConcentration-QTcモデリングとICH E14ガイドラインがおすすめです。用量と反応の関係はICH E4ガイドライン解説とMCP-Modで用量反応を解析するで扱っています。
第I相試験の解析全体を押さえたい方は、第I相がん臨床試験の用量探索デザインと、少数例の解析の注意点をまとめた症例数が少ないときの統計解析をあわせてご覧ください。
まとめ
本記事では、ノンコンパートメント解析(NCA)の計算式を整理したうえで、Rの組み込みデータ Theoph を使って手計算・PKNCAパッケージ・SASの順に実装しました。
被験者1の手計算では、Cmax 10.5 mg/L、AUC0-t 148.923 mg·h/L、半減期14.304時間、AUC0-∞ 216.612 mg·h/L が得られました。一方で外挿率は31.249%と目安の20%を大きく超えていました。最終採血が半減期の約1.7倍で打ち切られていたことが原因で、NCAの質は解析よりも採血計画で決まることがよく分かる例です。また、線形台形法(148.923)と線形アップ/対数ダウン法(147.235)でAUCが変わることも確かめました。
PKNCAパッケージでは、12例のNCAを数行で実行し、AUC0-t の幾何平均98.7 mg·h/L、Cmax の幾何平均8.65 mg/L、Tmax の中央値1.14時間といった要約を自動で得られました。さらに、手計算と同じ計算条件を指定すると4つの値が完全に一致し、ダブルプログラミングによるQCの考え方を実演できました。
NCAは計算こそ単純ですが、AUCの計算方法、λz の点の選び方、外挿率やBLQの扱いといったルールの違いが結果に直接表れます。これらを解析計画で事前に決め、独立したプログラムで検算することが、信頼できる薬物動態データを届けるための土台になります。第I相試験やBE試験の解析に関わる際の出発点として活用していただければと思います。