生存時間解析とは ― 打ち切り・生存関数・ハザード関数の基礎をRでやさしく解説【入門】

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
この記事では、次の5点がわかります。
- 生存時間解析とは何か、なぜ普通の平均や中央値ではだめなのか
- 打ち切りの種類と、無情報な打ち切りという大事な仮定
- 生存関数・ハザード関数・累積ハザード関数の意味と関係(ハザードは確率ではない)
- Rの模擬データで、打ち切りを無視すると中央値がどれだけ短く偏るかを体感(SASのコードも併記)
- 目的別の手法マップ(KM法・ログランク検定・Cox・RMST・競合リスクなど)
はじめに
抗がん剤の臨床試験の報告で「全生存期間の中央値は◯か月」という表現を目にしたことはありませんか。ところで、なぜ患者さんの生存期間を単純に平均しないのでしょうか。理由は、生存時間データには打ち切りがあり、普通の平均や中央値の求め方では結果が偏ってしまうからです。
この記事は、生存時間解析の入口です。打ち切りと2つの関数(生存関数・ハザード関数)を、数式とRの模擬データの両方で理解することを目指します。製薬企業・CROの新人統計担当の方、データマネージャー、臨床開発職の方、医学・薬学系の大学院生、統計検定の受験者の方を想定して書きました。Rを触ったことがない方は、先にR入門をご覧ください。
生存時間解析とは ― 「イベントが起こるまでの時間」を扱う統計手法
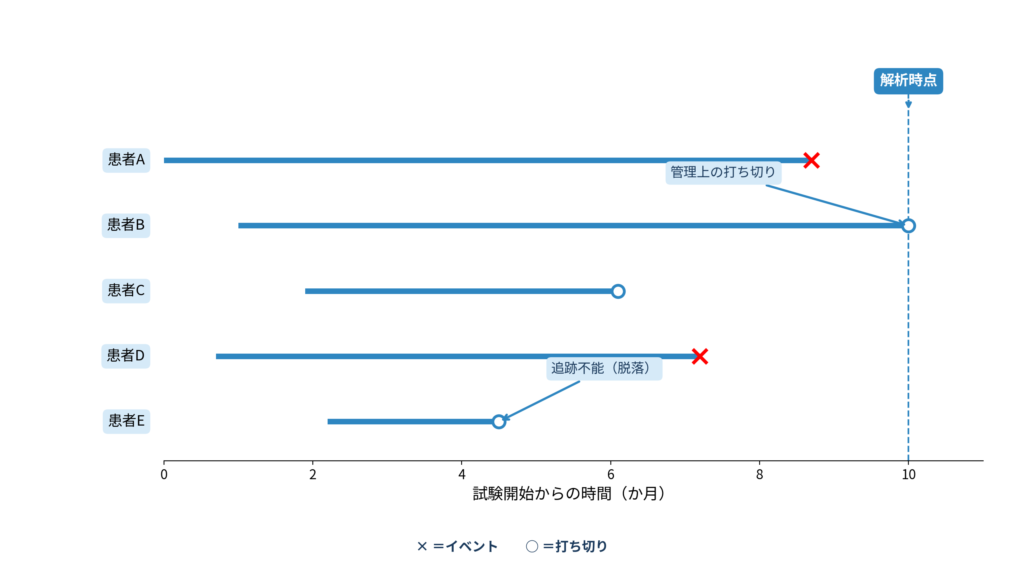
生存時間解析(survival analysis)とは、ある時点(時間原点)から、関心のあるイベントが起こるまでの時間を解析する手法です。イベントは死亡に限らず、再発、病勢進行、入院、有害事象の初発、機器の故障、離職なども扱えます。臨床試験では、全生存期間(OS)や無増悪生存期間(PFS)の解析に使われます。医学以外では「信頼性解析」「イベントヒストリー分析」とも呼ばれます。
生存時間データの3つの特徴
普通のデータと違う点は、次の3つです。
- 打ち切りがある:追跡期間中にイベントが観察されなかった人がいます。その人については「少なくともその時点まではイベントが起きていない」ことしかわかりません
- 0以上で、右に裾の長い分布になりやすい:多くの人が早めにイベントを起こし、一部の人が長く生き残ります。平均値は長生きした少数に引っ張られるので、代表値には中央値(中央生存期間:50%の人にイベントが起こるまでの時間)がよく使われます。違いは【やさしく解説】平均値と中央値の違いで確認できます
- 時間原点とイベントの定義が結果を左右する:「いつから数えるか」(ランダム化日、治療開始日、診断日など)と「何をイベントとするか」を事前に決めておかないと、解析全体が揺らぎます
打ち切りを正しく扱って生存率を推定する代表的な方法が、カプラン–マイヤー法(Kaplan-Meier法)です。
打ち切りの種類と「無情報な打ち切り」の仮定
打ち切りは、わかっている情報によって3種類に分けられます。
| 種類 | わかっていること | 臨床試験での例 |
|---|---|---|
| 右側打ち切り | イベントは観察期間より後に起こる(あるいは起こったかわからない) | 解析時点でまだ生存している、転院・同意撤回で追跡できなくなった |
| 左側打ち切り | イベントはある時点より前に起きた | 初回検査の時点で、既に抗体陽性だった |
| 区間打ち切り | イベントはある2時点の間に起きた | 定期画像検査の間に病勢進行が起きた(PFSで問題になる) |
臨床試験で最も多いのは右側打ち切りで、主な理由は2つあります。1つ目は管理上の打ち切り(administrative censoring)です。試験が予定の時点で解析を迎えるため、遅く登録された人ほど追跡期間が短くなります。2つ目は追跡不能・脱落(loss to follow-up)で、転居、同意撤回、来院中止などが該当します。
KM法・ログランク検定・Cox回帰などの標準的な手法は、無情報な打ち切り(non-informative censoring)を仮定しています。「打ち切られた人は、打ち切られなかった同じ条件の人と、その後のイベントの起こりやすさが変わらない」という仮定です。管理上の打ち切りはほぼ満たしますが、体調が悪化して来院できなくなった、副作用で治療をやめて追跡が切れた、といった脱落は、この仮定を破る可能性があります(情報のある打ち切り:informative censoring)。しかもこの仮定は、データだけからは確かめられません。崩れたときに何が起こるかは、後の章でRの模擬データを使って実測します。
もう1つ注意があります。「がんによる死亡」をイベントとするとき、他の原因による死亡は、その後にがん死が起こる可能性を消してしまいます。これを単純に打ち切り扱いにするのは不適切な場合があり、競合リスクとして別の手法で扱います。詳しくは競合リスク(Competing Risks)とはをご覧ください。
次章では、生存時間解析の土台となる3つの関数を整理します。
生存関数・ハザード関数・累積ハザード関数とは
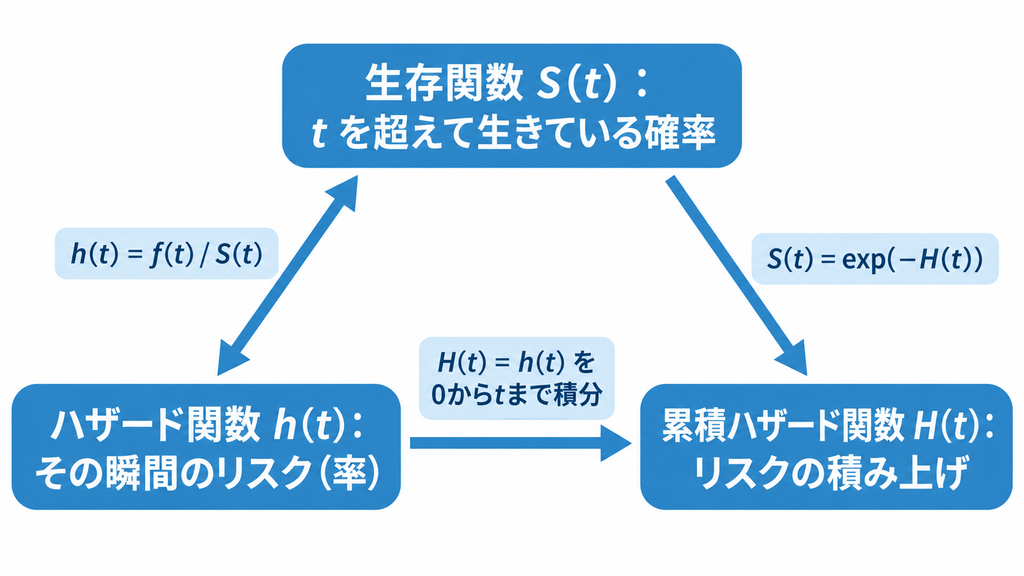
生存時間解析では、生存時間の分布を「生存関数」「ハザード関数」「累積ハザード関数」という3つの見方で表します。3つは同じ分布を別の角度から眺めたもので、互いに変換できます。
生存関数 S(t) ― 時点 t を超えてイベントが起きていない確率
生存時間を確率変数 \(T\)、その確率密度関数を \(f(t)\) とします。時点 \(t\) までにイベントが起きている確率が累積分布関数 \(F(t)\)、その反対が生存関数 \(S(t)\) です。
\[ F(t)=P(T\le t)=\int_0^t f(u)\,du \]
\[ S(t)=P(T>t)=1-F(t) \]
\(S(t)\) は「時点 \(t\) を超えても、まだイベントが起きていない人の割合(確率)」です。\(S(t)=0.5\) となる \(t\) が、前章で触れた中央生存期間にあたります。性質は次の3つです。
- \(S(0)=1\):開始時点では全員がイベントなしです
- 単調非増加:時間とともに減ることはあっても、増えることはありません
- \(t\) を大きくすると0に近づきます(ただし、治癒する人がいる病気では0にならないこともあります)
カプラン–マイヤー法の生存曲線は、この \(S(t)\) をデータから推定したものです。
ハザード関数 h(t) ― 「その瞬間のリスク」は確率ではない
ハザード関数 \(h(t)\) は、次の式で定義されます。
\[ h(t)=\lim_{\Delta t\to 0}\frac{P(t\le T<t+\Delta t \mid T\ge t)}{\Delta t} \]
分子は「時点 \(t\) まで無事だった人が、\(t\) から \(t+\Delta t\) の短い間にイベントを起こす確率」です。それを幅 \(\Delta t\) で割っているので、\(h(t)\) は単位時間あたりの率になります。まだイベントが起きていない人(リスク集合)の中で、その瞬間にどれだけの勢いでイベントが起きているか、と読んでください。
ここで大事なのは、ハザードは確率ではないという点です。Rで確かめてみましょう。
# ハザードは「確率」ではなく「率」:時間の単位を変えると値が変わる
h_month <- 0.15            # 1か月あたり0.15のハザード(時間によらず一定と仮定)
h_year  <- h_month * 12    # 1年あたりに直すと
h_year
round(1 - exp(-h_month), 3)   # 1か月以内にイベントが起こる確率
round(1 - exp(-h_year), 3)    # 1年以内にイベントが起こる確率
round(log(2) / h_month, 2)    # 中央生存期間(か月)
[1] 1.8
[1] 0.139
[1] 0.835
[1] 4.62
- 同じリスクでも、1か月あたりなら0.15、1年あたりに直すと1.8です。確率が1を超えることはありえないので、ハザードは確率ではなく「単位時間あたりの率」だとわかります。ハザードを報告するときは、単位(/月、/年、/100人年など)が必須です。
- ハザードが一定のとき、期間 \(t\) 以内にイベントが起こる確率は \(1-e^{-ht}\) です。1か月以内は0.139(ハザード0.15に近い値)、1年以内は0.835でした。「確率 ≒ ハザード×期間」と近似できるのは、期間が短くハザードが小さいときだけです。
- 中央生存期間は \(\log 2/h\) で、4.62か月と求まります。
臨床試験の有害事象の発現率(人年あたりの件数)は、ハザードが一定と仮定したときのハザードの推定値にあたります。くわしくは有害事象(AE)データの統計解析の記事をご覧ください。
また、ハザード比(HR)は「2群のハザードの比」です。そのため「HR 0.7=死亡確率が30%減る」と言い換えるのは厳密には正しくありません。違いはオッズ比・相対リスク・ハザード比の違いで整理しています。なお、Cox比例ハザードモデルは、このハザードを共変量で説明するモデルです。
3つの関数の関係 ― どれか1つがわかれば残りも決まる
条件付き確率の定義から、ハザードの分子は \(P(t\le T<t+\Delta t)/P(T\ge t)\) と書けます。\(\Delta t\to 0\) で \(\{F(t+\Delta t)-F(t)\}/\Delta t\to f(t)\) となり、連続分布では \(P(T\ge t)=S(t)\) なので、\(h(t)=f(t)/S(t)\) です。さらに \(f(t)=-dS(t)/dt\) なので、次の関係が得られます。
\[ h(t)=\frac{f(t)}{S(t)}=-\frac{d}{dt}\log S(t) \]
\(S(t)\) は減少して \(\log S(t)\) の傾きは負になるので、マイナス記号が付いて \(h(t)\) は正になります。ハザードを0から \(t\) まで積み上げたものが、累積ハザード関数 \(H(t)\) です。
\[ H(t)=\int_0^t h(u)\,du,\qquad S(t)=\exp\{-H(t)\},\qquad H(t)=-\log S(t) \]
つまり、\(f(t)\)、\(S(t)\)、\(h(t)\)、\(H(t)\) のどれか1つがわかれば、残りも決まります。整理すると次のとおりです。
| 関数 | 記号 | 意味 | 値の範囲 |
|---|---|---|---|
| 確率密度関数 | \(f(t)\) | 時点 \(t\) 付近でイベントが起きる確率の密度 | 0以上 |
| 生存関数 | \(S(t)\) | 時点 \(t\) を超えてイベントが起きていない確率 | 0〜1の確率 |
| ハザード関数 | \(h(t)\) | リスク集合の中での、その瞬間のイベント発生の率 | 0以上の率(1を超えうる) |
| 累積ハザード関数 | \(H(t)\) | 0から \(t\) までのハザードの積み上げ | 0以上(1を超えうる) |
ハザードの形 ― 減る・一定・増える
ハザードが時間とともにどう変わるかは、分布によって決まります。最も単純なのが指数分布で、ハザードが一定値 \(\lambda\) です。
\[ h(t)=\lambda,\qquad S(t)=e^{-\lambda t},\qquad H(t)=\lambda t \]
平均は \(1/\lambda\)、中央値は \(\log 2/\lambda\) です(\(\log\) は自然対数)。いつ見てもリスクが同じなので、過去の経過を記憶しない「無記憶性」をもちます。
これを一般化したのがWeibull分布です。形状パラメータを \(k\)、尺度パラメータを \(b\) とすると、次のように書けます。
\[ h(t)=\frac{k}{b}\left(\frac{t}{b}\right)^{k-1},\qquad S(t)=\exp\{-(t/b)^k\},\qquad H(t)=(t/b)^k \]
\(k<1\) ならハザードは時間とともに減少し、\(k=1\) で一定(指数分布)、\(k>1\) なら増加します。形状を変えて数値を見てみましょう。
# Weibull分布のハザード関数:形状パラメータで「減る・一定・増える」が決まる
weib_h <- function(t, shape, scale) (shape / scale) * (t / scale)^(shape - 1)
t <- c(0.5, 1, 2, 4)
round(data.frame(t,
                 decreasing = weib_h(t, shape = 0.5, scale = 2),
                 constant   = weib_h(t, shape = 1,   scale = 2),
                 increasing = weib_h(t, shape = 2,   scale = 2)), 3)

# S(t) = exp(-H(t)) の確認(形状2・尺度2のWeibull分布)
H <- (t / 2)^2                                   # 累積ハザード
all.equal(pweibull(t, shape = 2, scale = 2, lower.tail = FALSE), exp(-H))
    t decreasing constant increasing
1 0.5      0.500      0.5       0.25
2 1.0      0.354      0.5       0.50
3 2.0      0.250      0.5       1.00
4 4.0      0.177      0.5       2.00
[1] TRUE
- 形状0.5(
decreasing)は0.500から0.177へと時間とともに減少し、形状1(constant)は常に0.5です(指数分布のハザードは1/尺度=1/2)。形状2(increasing)は0.25から2.00へ増加します。 pweibull(..., lower.tail = FALSE)は \(S(t)\) を返す関数です。それがexp(-H)と一致(TRUE)したので、\(S(t)=\exp\{-H(t)\}\) の関係を数値で確かめられました。
ハザードの形は、現実のイメージと結びつけると理解しやすくなります。
- 減少:手術直後の合併症のように、初期のリスクが高いもの
- 一定:偶発的な事故や故障のように、時間によらないもの
- 増加:加齢や摩耗のように、時間とともに高まるもの
対数正規分布や対数ロジスティック分布では、ハザードが一度上がってから下がる山型になることもあります。工学では、初期故障(減る)、偶発故障(一定)、摩耗故障(増える)を順に描く「バスタブ曲線」が知られています。どの分布を当てはめるか、AFTモデルとの関係などはパラメトリック生存時間解析とはで解説しています。本記事では、形のイメージをつかむところまでで十分です。
Rで体感する ― 打ち切りを無視すると中央値はどれだけずれるか
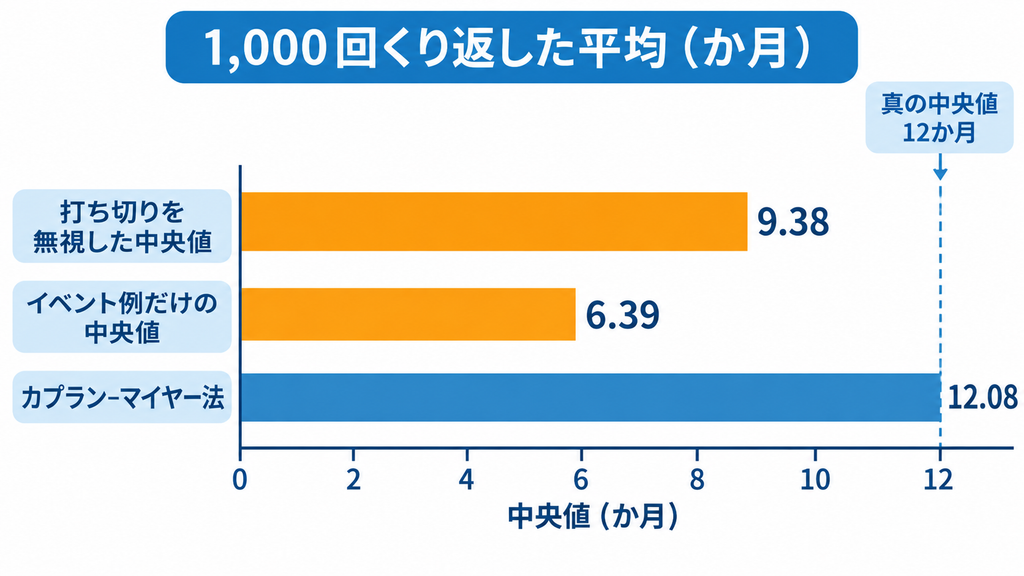
ここからは、打ち切りを無視するとなぜ困るのかをRで確かめます。使うのは説明用に作った模擬データで、実際の試験のデータではありません。200人の試験を想定し、真のイベント時間は中央値12か月の指数分布とします。患者は試験開始から24か月かけて順に登録され、試験開始30か月の時点で解析します。遅く登録された人ほど追跡期間が短く(6〜30か月)、解析時点でイベントがまだ起きていない人は打ち切りになります(管理上の打ち切り)。真の中央値が12か月とわかっているので、各方法の答え合わせができます。
Rでの実装
まず1回分の試験で、打ち切りを無視した平均・中央値、イベント例だけの中央値、カプラン–マイヤー法(KM法)の中央値を比べます。
library(survival)

set.seed(438)
n      <- 200
t_true <- rexp(n, rate = log(2) / 12)   # 真のイベント時間(真の中央値は12か月)
enroll <- runif(n, 0, 24)               # 登録時期(試験開始から0〜24か月)
fu     <- 30 - enroll                   # 30か月で解析:追跡できる期間は6〜30か月
time   <- pmin(t_true, fu)              # 観察される時間
status <- as.numeric(t_true <= fu)      # 1 = イベント、0 = 打ち切り
dat    <- data.frame(time = round(time, 2), status)

mean(dat$status == 0)                   # 打ち切りの割合
round(c(mean_all     = mean(dat$time),                     # 打ち切りを無視した平均
        median_all   = median(dat$time),                   # 打ち切りを無視した中央値
        median_event = median(dat$time[dat$status == 1])), # イベント例だけの中央値
      2)

km <- survfit(Surv(time, status) ~ 1, data = dat)
km
[1] 0.345
    mean_all   median_all median_event
       10.26         8.46         6.80
Call: survfit(formula = Surv(time, status) ~ 1, data = dat)

       n events median 0.95LCL 0.95UCL
[1,] 200    131    9.9    8.42    13.3
| 求め方 | 値(か月) | 真の値(か月) |
|---|---|---|
| 打ち切りを無視した平均 | 10.26 | 17.31 |
| 打ち切りを無視した中央値 | 8.46 | 12 |
| イベント例だけの中央値 | 6.80 | 12 |
| カプラン–マイヤー法の中央値 | 9.9(95%信頼区間 8.42〜13.3) | 12 |
- 打ち切りは200人中34.5%、イベントは131件です。
- 指数分布の平均は中央値÷\(\log 2\)なので、真の平均は\(12/\log 2\)で17.31か月です。打ち切りを無視した平均10.26は大きく短く出ています。打ち切られた人は「少なくともそこまでは生きていた」のに、その時点でイベントが起きたかのように扱ってしまうためです。
- イベント例だけの中央値6.80は、さらに悪い結果です。長く生きた人ほど打ち切られやすいので、イベント例だけを集めると短命な人ばかりが残ります。
- KM法の中央値は9.9か月で、この1回の試験では12よりやや短めです。ただし95%信頼区間8.42〜13.3は真の値12を含んでいます。1回の試験の推定値はばらつくので、次に1,000回くり返して偏り(バイアス)があるかを確かめます。
survfit()が返すmedianがKM法の中央生存期間です。KM法の仕組みと読み方はカプランマイヤー法(Kaplan-Meier法)とはをご覧ください。
次に、同じデザインの試験を1,000回くり返し、3つの中央値の平均を比べます。
# 同じデザインの試験を1,000回くり返し、3つの中央値の平均を比べる
one_trial <- function(n = 200) {
  t_true <- rexp(n, rate = log(2) / 12)
  fu     <- 30 - runif(n, 0, 24)
  time   <- pmin(t_true, fu)
  status <- as.numeric(t_true <= fu)
  km     <- survfit(Surv(time, status) ~ 1)
  c(median_all   = median(time),
    median_event = median(time[status == 1]),
    median_km    = unname(summary(km)$table["median"]))
}
set.seed(2026)
round(rowMeans(replicate(1000, one_trial())), 2)
  median_all median_event    median_km
        9.38         6.39        12.08
- 1,000回の平均で、打ち切りを無視した中央値は9.38、イベント例だけは6.39でした。真の値12より、毎回の傾向として短く偏ります。偶然ではなく、やり方そのものの偏り(バイアス)です。
- KM法は12.08で、平均すると真の12とほぼ一致します。先ほどの9.9は、その1回がたまたま短めに出たものです。
- 結論として、打ち切りを含むデータでは、普通の平均・中央値ではなく、打ち切りを正しく扱う生存時間解析の手法を使います。これが生存時間解析が必要な一番の理由です。
最後に、データの持ち方(Surv オブジェクト)を確認し、前章で学んだ \(S(t)=\exp\{-H(t)\}\) がデータでも成り立つかを見ます。1回目の試験の dat と km の続きです。
head(Surv(dat$time, dat$status), 8)

s <- summary(km, times = c(6, 12, 24))
round(data.frame(time   = s$time,
                 n.risk = s$n.risk,
                 S_km   = s$surv,
                 H_na   = s$cumhaz,
                 S_na   = exp(-s$cumhaz),
                 S_true = exp(-log(2) / 12 * s$time)), 3)
[1]  5.11   9.68+ 27.03+ 18.07   6.77   8.18  17.09+  6.31
  time n.risk  S_km  H_na  S_na S_true
1    6    144 0.720 0.327 0.721  0.707
2   12     68 0.442 0.812 0.444  0.500
3   24     10 0.245 1.393 0.248  0.250
Surv(時間, イベント)が生存時間データの基本形です。+が付いた値(9.68+ など)は打ち切りで、「少なくとも9.68か月まではイベントなし」を意味します。statusは 1=イベント、0=打ち切りで作るのが基本です。S_kmはKM法の生存率、H_naはNelson–Aalen推定量(累積ハザードのノンパラメトリックな推定量で、survfit()のcumhazは既定でこれです)、S_naはそれを \(\exp\{-H\}\) で生存率に直した値です。S_kmとS_naはほぼ一致し(0.720と0.721、0.442と0.444、0.245と0.248)、\(S(t)=\exp\{-H(t)\}\) がデータでも成り立つとわかります。- 真の生存率
S_true(0.707、0.500、0.250)と比べると、6か月と24か月は近い値です。12か月の0.442は真の0.500より低めで、先ほど中央値が9.9と短めに出たことに対応しています。 n.riskは、その時点でまだイベントも打ち切りも起きていない人数(リスク集合)です。6か月で144人ですが、24か月では10人しか残っていません。曲線の右端は少人数で決まるので不安定で、KM曲線の下に at risk 数を載せる理由はここにあります。生存率の標準誤差と信頼区間はカプラン–マイヤー法における標準誤差と信頼区間の導出(Greenwoodの式)で扱っています。H_naの1.393のように、累積ハザードは1を超えることがあります。確率ではないからです。
SASでの実装
SASでも同じ解析ができます。まずRで模擬データをCSVに書き出します。
write.csv(dat, "surv_sim.csv", row.names = FALSE) # SAS で読み込むために書き出す
次に、SASでCSVを読み込み、PROC LIFETEST でKM法とNelson–Aalen推定量を求めます。
/* R で書き出した surv_sim.csv を読み込む */
proc import datafile="surv_sim.csv" out=dat dbms=csv replace;
  getnames=yes;
run;

/* カプラン–マイヤー法と Nelson–Aalen 推定量 */
proc lifetest data=dat method=km nelson
              timelist=6 12 24 reduceout outsurv=surv_out
              plots=survival(cl atrisk);
  time time*status(0);
run;

proc print data=surv_out;
run;
ポイントを整理します。
PROC LIFETESTは、ノンパラメトリックな生存時間解析(KM法、生命表法、群間の検定)を行うプロシジャです。method=kmでカプラン–マイヤー法を指定します(既定値です)。time time*status(0);は、時間変数がtime、打ち切りを表す変数がstatus、かっこ内の値0が打ち切りという意味です。RのSurv()は「イベント=1」を指定するのに対し、SASは「打ち切りの値」を指定します。取り違えるとイベントと打ち切りが入れ替わり、まったく別の結果になるので注意してください。nelsonを付けると、Nelson–Aalen推定量による累積ハザードも推定します。timelist=6 12 24とreduceoutを組み合わせると、outsurv=のデータセットに指定した時点の推定値だけが出力されます。Rのsummary(km, times = c(6, 12, 24))に対応します。plots=survival(cl atrisk)で、KM曲線に信頼区間(cl)と at risk 数(atrisk)を付けて描きます。- 中央生存期間とその信頼区間は、出力の「四分位点推定値(Quartile Estimates)」の表の50%の行に表示されます。
信頼区間の既定の計算方法がRとSASで異なります。生存率の信頼区間を計算するときの変換は、Rの
survfit() の既定が log、SASの PROC LIFETEST の既定が log-log です(SASは conftype= で変更できます)。そのため、点推定値(生存率・中央値)は同じでも、信頼区間は一致しないことがあります。Rで合わせたいときは survfit(..., conf.type = "log-log") を指定してください。SASでも、Rの集計と同じ時点(6・12・24か月)で生存率の点推定値を比べられるので、実装の検算に使えます。SASとRの実装をさらに詳しく比べたい方は、生存時間解析の基礎:カプラン–マイヤー法と SAS・R による実装もあわせてご覧ください。
無情報な打ち切りの仮定が崩れるとき ― 予後の悪い患者ほど脱落する場合
前章までで説明した「無情報な打ち切り」の仮定が崩れると、結果はどうなるのでしょうか。説明用の模擬データで確かめてみます。
5,000人の模擬試験で、半数が予後不良群(真の中央値6か月)、半数が予後良好群(真の中央値18か月)です。全体の真の中央値は、2群を混ぜた生存関数から計算します。脱落(打ち切り)の起こり方は次の2通りを用意しました。
- (a) 予後と無関係に、全員が月0.04の率で脱落する
- (b) 予後不良群は月0.08、良好群は月0.01の率で脱落する(体調が悪化して来院できなくなる状況のイメージ)
# 情報のある打ち切り:予後の悪い患者ほど試験から脱落しやすい場合
set.seed(4869)
n     <- 5000
high  <- rbinom(n, 1, 0.5)                                   # 1 = 予後不良群(半数)
t_ev  <- rexp(n, rate = ifelse(high == 1, log(2) / 6, log(2) / 18))
S_mix <- function(t) 0.5 * exp(-log(2) / 6 * t) + 0.5 * exp(-log(2) / 18 * t)
true_median <- uniroot(function(t) S_mix(t) - 0.5, c(0, 50))$root

# (a) 脱落が予後と無関係:全員が同じ割合(月0.04)で脱落
c_a <- rexp(n, rate = 0.04)
# (b) 予後不良群ほど脱落しやすい:予後不良群は月0.08、良好群は月0.01
c_b <- rexp(n, rate = ifelse(high == 1, 0.08, 0.01))

km_median <- function(c) {
  fit <- survfit(Surv(pmin(t_ev, c), as.numeric(t_ev <= c)) ~ 1)
  unname(summary(fit)$table["median"])
}
round(c(true          = true_median,
        noninformative = km_median(c_a),
        informative    = km_median(c_b)), 2)
round(c(censored_a = mean(c_a < t_ev), censored_b = mean(c_b < t_ev)), 3)
          true noninformative    informative
          9.93          10.15          11.27
censored_a censored_b
     0.391      0.300
| 脱落の起こり方 | 打ち切りの割合 | KM法の中央値(か月) |
|---|---|---|
| 真の中央値 | ― | 9.93 |
| (a) 予後と無関係 | 39.1% | 10.15 |
| (b) 予後不良群ほど脱落 | 30.0% | 11.27 |
- 真の中央値は 9.93か月 です。(a) のKM法は 10.15か月 でほぼ正しく、打ち切りが39.1%と多くても、無情報であれば問題ありません。
- (b) は 11.27か月 で、真の値より約1.3か月長く、つまり生存を楽観的に推定しています。予後不良の人が早く抜けるため、リスク集合に予後良好な人ばかりが残り、生存曲線が実際より上に描かれるからです。
- 打ち切りは(b)の方が30.0%と少ないのに、偏りは大きいことに注目してください。問題は打ち切りの「量」ではなく「起こり方(メカニズム)」です。
- 1回の模擬試験の結果ですが、5,000人と大きいので偶然のぶれは小さいです。
無情報な打ち切りの仮定はデータだけからは検証できません。だからこそ、次の3点が実務の基本です。
- 脱落理由と時期を群ごとに集計し、偏りがないか確かめる
- 打ち切りの扱いを変えた感度解析(例:脱落した人に最悪のシナリオを当てはめる)を、解析計画書で事前に決めておく
- 予後と関連する因子がわかっていれば、それで調整・層別する
治療中止後の追跡をどう扱うかは、estimand(中間事象の扱い)と直結します。考え方はICH E9(R1) Estimandフレームワーク徹底解説、感度解析の事前規定は統計解析計画書(SAP)の書き方を参照してください。脱落を見込んだ必要症例数は生存時間解析のサンプルサイズ設計で扱っています。
生存時間解析の手法マップ ― 目的別にどの手法を使うか
生存関数・ハザード関数・打ち切りの考え方がわかれば、あとは目的に応じて手法を選ぶだけです。各手法の詳細は、次の表のリンク先で確認してください。
| 目的 | 代表的な手法 | くわしい記事 |
|---|---|---|
| 生存曲線を推定し、中央生存期間を求める | カプラン–マイヤー法 | カプランマイヤー法(Kaplan-Meier法)とは |
| 生存率の信頼区間を求める | Greenwoodの式 | カプラン–マイヤー法における標準誤差と信頼区間の導出 |
| 2群の生存曲線を比べる(検定) | ログランク検定・一般化ウィルコクソン検定 | ログランク(log-rank)検定を徹底解説 一般化ウィルコクソン検定徹底解説 |
| 共変量で調整して効果をハザード比で表す | Cox比例ハザードモデル | Cox比例ハザードモデル入門 |
| 比例ハザード性を確かめる・崩れたときに対処する | Schoenfeld残差・RMST | Cox比例ハザード性のチェックとRMSTへの切り替え判断 |
| 施設や地域で層別する・時間とともに変わる共変量を扱う | 層別Cox・時間依存性共変量 | 層別Cox比例ハザードモデル 時間依存性共変量を考慮したCox比例ハザードモデル |
| 分布を仮定して推定・予測する | 指数・Weibull・AFTモデル | パラメトリック生存時間解析とは |
| ハザード比に頼らず「平均でどれだけ長く生きるか」を示す | RMST(制限付き平均生存時間) | 【徹底解説】RMST(制限付き平均生存時間)とは何か? RMSTをRで実装する方法 |
| 他の原因の死亡などがイベントを妨げる | 競合リスク(累積発生関数・Fine-Grayモデル) | 競合リスク(Competing Risks)とは |
| 複数の状態を行き来する(例:健康→病気→死亡) | マルチステートモデル | マルチステートモデル(Multi-state Model)とは |
| 死亡・入院など重みの違う複数のイベントをまとめて比べる | Win Ratio | Win Ratio法による複合エンドポイント解析 |
| 必要なイベント数・症例数を見積もる | Schoenfeldの式など | 生存時間解析のサンプルサイズ設計 |
生存時間解析を始める前のチェックリストです。
- 時間原点とイベントの定義を事前に決めたか
- 打ち切りの理由と時期を記録・集計しているか
- 競合するイベントを打ち切り扱いにしていないか
- 中央値・生存率をKM法で推定し、at risk 数と信頼区間を添えているか
- 打ち切りの扱いを変えた感度解析を事前に計画したか
📚 この記事をより深く理解するための参考書籍
生存時間解析の考え方を、入門から実務レベルまで段階的に深めるための3冊を紹介します。



関連記事・次のステップ
生存曲線の推定と比較から始めたい方は、カプランマイヤー法(Kaplan-Meier法)とはで本記事の \(S(t)\) をデータから推定する手順を、ログランク(log-rank)検定を徹底解説で2群の比べ方を確認してください。
ハザードをモデルで扱いたい方は、Cox比例ハザードモデル入門とパラメトリック生存時間解析とはへ進むと、本記事のハザード関数・Weibull分布がそのまま土台になります。
ハザード比だけでは足りない場面では、RMST(制限付き平均生存時間)解析ガイドや、競合リスクの生存時間解析をRで実装するが役立ちます。
まとめ
本記事では、生存時間解析の入口として、打ち切り・生存関数・ハザード関数の基礎を、数式とRの模擬データの両方で整理しました。
生存時間データには打ち切りがあり、分布は右に裾が長くなります。生存関数 \(S(t)\) は「時点 \(t\) を超えてイベントが起きていない確率」、ハザード関数 \(h(t)\) は「リスク集合の中での瞬間の率」で、両者は累積ハザード \(H(t)\) を介して \(S(t)=\exp\{-H(t)\}\) で結ばれます。ハザードは確率ではなく率なので、月0.15が年1.8になるように1を超えることもあります。
真の中央値が12か月の模擬試験では、打ち切りを無視した中央値は1,000回くり返しの平均で9.38か月、イベント例だけでは6.39か月と短く偏り、カプラン–マイヤー法は12.08か月とほぼ正しい値を示しました。一方、予後の悪い患者ほど脱落する「情報のある打ち切り」では、打ち切りが少ないにもかかわらず、KM法の中央値は真の9.93か月に対して11.27か月と楽観的に偏りました。打ち切りは量ではなく起こり方が問題であり、脱落理由の集計と感度解析の事前計画が欠かせません。
ここまでの考え方が身につけば、カプラン–マイヤー法、ログランク検定、Cox比例ハザードモデル、RMST、競合リスクといった各論は、目的に応じて選ぶだけです。まずはカプランマイヤー法(Kaplan-Meier法)とはから読み進め、本記事の手法マップを地図代わりに、生存時間解析の全体像をつかんでいただければと思います。