統計検定準1級「分割表」攻略 ― Fisher正確検定・オッズ比・Mantel-Haenszelの典型出題対策 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
統計検定準1級の対策として、カテゴリカルデータを扱う「分割表」を取り上げます。
例題は筆者(生物統計家)が選定し、数値はすべてRで検算しています。
この記事でわかること
- 2×2表のカイ二乗検定とYates補正の計算と使い分け
- 期待度数が小さいときに使うFisher正確検定の考え方
- オッズ比・相対リスク・リスク差の計算と信頼区間の作り方
- 層別表のMantel-Haenszel推定とCMH検定による交絡への対処
- r×c表の調整済み残差と、順序カテゴリの傾向検定
本記事は、統計検定準1級の攻略シリーズの1本です。分割表は、臨床試験の有効性解析や症例対照研究など、実務でも頻出のテーマです。
はじめに ― 準1級における「分割表」の位置づけ
準1級では、分割表はカテゴリカルデータ解析の中心です。
カイ二乗検定そのものは2級でも出題されます。
準1級では、正確検定・効果の尺度・層別解析までが問われます。
試験はCBT方式で、試験時間は90分です。
出題数はおおむね20〜30問とされています。
100点満点で60点以上が合格ラインとされます(最新情報は公式サイトで確認してください)。
使える電卓は、四則演算・百分率・平方根ができる普通電卓のみです。
関数電卓は使えません。
そのため本記事の例題は、普通電卓で追える計算を中心に組み立てました。
本記事で扱うのは、次の範囲です。
- 2×2表のカイ二乗検定とYates補正
- Fisher正確検定
- オッズ比・相対リスク・リスク差と信頼区間
- 層別表のMantel-Haenszel推定とCMH検定
- r×c表の独立性と調整済み残差
- 順序カテゴリの傾向検定
独立性の帰無仮説と期待度数の導出は既存記事「分割表の独立性の検定」に委ね、本記事は準1級で差がつく範囲に絞ります。
分割表の基礎とカイ二乗検定 ― 期待度数とYates補正
分割表は、2つのカテゴリ変数の組み合わせごとに度数を並べた表です。準1級では、度数から「2つの変数に関連があるか」を検定する問題が頻出です。
表のデータが得られる仕組みは、大きく3つに分けられます。
- ポアソンモデル:総数も周辺度数も固定せず、セル度数がポアソン分布に従う
- 多項モデル:総数だけを固定し、セル度数が多項分布に従う
- 積多項モデル:行和を固定し、各行が独立な多項分布に従う
どのモデルでも、周辺度数を条件として固定すれば同じカイ二乗検定に帰着します。臨床試験のように群ごとの例数を固定する設計でも、カイ二乗検定が使えるのはこのためです。
期待度数が「行和×列和÷総数」になる理由は、既存記事「分割表の独立性の検定」で導出しています。本記事では、式を使うことに集中します。
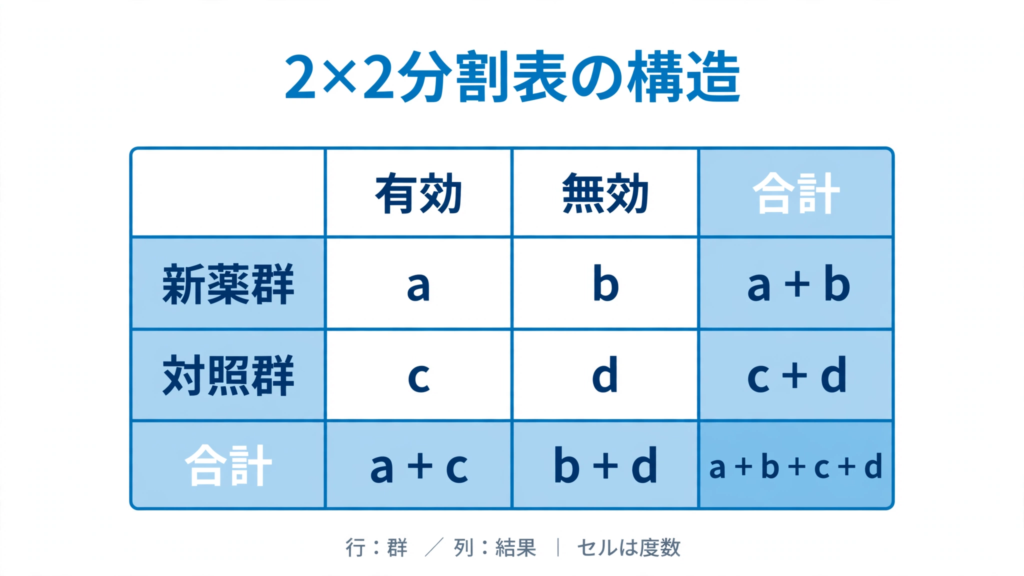
例題1 カイ二乗検定とYates補正
問題
ある臨床試験で、新薬群40例のうち28例が有効、対照群40例のうち18例が有効でした。
(1) 独立性の帰無仮説のもとでの期待度数を求めてください。
(2) Pearsonのカイ二乗統計量を計算し、5%水準で判定してください。
(3) Yatesの連続性補正を適用した統計量を計算し、補正の意味と使い分けを述べてください。
解答
(1) 列和は有効46・無効34、総数は80です。期待度数は「行和×列和÷総数」で求めます。
\[E=\frac{40\times46}{80}=23,\quad\frac{40\times34}{80}=17\]
両群とも、期待度数は有効23・無効17です。
(2) Pearsonの統計量は \(\chi^2=\sum(O-E)^2/E\) です。各セルの \(O-E\) は \(\pm5\) になるので、
\[\chi^2=2\times\left(\frac{25}{23}+\frac{25}{17}\right)\approx5.115\]
自由度1の5%点は3.841です。\(5.115>3.841\) なので帰無仮説を棄却し、有効率に群間差があると判断します。
(3) Yates補正では \(|O-E|\) から0.5を引き、\((5-0.5)^2=20.25\) を使います。
\[\chi^2=2\times\left(\frac{20.25}{23}+\frac{20.25}{17}\right)\approx4.143\]
結論は同じですが、p値は0.024から0.042へ大きくなります。2×2表では度数が離散的でカイ二乗分布による近似が粗いため、その離散性を補うのがYates補正です。
検算:2×2表では1セルのずれが決まれば残り3セルも決まるため、\((O-E)\) は4セルとも \(\pm5\) でそろいます。
Rで答え合わせをします。
# 例題1:2×2表のカイ二乗検定とYates補正
tab1 <- matrix(c(28, 12, 18, 22), nrow = 2, byrow = TRUE)
chisq.test(tab1, correct = FALSE)$expected  # 期待度数
chisq.test(tab1, correct = FALSE)  # Pearsonのカイ二乗検定
chisq.test(tab1, correct = TRUE)   # Yatesの連続性補正
     [,1] [,2]
[1,]   23   17
[2,]   23   17

	Pearson's Chi-squared test

data:  tab1
X-squared = 5.1151, df = 1, p-value = 0.02372


	Pearson's Chi-squared test with Yates' continuity correction

data:  tab1
X-squared = 4.1432, df = 1, p-value = 0.0418
Rの出力は、Pearsonで X-squared = 5.1151、p = 0.02372、Yates補正で X-squared = 4.1432、p = 0.0418 です。手計算と一致します。
Pearsonの p = 0.024 に対し、Yates補正では p = 0.042 と約1.8倍になります。境界付近では補正の有無が結論を左右します。
試験では、どちらの統計量を求められているかを問題文で確認してください。実務でも、補正の有無は統計解析計画書で事前に決めておくのが原則です。
小標本ではFisher正確検定 ― 超幾何分布から読み解く
カイ二乗検定は、カイ二乗分布による近似にもとづく検定です。期待度数が小さいセルがあると、近似が崩れて判定を誤ります。
その場合はFisher正確検定を使います。周辺度数を固定すると表は1つのセルの値で決まるため、その値が従う超幾何分布から確率を直接計算できます。例数が限られる希少疾患の試験などでは、この場面がよく起こります。
例題2 Fisher正確検定
問題
小規模な試験で、処置群8例のうち6例が改善、対照群8例のうち1例が改善でした。
(1) 期待度数を求め、Pearsonのカイ二乗検定が不適切な理由を述べてください。
(2) 周辺度数を固定したとき、観測された表が得られる確率を超幾何分布で求めてください。
(3) Fisher正確検定の両側p値を求めてください。
解答
(1) 列和は改善7・非改善9です。期待度数は、改善が \(8\times7/16=3.5\)、非改善が \(8\times9/16=4.5\) です。
期待度数に5未満のセルがあるため、カイ二乗分布による近似は不適切です。
(2) 周辺を固定すると、処置群の改善数 \(X\) は超幾何分布に従います。改善7例を含む16例から処置群の8例を選ぶ、という見方です。
\[P(X=6)=\frac{\binom{7}{6}\binom{9}{2}}{\binom{16}{8}}=\frac{252}{12870}\approx0.0196\]
(3) 両側p値は、観測表以下の確率をもつ表の確率の合計です。該当するのは \(X=0,1,6,7\) の表です。分布が対称なため、
\[2\times(0.0007+0.0196)\approx0.0406\]
5%水準で帰無仮説を棄却します。
検算:分子は \(\binom{7}{6}\binom{9}{2}=7\times36=252\) です。分母 \(\binom{16}{8}=12870\) までの割り算は普通電卓で追えます。
Rで答え合わせをします。
# 例題2:Fisherの正確検定
tab2 <- matrix(c(6, 2, 1, 7), nrow = 2, byrow = TRUE)
dhyper(6, 7, 9, 8)  # 観測された表の確率
sum(dhyper(c(0, 1, 6, 7), 7, 9, 8))  # 両側p値(観測表以下の確率の表の合計)
fisher.test(tab2)  # 両側検定
[1] 0.01958042
[1] 0.04055944

	Fisher's Exact Test for Count Data

data:  tab2
p-value = 0.04056
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
    1.087594 1088.437009
sample estimates:
odds ratio
  16.19942
Rの出力では、観測表の確率が0.0196、両側p値が0.04056となります。
両側p値は0.0406で、5%水準で棄却します。なお、Rの fisher.test が表示するオッズ比16.2は条件付き最尤推定値です。
標本オッズ比 \((6\times7)/(2\times1)=21\) とは定義が異なるので、混同しないでください。
検定を選ぶ目安は期待度数です。5未満のセルがあればカイ二乗近似を避け、Fisher正確検定を選びます。
試験では、期待度数を求めさせる小問が検定の選択を問う布石になっていることが多いです。
効果の尺度 ― オッズ比・相対リスク・リスク差
検定が答えるのは「差があるか」までです。
実務で問われるのは「どれくらい差があるか」です。
その大きさを数値で表すのが、効果の尺度です。
代表的な尺度は次の3つです。
- オッズ比(OR):オッズの比。症例対照研究で使える尺度です
- 相対リスク(RR):リスク(発症割合)の比。コホート研究で使えます
- リスク差(RD):リスクの差。絶対的な効果の大きさを表します
例題3でオッズ比、例題4で相対リスクとリスク差を扱います。
例題3 オッズ比と信頼区間
問題
ある症例対照研究で、症例群200例のうち曝露ありが120例・なしが80例、対照群200例のうち曝露ありが80例・なしが120例であった。
(1) オッズ比を求めてください。
(2) Woolf法(対数変換)でオッズ比の95%信頼区間を求めてください。
(3) 症例対照研究で相対リスクを直接推定できない理由と、オッズ比が使われる理由を述べてください。
解答
(1) オッズ比は、2×2表の対角積の比です。
症例群の曝露オッズは \(120/80\)、対照群は \(80/120\) です。
\[OR=\frac{120\times120}{80\times80}=2.25\]
(2) 信頼区間は、オッズ比を対数変換してから作ります。
\(\log OR=\log 2.25\approx0.8109\) です。
標準誤差は、各セルの度数の逆数の和の平方根です。
\[SE=\sqrt{\frac{1}{120}+\frac{1}{80}+\frac{1}{80}+\frac{1}{120}}=\sqrt{0.04167}\approx0.2041\]
95%信頼区間は \(\exp(0.8109\pm1.96\times0.2041)\) より、\((1.508,\ 3.357)\) です。
(3) 症例対照研究では、症例と対照を何例ずつ集めるかを研究者が決めます。
そのため、集団の発症リスクそのものは推定できません。
一方オッズ比は、この抽出比の影響を受けずに推定できます。
これが、症例対照研究でオッズ比が使われる理由です。
検算:信頼区間は対数スケールで対称です。\(\sqrt{1.508\times3.357}\approx2.25\) と、点推定値に戻ることを確認します。
Rで答え合わせ
# 例題3:オッズ比とWoolf法の信頼区間
a <- 120; b <- 80; c <- 80; d <- 120
or <- (a * d) / (b * c)
se <- sqrt(1 / a + 1 / b + 1 / c + 1 / d)
c(OR = or, lower = exp(log(or) - 1.96 * se), upper = exp(log(or) + 1.96 * se))
      OR    lower    upper
2.250000 1.508094 3.356885
オッズ比は2.25で、曝露と発症に関連があることが示唆されます。
95%信頼区間 \((1.508,\ 3.357)\) は1を含まないので、5%水準でも有意です。
試験では「対数変換して区間を作り、指数関数で戻す」という手順そのものが問われます。
例題4 相対リスク・リスク差と信頼区間
問題
あるコホート研究で、曝露群500例のうち50例が発症し、非曝露群500例のうち25例が発症した。
(1) 相対リスクと、その95%信頼区間を対数法で求めてください。
(2) リスク差と、その95%信頼区間を求めてください。
(3) 同じ表のオッズ比を求め、発症がまれでない場合にオッズ比と相対リスクが乖離する理由を、リスク0.40と0.25の例で述べてください。
解答
(1) リスクは、曝露群が \(50/500=0.10\)、非曝露群が \(25/500=0.05\) です。
相対リスクは \(RR=0.10/0.05=2.0\) です。
対数法の標準誤差は \(\sqrt{1/50-1/500+1/25-1/500}=\sqrt{0.056}\approx0.2366\) です。
95%信頼区間は \(\exp(\log 2.0\pm1.96\times0.2366)\) より、\((1.258,\ 3.180)\) です。
(2) リスク差は \(RD=0.10-0.05=0.05\) です。
標準誤差は \(\sqrt{0.1\times0.9/500+0.05\times0.95/500}\approx0.0166\) です。
95%信頼区間は \(0.05\pm1.96\times0.0166\) より、\((0.0175,\ 0.0825)\) です。
(3) 同じ表のオッズ比は \(\frac{50\times475}{450\times25}\approx2.111\) です。
発症がまれなため、相対リスク2.0に近い値になっています。
一方、リスク0.40と0.25の例では \(RR=1.6\) に対して \(OR=\frac{0.4/0.6}{0.25/0.75}=2.0\) です。
オッズはリスクより大きく振れるため、発症がまれでないとオッズ比は相対リスクより1から遠く離れます。
検算:相対リスクの区間の下限は1より大きく、リスク差の区間の下限は0より大きいです。2つの尺度で結論が一致します。
Rで答え合わせ
# 例題4:相対リスク・リスク差と信頼区間
a <- 50; n1 <- 500; c <- 25; n0 <- 500
p1 <- a / n1; p0 <- c / n0
rr <- p1 / p0
se_rr <- sqrt(1 / a - 1 / n1 + 1 / c - 1 / n0)
rd <- p1 - p0
se_rd <- sqrt(p1 * (1 - p1) / n1 + p0 * (1 - p0) / n0)
c(RR = rr, lower = exp(log(rr) - 1.96 * se_rr), upper = exp(log(rr) + 1.96 * se_rr))
c(RD = rd, lower = rd - 1.96 * se_rd, upper = rd + 1.96 * se_rd)
(a * (n0 - c)) / ((n1 - a) * c)  # 同じ表のオッズ比
      RR    lower    upper
2.000000 1.257753 3.180276
        RD      lower      upper
0.05000000 0.01749708 0.08250292
[1] 2.111111
オッズ比を相対リスクと読み替えられるのは、発症がまれなときだけです。
臨床試験の有効率のように頻度の高いアウトカムでは、両者は大きく乖離します。
相対リスク2.0は「発症リスクが2倍」という相対的な大きさです。
リスク差0.05は「100人あたり5人多い」という絶対的な大きさです。
試験では、どちらの尺度で聞かれているかを問題文で見分けることが大切です。
層別分割表 ― Mantel-Haenszel推定とCMH検定
2×2表をそのまま合算すると、思わぬ落とし穴があります。
背景因子の分布が群間で偏っていると、その因子が結果を歪めるからです。これが交絡です。
対策は、背景因子で層別してから効果を推定することです。
層をまたいだ共通のオッズ比を推定するのがMantel-Haenszel法です。
その検定版がCMH検定(Cochran-Mantel-Haenszel検定)です。
臨床試験でも、施設や年齢層で層別した解析が実務で使われます。
例題5 Mantel-Haenszel推定とCMH検定
問題
新薬と標準薬の有効率を、年齢層で層別しました。度数は次のとおりです。
| 層 | 群 | 有効 | 無効 | 計 |
|---|---|---|---|---|
| 若年層 | 新薬群 | 56 | 24 | 80 |
| 若年層 | 標準群 | 12 | 8 | 20 |
| 高齢層 | 新薬群 | 6 | 14 | 20 |
| 高齢層 | 標準群 | 16 | 64 | 80 |
(1) 層別のオッズ比をそれぞれ求めてください。
(2) 粗オッズ比とMantel-Haenszel推定値を求め、差が生じる理由を説明してください。
(3) CMH検定の結果を読み、共通オッズ比の解釈と注意点を述べてください。
解答
(1) 層別オッズ比は、若年層が \(\frac{56\times8}{24\times12}\approx1.556\)、高齢層が \(\frac{6\times64}{14\times16}\approx1.714\) です。
2つの層でほぼそろっています。
(2) 層を合算すると、新薬群100例のうち有効62例、標準群100例のうち有効28例です。
粗オッズ比は \(\frac{62\times72}{38\times28}\approx4.195\) と、層別とは大きくずれます。
Mantel-Haenszel推定値は、各層の対角積を層の総数で重み付けして求めます。
\[OR_{MH}=\frac{56\times8/100+6\times64/100}{24\times12/100+14\times16/100}=\frac{8.32}{5.12}=1.625\]
差の理由は交絡です。新薬群には予後の良い若年層が多く割り付けられました。
年齢の効果が薬の効果に紛れ込み、粗オッズ比が過大になったのです。
(3) CMH検定の結果は \(\chi^2=1.628\)、\(p=0.202\) で、5%水準では有意ではありません。
共通オッズ比は1.625、95%信頼区間は \((0.770,\ 3.429)\) です。
ただし層あたりの例数が小さいため、検出力が不足しています。
「有意でない=効果がない」とは言えない点が注意点です。
検算:Mantel-Haenszel推定値1.625は、2つの層別オッズ比1.556と1.714の間にあります。重み付き平均として妥当な位置です。
Rで答え合わせ
# 例題5:Mantel-Haenszel推定とCMH検定
tab5 <- array(c(56, 12, 24, 8,
                6, 16, 14, 64), dim = c(2, 2, 2))
(56 * 8 / 100 + 6 * 64 / 100) / (24 * 12 / 100 + 14 * 16 / 100)  # MHオッズ比を手計算
(62 * 72) / (38 * 28)  # 粗オッズ比
mantelhaen.test(tab5, correct = FALSE)
[1] 1.625
[1] 4.195489

	Mantel-Haenszel chi-squared test without continuity correction

data:  tab5
Mantel-Haenszel X-squared = 1.628, df = 1, p-value = 0.202
alternative hypothesis: true common odds ratio is not equal to 1
95 percent confidence interval:
 0.7700012 3.4293777
sample estimates:
common odds ratio
            1.625
共通オッズ比1.625は、層別オッズ比がそろっているからこそ意味を持ちます。
層ごとに効果が大きく異なる場合は、1つの値にまとめず層別に報告します。
試験では、粗オッズ比と層別オッズ比の逆転に気づけるかが問われます。
r×c表と順序カテゴリ ― 残差分析と傾向検定
2×2より大きな表では、まず全体の独立性を検べます。
棄却されたら、どのセルが効いているかを残差で探ります。
カテゴリに順序がある場合は、順序の情報を使う傾向検定が強力です。
例題6 r×c表の独立性と調整済み残差
問題
3つの治療法(標準治療・新規A・新規B、各100例)の効果判定(著効・有効・無効)は次のとおりでした。
| 治療法 | 著効 | 有効 | 無効 |
|---|---|---|---|
| 標準治療 | 20 | 30 | 50 |
| 新規A | 35 | 35 | 30 |
| 新規B | 30 | 40 | 30 |
(1) 期待度数を求め、カイ二乗統計量と自由度を計算してください。
(2) 5%水準で判定してください。
(3) 調整済み残差を読み、どのセルが効いているか述べてください。
解答
(1) 列和は著効85・有効105・無効110です。各行の合計は100、全体は300なので、期待度数は行によらず著効 \(100\times85/300\approx28.33\)、有効35、無効 \(\approx36.67\) となります。
各セルの寄与を合計すると、カイ二乗統計量が得られます。
\[\chi^2=\sum\frac{(O-E)^2}{E}\approx12.819\]
自由度は \((3-1)\times(3-1)=4\) です。
(2) 自由度4の5%点は9.488です。\(12.819>9.488\) なので帰無仮説は棄却され、治療法と効果判定は独立ではないと結論づけます(p値 \(\approx0.0122\))。
(3) 調整済み残差は、期待度数からのずれを標準化した値です。絶対値が1.96を超えると、そのセルが有意にずれている目安になります。
大きいのは標準治療・無効の \(+3.39\) と標準治療・著効の \(-2.26\) です。標準治療で無効が多く著効が少ないことが、独立性からのずれの主因です。
検算:調整済み残差の符号を見ると、標準治療の行だけが「著効はマイナス、無効はプラス」で、新規A・新規Bと逆向きになっています。
Rで答え合わせ
# 例題6:r×c表の独立性検定と調整済み残差
tab6 <- matrix(c(20, 30, 50,
                 35, 35, 30,
                 30, 40, 30), nrow = 3, byrow = TRUE)
res6 <- chisq.test(tab6)
res6  # 検定結果
res6$expected  # 期待度数
res6$stdres    # 調整済み残差
	Pearson's Chi-squared test

data:  tab6
X-squared = 12.819, df = 4, p-value = 0.0122

         [,1] [,2]     [,3]
[1,] 28.33333   35 36.66667
[2,] 28.33333   35 36.66667
[3,] 28.33333   35 36.66667
           [,1]      [,2]      [,3]
[1,] -2.2649413 -1.283881  3.388695
[2,]  1.8119530  0.000000 -1.694347
[3,]  0.4529883  1.283881 -1.694347
全体の検定が有意(\(\chi^2\approx12.819\)、p値 \(\approx0.0122\))でも、「どの治療がどう違うか」までは分かりません。残差分析までをセットで報告するのが、準1級の型です。実務でも、全体検定だけで終わらせず、効いているセルを確認する習慣が大切です。
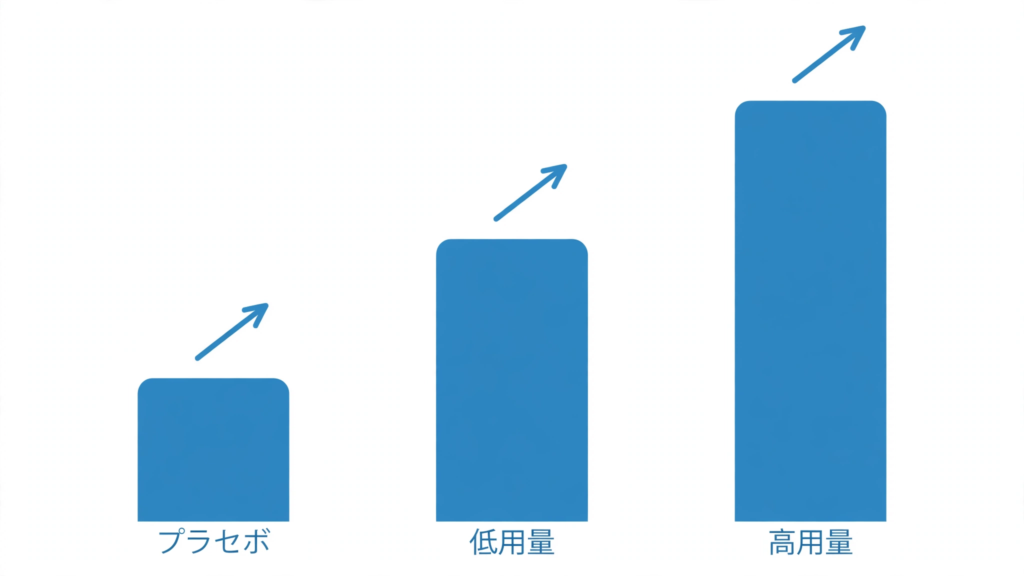
例題7 Cochran-Armitage傾向検定
問題
用量3群(プラセボ・低用量・高用量、各100例)の有効例数は、プラセボ20例、低用量30例、高用量45例でした。
(1) 通常の独立性検定(自由度2)と傾向検定(自由度1)の違いを述べてください。
(2) スコア0、1、2でCochran-Armitage傾向検定を行い、結果を解釈してください。
(3) 順序を数値として扱う考え方が、対数線形モデルやロジスティック回帰へどうつながるか述べてください。
解答
(1) 独立性検定は、順序を使わずに「どこかに差があるか」を検べます。傾向検定は、「用量とともに有効割合が増える(減る)か」という単調な変化に絞って検べます。
仮説を絞るぶん自由度が1になります。用量反応がある場面では、傾向検定のほうが検出力が高くなります。
(2) 全体の有効割合は \(95/300\approx0.3167\) で、各群の期待有効数は31.67です。スコアで重みづけたずれの合計は \(0\times(20-31.67)+1\times(30-31.67)+2\times(45-31.67)=25.0\) となります。
これを標準化すると \(Z\approx3.80\)、\(\chi^2\approx14.44\)、\(p\approx0.000145\) です。用量の増加に伴う有効割合の単調な増加が、強く示唆されます。
なお、スコアは等間隔であれば1、2、3でも検定統計量は変わりません。
(3) 順序カテゴリにスコアを与えて数値として扱う発想は、そのままモデル化につながります。対数線形モデルではカテゴリ間の関連をパラメータで表し、ロジスティック回帰では用量を説明変数として有効確率の変化を表します。
検定からモデルへ、という流れの入口がこの検定です。
検算:有効割合は0.20、0.30、0.45と単調に増えており、傾向検定の結論と方向が一致しています。
Rで答え合わせ
# 例題7:Cochran-Armitage傾向検定
prop.trend.test(c(20, 30, 45), c(100, 100, 100))
	Chi-squared Test for Trend in Proportions

data:  c(20, 30, 45) out of c(100, 100, 100) ,
 using scores: 1 2 3
X-squared = 14.442, df = 1, p-value = 0.0001446
\(\chi^2\approx14.44\)、\(p\approx0.000145\) と、用量反応の証拠は強いです。用量反応を検べる問題で独立性検定だけを書くと、順序の情報を使い切れていません。「順序あり→傾向検定」が反射的に出るようにしておきましょう。臨床試験の用量反応性の評価でも、同じ考え方が使われます。
受験対策・実務でのポイント
検定の使い分けは、表の形と期待度数で決まります。
- 期待度数に5未満のセルがある小標本の2×2表 → Fisher正確検定
- 標本が大きく期待度数が十分な2×2表 → カイ二乗検定(Yates補正は近似が粗いときの選択肢)
- 層別された2×2表 → Mantel-Haenszel推定とCMH検定(層別オッズ比がそろっているかも確認)
- r×c表 → 独立性検定に調整済み残差を添えて、効いているセルを特定
- 順序カテゴリ → Cochran-Armitage傾向検定
- 臨床試験では、施設や重症度で層別した有効率の解析にCMH検定が標準的に使われます
- 報告では検定結果だけでなく、オッズ比やリスク差と信頼区間を併記します
- 用量反応性は、傾向検定や用量を連続量として扱うモデルで評価します
行と列の主効果と交互作用をパラメータで表すことで、「独立かどうか」を含む仮説をモデルの形で比べられます。結果変数を1つに固定すると、ロジスティック回帰につながります。
分割表の問題は、表の形を見れば使う検定が決まります。
- 2×2か、層別か、r×cか、順序ありか
- 期待度数は十分か
📚 この記事をより深く理解するための参考書籍
『統計検定準1級対応 統計学実践ワークブック』日本統計学会 編(学術図書出版社)

『日本統計学会公式認定 統計検定 準1級 公式問題集』日本統計学会 編(実務教育出版、2021年)

『現代数理統計学の基礎』久保川達也(共立出版)

生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
関連記事・次のステップ
- 分割表の独立性の検定:製薬統計の現場での理論と実装
- 統計検定準1級「仮説検定」攻略 ― ネイマン・ピアソンの補題・尤度比検定・検出力の典型出題対策 ―
- 統計検定準1級「統計的因果推論」攻略 ― 潜在的結果・傾向スコア・操作変数法の典型出題対策 ―
- 統計検定準1級 攻略ガイド ― 出題範囲・勉強法・おすすめ参考書を生物統計家が徹底解説 ―
まとめ
本記事では、統計検定準1級の「分割表」を、例題7問で整理しました。
カイ二乗検定では、期待度数とYates補正を確認しました。
Fisher正確検定では、周辺を固定した超幾何分布から両側p値 \(0.0406\) を読み解きました。
効果の尺度では、オッズ比 \(2.25\)、相対リスク \(2.0\)、リスク差 \(0.05\) を信頼区間つきで計算しました。
層別解析では、粗オッズ比 \(4.20\) が交絡で膨らみ、Mantel-Haenszel推定で \(1.625\) になることを確認しました。
r×c表では調整済み残差で効いているセルを特定し、傾向検定では用量反応を自由度1で捉えました。
本番で大切なのは、公式よりも、表の形を見て使う道具を見分けることです。
「期待度数が小さい」と気づけばFisher正確検定、「層がある」と気づけばMantel-Haenszel、という対応を体に覚えさせてください。
例題2と例題5は、考え方そのものが答案になるタイプです。白紙から再現できれば、この分野は得点源にできます。
次の一歩としては、独立性検定の理論を扱う分割表の独立性の検定と、検定の枠組みを扱う統計検定準1級「仮説検定」攻略をあわせてご覧ください。