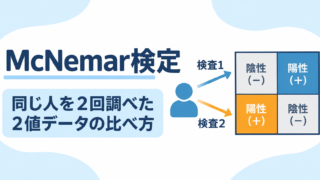
【やさしく解説】McNemar検定(マクネマー検定)とは ― 対応のある2値データの比べ方をRとSASで体感する ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- McNemar検定とは何か、どんなデータに使うか(対応のある2値データ)
- 答えが分かれたペア(不一致ペア)だけを見る理由と、検定統計量の計算式
- Rの
mcnemar.test()と正確検定(binom.test())の使い方 - 対応を無視してしまったときの、典型的な間違い2つ
- SASの
PROC FREQでの実装
はじめに
同じクラスの生徒に「数学が好きですか?」と1学期と3学期に尋ねたところ、「好き」と答えた人が増えていました。これは本当に増えたと言えるでしょうか。ここで大切なのは、同じ生徒に2回聞いているという点です。1学期に好きだった生徒は3学期も好きと答えやすく、2回の答えは互いに似ています。
医療や製薬の現場にも、同じ形のデータはよくあります。同じ患者に新旧2つの検査を行う、治療の前後で症状の有無を比べる、といった場面です。こうした「同じ人を2回調べた」「はい/いいえ」のデータを比べる方法が、McNemar検定(マクネマー検定)です。
本記事は、統計を学び始めた方、製薬企業で働く非統計職の方、若手の生物統計担当者の方に向けて、専門用語をかみ砕きながら進めます。Rを触ったことがない方は、先にR入門 ― インストールからデータ読み込み・要約をご覧ください。
McNemar検定とは ― 「同じ人を2回調べた」2値データの比べ方
2値データとは、「陽性/陰性」「あり/なし」「改善した/しなかった」のように、答えが2通りしかないデータのことです。McNemar検定は、この2値データが同じ人から2回とられたときに、2回の陽性率に差があるかを調べる方法で、1947年に心理学者の Quinn McNemar が提案しました。
対応のあるデータとは何か
同じ人(同じ単位)から2回とったデータを対応のあるデータ(paired data)と呼びます。例は、同じ患者への2種類の検査、同じ人の治療前と治療後、年齢や性別をそろえて1対1で組にした2人(マッチドペア)などです。2つの値は同じ人のものなので似やすく、独立ではありません。一方、ランダムに2群へ分けた臨床試験のように、A群とB群が別々の人なら対応のない(独立な)データです。
データの種類と、対応の有無による検定の使い分けをまとめます。
| データの種類 | 対応のない(独立な)2群 | 対応のある2回の測定 |
|---|---|---|
| 連続データ | 2標本t検定 | 対応のあるt検定 |
| 2値データ | カイ二乗検定・Fisherの正確検定・比率の差の検定 | McNemar検定 |
連続データの対応版が対応のあるt検定で、2値データの対応版がMcNemar検定です。対応のあるt検定は対応のあるt検定とウィルコクソン符号順位検定、2値データの独立な2群で使うカイ二乗検定は分割表の独立性の検定で詳しく扱っています。
答えが分かれたペアだけを見る理由
同じ人に検査1と検査2を行った結果は、次の2×2の分割表にまとめられます。本記事ではこの記号を使います。
| 検査2が陽性 | 検査2が陰性 | |
|---|---|---|
| 検査1が陽性 | \(a\):両方陽性(一致) | \(b\):検査1だけ陽性(不一致) |
| 検査1が陰性 | \(c\):検査2だけ陽性(不一致) | \(d\):両方陰性(一致) |
人数(ペアの数)は \(n=a+b+c+d\) です。検査1の陽性率は \((a+b)/n\)、検査2の陽性率は \((a+c)/n\) なので、その差は次のとおりです。
\[ \frac{a+b}{n}-\frac{a+c}{n}=\frac{b-c}{n} \]
言葉にすると、陽性率の差を決めるのは \(b\) と \(c\)、つまり答えが分かれた人(不一致ペア)だけで、\(a\) と \(d\) は消えます。2人の審査員が作品に点をつける場面で考えてみましょう。2人とも○をつけた作品や2人とも×をつけた作品は、「どちらの審査員が甘いか」の判断材料になりません。意見が分かれた作品の偏りだけが手がかりになるのと同じです。
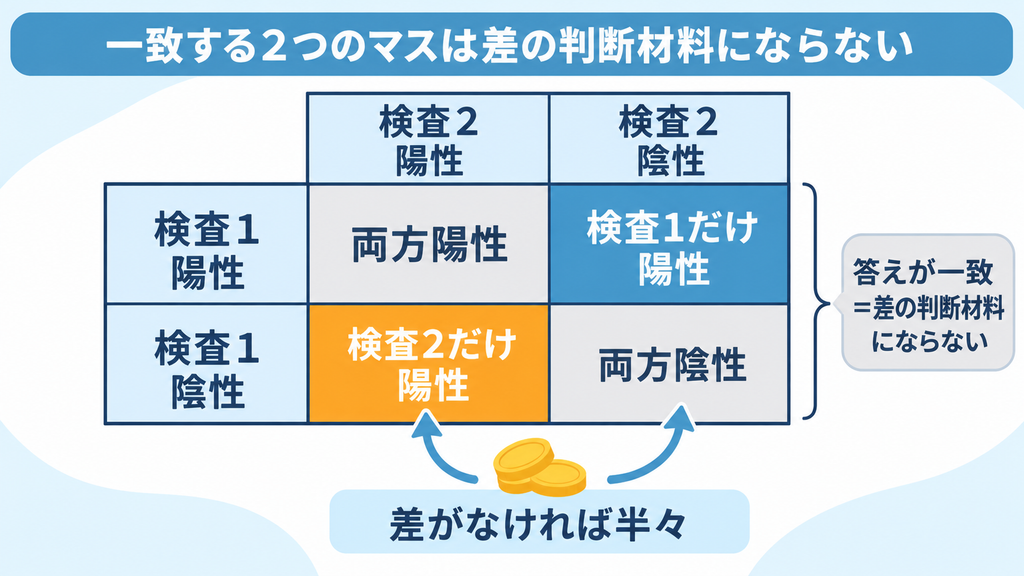
差がない(2つの検査の陽性率が等しい)という帰無仮説は、\(b\) と \(c\) が同じくらい起こる、つまり不一致ペアの中で「検査1だけ陽性」になる確率が0.5(コイン投げの表と裏が半々)と言い換えられます。この考えから、検定統計量は次の式になります。
\[ \chi^2=\frac{(b-c)^2}{b+c} \]
\(b\) と \(c\) の差の2乗を、不一致ペアの数 \(b+c\) で割った値です。差がなければ0に近く、差が大きいほど大きくなり、帰無仮説のもとでおおよそ自由度1のカイ二乗分布に従います。さらに、人数は整数でとびとびの値しかとらないのになめらかな分布で近似するずれを小さくする連続性補正を使うと、次の式になります。Rの mcnemar.test() は既定で補正ありです。
\[ \chi^2_{\text{補正}}=\frac{(|b-c|-1)^2}{b+c} \]
近似を使わない方法が正確検定(exact test)です。「\(b+c\) 回コインを投げて表が \(b\) 回以上(または同じくらい偏る)確率」を二項分布で直接計算します。不一致ペアの数 \(b+c\) が少ないときは近似より安全で、一つの目安として \(b+c\) が25未満なら正確検定を使うことが多いです。検定結果の読み方に自信がない方は、p値とは何か?もあわせてご覧ください。
McNemar検定が見ているのは不一致ペアだけです。だから、両方陽性・両方陰性の一致した人がどれだけ多くても、検定統計量は変わりません。
ここまでのまとめ
- McNemar検定は、同じ人から2回とった(対応のある)2値データの陽性率を比べる方法です。
- 陽性率の差は \((b-c)/n\) で、決め手は不一致ペアの \(b\) と \(c\) だけです。
- \(b+c\) が少ないときは、近似ではなく正確検定を使います。
次章で、Rを使って実際に計算してみます。
RでMcNemar検定をやってみる ― 新しい迅速検査と標準検査の陽性率を比べる
ここからは、実際にRでMcNemar検定を動かしてみます。使うのは、150人の患者に「新しい迅速検査」と「従来の標準検査」の両方を実施した、という設定のデータです。結果は、両方陽性が52人、新検査だけ陽性が18人、標準検査だけ陽性が6人、両方陰性が74人でした。なお、これは説明のために作った架空のデータで、実在の検査の性能を示すものではありません。また、ここで比べるのは「どちらの陽性率が高いか」であり、「どちらの検査が正しいか(感度・特異度)」は別の問題です。
Rでの実装
データを作って2×2表にまとめる
まず、150人分のデータを作って2×2の分割表にまとめます。
# 150人の患者に「新しい迅速検査」と「標準検査」の両方を実施した結果(1行が1人)
dat <- data.frame(
  new = rep(c("陽性", "陽性", "陰性", "陰性"), times = c(52, 18, 6, 74)),
  std = rep(c("陽性", "陰性", "陽性", "陰性"), times = c(52, 18, 6, 74))
)
dat$new <- factor(dat$new, levels = c("陽性", "陰性"))
dat$std <- factor(dat$std, levels = c("陽性", "陰性"))

nrow(dat)
tab <- table(新検査 = dat$new, 標準検査 = dat$std)   # 2×2の分割表にまとめる
addmargins(tab)                                       # 周辺の合計も表示
round(c(新検査 = mean(dat$new == "陽性"), 標準検査 = mean(dat$std == "陽性")), 3)
実行すると、次の出力が得られます。
[1] 150
      標準検査
新検査 陽性 陰性 Sum
  陽性   52   18  70
  陰性    6   74  80
  Sum    58   92 150
  新検査 標準検査
   0.467    0.387
このコードは、rep() で同じ値を指定回数くり返し、「両方陽性52人・新検査だけ陽性18人・標準検査だけ陽性6人・両方陰性74人」の150人分を1行1人のデータとして作っています。factor() は「陽性」を先に並べる指定です。table() で2×2の分割表にまとめ、addmargins() で周辺の合計を足し、最後に mean() で各検査の陽性率を計算しています。
表から \(a=52,\ b=18,\ c=6,\ d=74\) と読み取れます。陽性率は新検査が46.7%(70/150)、標準検査が38.7%(58/150)で、差は0.467−0.387=0.080、つまり8ポイントです。答えが分かれた人は \(b+c=24\) 人だけで、残りの126人(52+74)は両方の検査で同じ結果でした。
McNemar検定を実行する(補正あり・なし)
次に、mcnemar.test() に表 tab を渡します。
mcnemar.test(tab)                    # 連続性補正あり(Rの既定)
mcnemar.test(tab, correct = FALSE)   # 連続性補正なし
	McNemar's Chi-squared test with continuity correction

data:  tab
McNemar's chi-squared = 5.0417, df = 1, p-value = 0.02474


	McNemar's Chi-squared test

data:  tab
McNemar's chi-squared = 6, df = 1, p-value = 0.01431
mcnemar.test() は表を渡すだけでMcNemar検定を行う関数で、既定では連続性補正ありです。correct = FALSE を付けると補正なしの結果になります。
- 補正なしの値6は、手計算 \((18-6)^2/(18+6)=144/24=6\) と一致します。補正ありは \((|18-6|-1)^2/24=121/24\approx5.04\) です。
- 補正ありでp=0.025、補正なしでp=0.014です。どちらも0.05を下回り、「2つの検査の陽性率に差はない」という仮説は否定されます。
- 補正ありの方がp値が大きくなります(慎重な側に寄ります)。Rは既定で補正ありなので、論文やレポートではどちらを使ったかを明記しましょう。
正確検定(二項検定)を実行する
不一致ペアが少ないときは、近似を使わない正確検定が安全です。Rでは binom.test() を使います。
binom.test(tab[1, 2], tab[1, 2] + tab[2, 1], p = 0.5)
	Exact binomial test

data:  tab[1, 2] and tab[1, 2] + tab[2, 1]
number of successes = 18, number of trials = 24, p-value = 0.02266
alternative hypothesis: true probability of success is not equal to 0.5
95 percent confidence interval:
 0.5328872 0.9022696
sample estimates:
probability of success
                  0.75
binom.test() の第1引数は「表が出た回数」(ここでは新検査だけ陽性の18組)、第2引数は「投げた回数」(不一致ペアの合計24組)、p = 0.5 は帰無仮説のもとでの確率です。tab[1, 2] は表の1行2列目なので \(b\)、tab[2, 1] は \(c\) にあたります。
24組の不一致ペアのうち18組(75%)が「新検査だけ陽性」でした。差がなければ半々(12組ずつ)くらいになるはずなのに、偏っています。正確検定のp=0.023です。この例は \(b+c=24\) で目安の25を下回るので、報告には正確検定を使うのが安全です。95%信頼区間0.533〜0.902は「不一致ペアのうち新検査だけ陽性になる割合」の区間で、0.5を含みません。
この信頼区間の考え方は、二項比率の信頼区間の記事で詳しく解説しています。また、正確検定はp値がやや大きめに出やすい(保守的な)性質があり、それを和らげる mid-p値という工夫もあります。気になる方は連続分布のp値と離散分布のp値、そしてmid-p値の意義をご覧ください。
ここまでのまとめ
- McNemar検定は、表を作って
mcnemar.test(tab)を呼ぶだけで実行でき、補正の有無はcorrectで切り替えます。 - この例では、補正ありでp=0.025、補正なしでp=0.014、正確検定でp=0.023となり、いずれも差ありと判断されます。
- 不一致ペアが24組と少ないので、報告には正確検定が安全です。
SASでの実装
SASでは PROC FREQ を使います。次のコードは、表の4つのマスの人数(度数)を入力して集計する書き方です。
/* 2×2表の4つのマスの人数を入力する(pos=陽性, neg=陰性) */
data test;
  input new $ std $ count;
  datalines;
pos pos 52
pos neg 18
neg pos 6
neg neg 74
;
run;

/* McNemar検定(AGREEオプション)と正確検定(EXACT MCNEM) */
proc freq data=test order=data;
  tables new*std / agree;
  weight count;
  exact mcnem;
run;
主要なステートメントとオプションは次のとおりです。
WEIGHT count;:1行1人のデータでなくても、表の4つのマスの人数(度数)を入力し、WEIGHT文で度数の変数を指定すれば、集計表として扱えます。order=data:表の行・列の並びを入力した順(pos→neg)にする指定です。指定しないと、既定では値の並べ替え順(アルファベット順で neg が先)になります。tables new*std / agree;:AGREEオプションを付けると、2×2表ではMcNemar検定の結果が出力されます。一致度の指標であるκ係数も一緒に出力されます。exact mcnem;:EXACT文のMCNEMで、McNemar検定の正確検定(p値)を求めます。
SASが出力するMcNemar統計量は連続性補正なしの式 \((b-c)^2/(b+c)\) で、Rで
correct = FALSE を指定したときと同じ式です。Rの既定(補正あり)とは式が違うので、RとSASの結果を突き合わせるときは、補正の有無をそろえてください。なお、3×3以上の表に AGREE を使うと、McNemar検定を拡張したBowkerの対称性の検定が出力されます。SASの出力で、McNemar統計量の値がRの補正なしの結果と一致するかを確かめると、実装の検算になります。
よくある間違いと、差の大きさの示し方
ここでは前章で作った tab をそのまま使います。検定の選び方を間違えると何が起きるのか、初心者がやりがちな間違いを2つ試してみましょう。
対応を無視して検定するとどうなるか
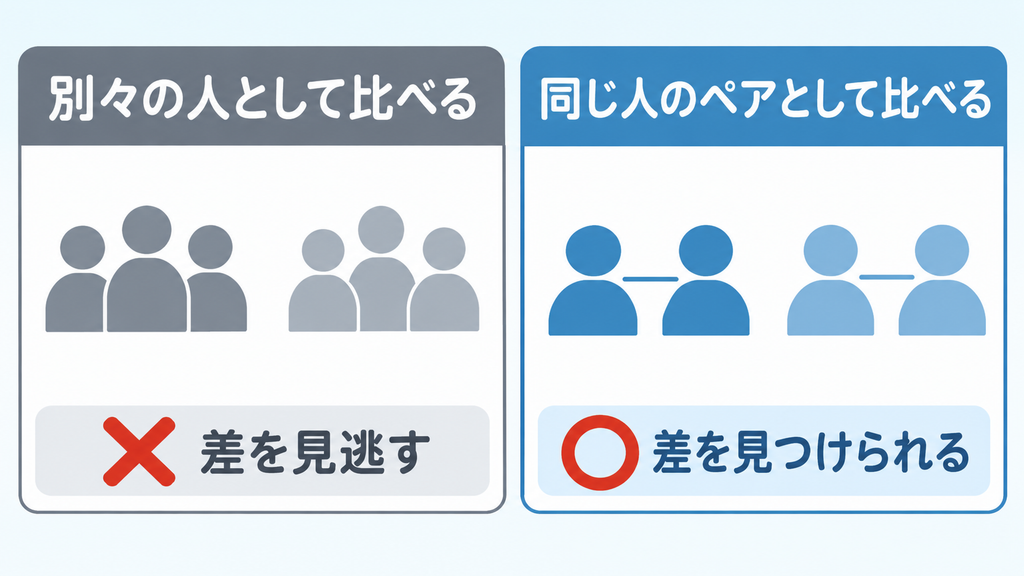
間違い1は、同じ150人を2回調べたのに「別々の150人ずつ」として比べてしまうこと。間違い2は、対応のある表にふつうのカイ二乗検定を使ってしまうことです。
# よくある間違い1:対応を無視して「独立した2群」の陽性率として比べる
prop.test(x = c(70, 58), n = c(150, 150))
# よくある間違い2:対応のある表にそのままカイ二乗検定(独立性の検定)を使う
chisq.test(tab)
	2-sample test for equality of proportions with continuity correction

data:  c(70, 58) out of c(150, 150)
X-squared = 1.6488, df = 1, p-value = 0.1991
alternative hypothesis: two.sided
95 percent confidence interval:
 -0.03823487  0.19823487
sample estimates:
   prop 1    prop 2
0.4666667 0.3866667


	Pearson's Chi-squared test with Yates' continuity correction

data:  tab
X-squared = 67.427, df = 1, p-value < 2.2e-16
このコードは、1つ目で陽性70人と58人を「独立な2群」として比較し、2つ目で2×2表に通常のカイ二乗検定をかけています。結果を整理します。
| 方法 | 答えている問い | p値 | 判定 |
|---|---|---|---|
| McNemar検定(補正あり) | 2つの検査の陽性率に差があるか(対応を考慮) | 0.025 | 差あり |
| 正確検定(二項検定) | 同上 | 0.023 | 差あり |
独立2群の比率の差の検定(prop.test) | 陽性率に差があるか(対応を無視) | 0.199 | 差を見逃す |
通常のカイ二乗検定(chisq.test) | 2つの検査の結果に関連があるか | 2.2e-16未満 | 別の問いに答えている |
間違い1:差を見逃す。独立2群の方法は、同じ人どうしが似ている部分(両方陽性52人・両方陰性74人の126人)まで「偶然のばらつき」として扱います。そのためp値は0.20と大きくなり、差の95%信頼区間も−0.038〜0.198と0をまたぐ広い幅になってしまいます。
間違い2:別の問いに答えている。X-squared=67.427、p<2.2e-16は、「新検査で陽性の人は標準検査でも陽性になりやすいか」という関連の検定です。同じ人を調べているので関連があるのは当然で、陽性率の差については何も言っていません。p値が小さいので「差がある」と誤読しやすい点に注意してください。
どちらも、最初に「データに対応があるか」を確認すれば防げます。比率の差の検定は比率の差の検定と信頼区間について徹底解説で詳しく解説しています。
chisq.test() に対応のある2×2表を入れてもエラーにならず、小さなp値が出てしまいます。ソフトは「データに対応があるか」を判断してくれないので、検定を選ぶ前に自分で確認しましょう。陽性率の差と条件付きオッズ比を信頼区間つきで示す
p値は「差があるかどうか」しか教えてくれません。差の大きさは、推定値と信頼区間で示します。まず陽性率の差です。
\[ \hat{\delta}=\frac{b-c}{n},\qquad SE(\hat{\delta})=\frac{\sqrt{(b+c)-(b-c)^2/n}}{n} \]
\(\hat{\delta}\)(デルタ・ハット)は陽性率の差の推定値、\(SE\) は標準誤差(推定値のブレの大きさ)で、対応を考慮した式です。95%信頼区間は \(\hat{\delta}\pm1.96\times SE\)(Wald型)です。もう一つの指標が、不一致ペアの比である条件付きオッズ比です。
\[ OR_{\text{条件付き}}=\frac{b}{c} \]
答えが分かれたペアの中で「新検査だけ陽性」が「標準検査だけ陽性」の何倍起きたかを表します。信頼区間は、正確検定で求めた割合 \(p\) の信頼区間を \(p/(1-p)\) で変換して求めます。
n   <- sum(tab)
n12 <- tab[1, 2]   # 新検査だけ陽性
n21 <- tab[2, 1]   # 標準検査だけ陽性
diff <- (n12 - n21) / n                               # 陽性率の差
se   <- sqrt((n12 + n21) - (n12 - n21)^2 / n) / n      # 対応を考慮した標準誤差
round(c(diff = diff, lower = diff - 1.96 * se, upper = diff + 1.96 * se), 3)
# 不一致ペアの比=条件付きオッズ比と、正確な95%信頼区間
ci_p <- binom.test(n12, n12 + n21)$conf.int
round(c(OR = n12 / n21, lower = ci_p[1] / (1 - ci_p[1]), upper = ci_p[2] / (1 - ci_p[2])), 2)
 diff lower upper
0.080 0.017 0.143
   OR lower upper
 3.00  1.14  9.23
このコードは、表から \(b\)(n12)と \(c\)(n21)を取り出し、前半で陽性率の差、後半で条件付きオッズ比を信頼区間つきで計算しています。
陽性率の差は0.080(8.0ポイント)、95%信頼区間は0.017〜0.143です。0を含まないので、新検査の方が陽性率が高いと言えます。対応を無視した
prop.test() の区間(−0.038〜0.198)よりずっと狭く、対応を考慮すると精度よく推定できることが分かります。条件付きオッズ比は3.00(18÷6)、95%信頼区間は1.14〜9.23で、1を含みません。区間が広いのは、不一致ペアが24組しかないためです。p値だけでなく、差の大きさと信頼区間を一緒に報告するのが基本です。なお、人数が少ないとWald型の区間は精度が落ちます。オッズ比はオッズ比・相対リスク・ハザード比の違いで整理しています。
ここまでのまとめ
- 対応のあるデータを独立2群として比べると差を見逃し、通常のカイ二乗検定は「関連」という別の問いに答えてしまいます。
- 検定を選ぶ第一歩は、データに対応があるかの確認です。
- 陽性率の差0.080(0.017〜0.143)と条件付きオッズ比3.00(1.14〜9.23)を、信頼区間つきで報告しましょう。
実務でのポイント ― McNemar検定が使える場面と注意点
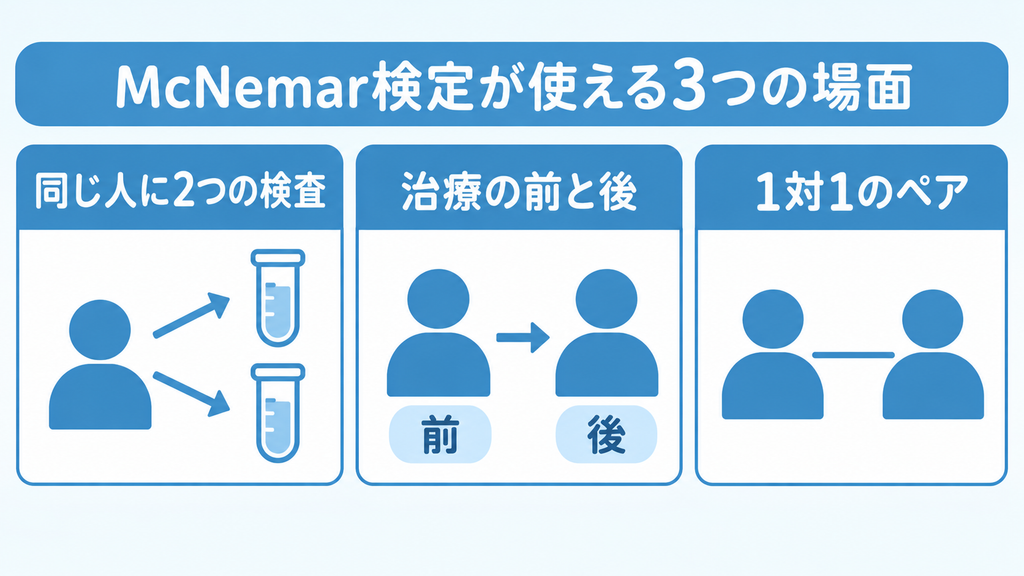
使える場面は、同じ人に2つの検査を使って陽性率を比べるとき、同じ人の治療前後で「症状あり」の割合を比べるとき、年齢・性別などをそろえて1対1で組にしたデータ(マッチドペア)です。同じ人が2つの治療を順番に受けるクロスオーバー試験の2値データにも考え方はつながります(詳しくはクロスオーバー試験の理論と実務)。
前後比較の落とし穴として、治療前後で陽性率が下がっても、治療の効果とは限りません。時間とともに自然に良くなることもあれば、症状が強いときに受診した人は次の測定で落ち着きやすい(平均への回帰)こともあります。効果を示すには、対照群を置いたランダム化比較試験が基本です。
「差」と「一致」は別の問いです。McNemar検定は「陽性率に差があるか」を見るもので、「2つの検査の結果がどれくらい一致するか」はκ係数で評価します(級内相関係数(ICC)・κ係数・Bland-Altman)。また「どちらの検査が正しいか」は感度・特異度の問題で、ROC曲線とAUCをRで実装するで扱います。
検定を実行するときの注意は3つです。不一致ペアが少ないときは正確検定を使う、連続性補正の有無を明記する、3カテゴリ以上の表ではBowkerの対称性の検定を使う、です。Rの mcnemar.test() も3×3以上の表を入れると対称性の検定になります。
McNemar検定を使うときのチェックリスト
- データに対応があるか(同じ人・マッチドペア)を確認したか
- 不一致ペアの数 \(b+c\) を確認し、少なければ正確検定を使ったか
- 連続性補正の有無を明記したか
- p値だけでなく、差(または条件付きオッズ比)と95%信頼区間を示したか
- 前後比較なら、対照群がないことの限界を考えたか
📚 この記事をより深く理解するための参考書籍
対応のある2値データの検定を、医療の具体例とソフトの操作で確かめながら身につけられる3冊を紹介します。いずれもMcNemar検定を扱う節があります。



関連記事・次のステップ
分割表の検定を一通り押さえたい方は、対応のない2群の比べ方を分割表の独立性の検定とFisherの正確検定で、施設や層ごとに分かれた2×2表のまとめ方をコクラン・マンテル・ヘンツェル検定でご覧ください。比率の信頼区間をきちんと選びたい方には二項比率の信頼区間が直接の続きになります。
「対応のあるデータ」の考え方を広げたい方は、連続データ版の対応のあるt検定とウィルコクソン符号順位検定と、同じ人が2つの治療を順番に受けるクロスオーバー試験の理論と実務がおすすめです。2つの測定がどれだけ一致するかは級内相関係数(ICC)・κ係数・Bland-Altmanで扱っています。
統計の基礎をやさしく固めたい方は、【やさしく解説】平均値と中央値の違い・【やさしく解説】標準偏差(SD)と標準誤差(SE)の違い・p値とは何か?を順に読むと、検定結果を読むための土台がそろいます。資格の勉強に活かしたい方は統計検定2級「仮説検定・区間推定」攻略もあわせてどうぞ。
まとめ
本記事では、同じ人を2回調べた2値データを比べるMcNemar検定を、架空の検査データとRで確かめながら整理しました。
McNemar検定の考え方の中心は、「答えが分かれた人だけを見る」ことです。2つの検査の陽性率の差は \((b-c)/n\) となり、両方陽性・両方陰性の人は差に関わりません。150人の例では、新検査の陽性率46.7%・標準検査38.7%の差は、不一致だった24人の内訳(新検査だけ陽性18人、標準検査だけ陽性6人)で決まっていました。McNemar検定は補正ありで p=0.025、不一致ペアが25未満のため安全な正確検定でも p=0.023 で、陽性率の差を検出できました。
一方、同じデータを「別々の150人ずつ」として比べると p=0.20 となり、差を見逃します。対応のある表にそのまま通常のカイ二乗検定をかけると p は極端に小さくなりますが、それは2つの検査の結果に関連があるかという別の問いの答えでした。結果を報告するときは、陽性率の差0.080(95%信頼区間 0.017〜0.143)や条件付きオッズ比3.00(1.14〜9.23)のように、差の大きさと信頼区間を添えることが大切です。
検定を選ぶ前に「データに対応があるか」を確かめる。この一歩を習慣にするだけで、前後比較や検査法の比較での読み違いを大きく減らせます。次の一歩として、連続データでの同じ考え方を対応のあるt検定とウィルコクソン符号順位検定で、比率の信頼区間の選び方を二項比率の信頼区間で確かめていただければと思います。