制限付き3次スプライン(RCS)とは ― 連続変数の非線形な効果をRのrmsとSASで描く ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- 制限付き3次スプライン(RCS)とは何か、カテゴリ化や多項式となぜ違うのか
- ノット(結び目)の意味と、Harrellの推奨ノット位置
- Rのrmsパッケージで当てはめ、非線形性を検定し、オッズ比の曲線で示す方法
- SASの
EFFECT文での実装と、Rとノット位置をそろえる工夫 - ノット数の選び方と、解析計画・結果の報告での実務ポイント
はじめに
臨床試験や観察研究の回帰モデルでは、年齢・BMI・ベースライン値・用量といった連続変数を扱います。これをそのままモデルに入れると、「1増えるごとに効果が一定量ずつ変わる」という直線の関係を仮定したことになり、U字型やプラトー(頭打ち)の関係を見落としてしまいます。かといって、「65歳以上/未満」のように区切ってしまうと、今度は情報を失います。
その中間にある手法が制限付き3次スプライン(RCS)です。ロジスティック回帰、Cox回帰、共変量調整など、幅広い場面で使われます。この記事は、製薬企業・CROの生物統計担当者、臨床研究・疫学研究で回帰モデルを使う研究者、統計を学ぶ大学院生の方を想定しています。ロジスティック回帰の基本は2値変数とロジスティック回帰の記事で、Rを触ったことがない方はR入門の記事で確認しておくと、スムーズに読み進められます。
制限付き3次スプライン(RCS)とは ― 直線でもカテゴリ化でもない第3の選択肢
回帰モデルに連続変数をそのまま入れると、「その変数が1増えるごとに(ロジスティック回帰なら対数オッズが)一定量だけ変わる」という線形性を仮定することになります。しかし、BMIのように低すぎても高すぎてもリスクが上がる変数では、この仮定は成り立ちません。残差の形から直線の仮定を疑う流れは、線形回帰の“本質”をつかむの記事で詳しく扱っています。
カテゴリ化と多項式では何が困るのか
直線をやめる方法として、まず思いつくのが連続変数のカテゴリ化です。しかし、次の4つの問題があります。
- 情報の損失:グループ内の違いを捨てるので、検出力が落ちます
- 階段状の関係:境界の前後で急にリスクが跳ぶという、不自然な形になります
- カットポイントの恣意性:データを見てから区切りを決めると、結果が都合よく動いてしまいます
- 残差交絡:調整に使う共変量の場合、グループ内に残った違いが交絡の調整不足を生みます
もう一つの方法が多項式(2乗項・3乗項)の追加です。ただし、曲線全体が1つの式で決まるため、一部のデータ、とくに両端の極端な値が全体の形を振り回し、端で暴れやすくなります。
| 方法 | 関係の形の表し方 | 主な弱点 |
|---|---|---|
| 直線 | 1増えるごとに一定量の変化 | U字型・J字型・プラトーを表せない |
| カテゴリ化 | 階段状 | 情報の損失、カットポイントの恣意性、残差交絡 |
| 多項式 | 1つの式で滑らかな曲線 | 端の極端な値に振り回され、暴れやすい |
| 制限付き3次スプライン | 区間ごとの3次式を滑らかにつなぐ曲線 | 係数の値は直接解釈しにくい(曲線で解釈する) |
ノットと「制限付き」の意味
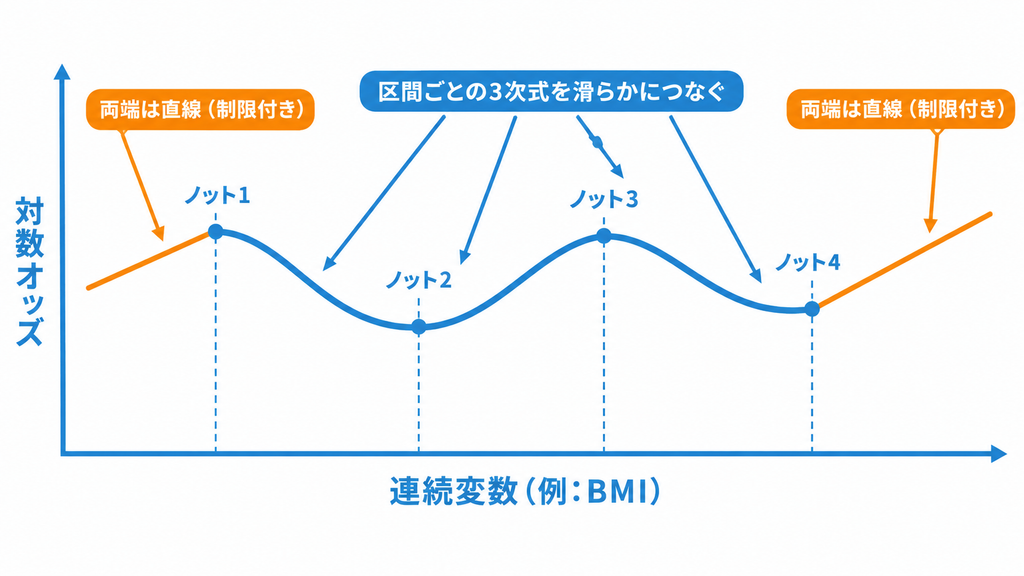
スプラインとは、変数の範囲をノット(knot:結び目)と呼ぶ点で区切り、区間ごとに3次多項式を当てはめ、ノットの位置で滑らかにつないだ曲線です。「滑らかに」とは、つなぎ目で値・傾き・曲がり具合が連続になるという意味です。
ただし、ふつうの3次スプラインはデータの少ない両端で暴れやすい弱点があります。そこで「最初のノットより左と、最後のノットより右では直線にする」という制限を加えたものが制限付き3次スプライン(restricted cubic spline:RCS)で、自然3次スプライン(natural cubic spline)とも呼ばれます。ノットを \(t_1<t_2<\cdots<t_k\)、\((u)_+=\max(u,0)\) とすると、次の式で表せます。
\[ f(x)=\beta_0+\beta_1x+\sum_{j=1}^{k-2}\beta_{j+1}X_j(x) \]
\[ X_j(x)=(x-t_j)_+^3-(x-t_{k-1})_+^3\frac{t_k-t_j}{t_k-t_{k-1}}+(x-t_k)_+^3\frac{t_{k-1}-t_j}{t_k-t_{k-1}} \]
意味を整理します。\(\beta_1x\) が直線部分、\(X_j(x)\) が曲がりを表す部分です。\(X_j\) の後ろ2項は、最後のノットより右で2乗・3乗の項が打ち消し合い、直線になるように調整しています。なお、Rのrmsパッケージは、尺度をそろえるために \(X_j\) を \((t_k-t_1)^2\) で割っています。
パラメータ数も重要です。ノットが \(k\) 個のRCSは、切片を除いて \(k-1\) 個の係数(直線部分1個+非線形部分 \(k-2\) 個)で表せます。ノット4個なら3個です。通常の3次スプラインよりはるかに少ない自由度で、柔軟な曲線を表現できます。
ノットの位置は、Frank E. Harrell Jr. の著書 Regression Modeling Strategies(Springer)の推奨が広く使われ、rmsパッケージの既定にもなっています。変数の分布のパーセンタイル(下から何%の位置か)に置きます。
| ノット数 | ノットを置くパーセンタイル | 向いている場面 |
|---|---|---|
| 3個 | 10%・50%・90% | 症例数が少ない |
| 4個 | 5%・35%・65%・95% | 迷ったらまずこれ |
| 5個 | 5%・27.5%・50%・72.5%・95% | 症例数が多い |
ノット数は3〜5個で十分なことが多く、症例数が少なければ3個、多ければ5個、迷えば4個が目安です。
RCSの係数の値は、基底関数の定義(rmsは尺度を調整しています)によって変わります。そのため、解釈は係数ではなく、推定された曲線で行うのが原則です。「この係数は何を意味するのか」と悩むのではなく、曲線とそこから求めたオッズ比を読む、と覚えておきましょう。
次章で、真の関係がわかっている模擬データを使って、直線モデルとRCSを比べます。
Rのrmsで制限付き3次スプラインを当てはめる ― BMIと有害事象のU字型の関係
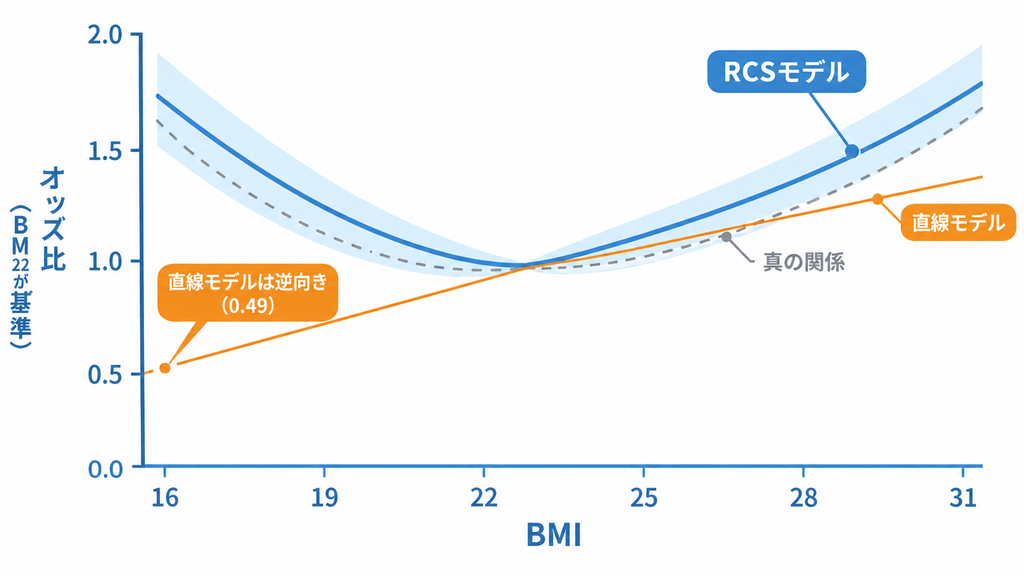
ここからは、真の関係がわかっている説明用の模擬データで、直線モデルとRCSを実際に比べます。1,000人の患者のベースラインBMIを平均23・標準偏差3.5の正規分布から生成し、有害事象(1=あり)を「BMI 22 で最もリスクが低く、低くても高くてもリスクが上がるU字型」の関係(対数オッズ \(=-2+0.04\times(\mathrm{BMI}-22)^2\))から発生させました。実データではなく、BMIと有害事象の実際の関係を主張するものではありません。真の関係が既知なので、どのモデルが正しく描けたかを答え合わせできます。
Rでの実装
模擬データを作る
library(rms)

set.seed(2026)
n   <- 1000
bmi <- round(rnorm(n, mean = 23, sd = 3.5), 1)   # ベースラインのBMI
lp  <- -2 + 0.04 * (bmi - 22)^2                  # 真の関係:BMI 22 で最小になるU字型
ae  <- rbinom(n, 1, plogis(lp))                  # 有害事象の発現(1 = あり)
dat <- data.frame(ae, bmi)

summary(dat$bmi)
mean(dat$ae)
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
  12.30   20.60   23.05   23.05   25.20   35.00
[1] 0.207
BMIは12.3〜35.0に分布し、中央値は23.05です。有害事象の発現割合は全体で20.7%でした。
plogis() は対数オッズを確率に変換する関数です。直線を仮定したモデル
まず、BMIをそのまま入れた直線のロジスティック回帰を当てはめます。datadist() は変数の範囲や基準値を記録する仕組みで、後の Predict() の前に設定します。
dd <- datadist(dat)
options(datadist = "dd")

# 直線(線形)を仮定したロジスティック回帰
fit_lin <- lrm(ae ~ bmi, data = dat)
anova(fit_lin)
round(exp(coef(fit_lin)["bmi"]), 3)   # BMI が 1 増えるごとのオッズ比
                Wald Statistics          Response: ae

 Factor     Chi-Square d.f. P
 bmi        26.13      1    <.0001
 TOTAL      26.13      1    <.0001
  bmi
1.127
直線モデルではBMIは有意(p<0.0001)で、BMIが1増えるごとにオッズは1.127倍です。この結果だけを見ると「BMIが高いほど有害事象が増え、低いほど安全」と読めてしまいます。しかし、p値が小さいことは、モデルの形が正しいことを意味しません(p値とは何か?)。この答え合わせは後で行います。
制限付き3次スプラインのモデル
rcs(bmi, 4) と書くだけで、ノット4個のRCSになります。
# 制限付き3次スプライン(ノット4個)を使ったロジスティック回帰
fit_rcs <- lrm(ae ~ rcs(bmi, 4), data = dat)
anova(fit_rcs)
attr(rcs(dat$bmi, 4), "parms")   # ノットの位置
                Wald Statistics          Response: ae

 Factor     Chi-Square d.f. P
 bmi        90.19      3    <.0001
  Nonlinear 71.10      2    <.0001
 TOTAL      90.19      3    <.0001
[1] 17.495 21.700 24.300 28.805
bmiの行(自由度3)はBMI全体の効果の検定、Nonlinearの行(自由度2)が非線形性の検定です。カイ二乗値71.10・p<0.0001で、「直線で十分」という仮説ははっきり否定されます。- 自由度3はノット4個から得られる \(k-1=3\) 個の係数、非線形部分の2は \(k-2=2\) 個に対応します。
- ノットはBMI 17.495・21.7・24.3・28.805で、BMIの分布の5%・35%・65%・95%点(Harrellの推奨位置)です。
BMI 22 を基準にしたオッズ比を、真の値・直線モデルと比べる
曲線の形は係数ではなく、基準値に対するオッズ比で読みます。基準をBMI 22に変えて、各BMIのオッズ比と95%信頼区間を求めます。
# 基準を BMI 22 にして、各 BMI のオッズ比と95%信頼区間を求める
dd$limits["Adjust to", "bmi"] <- 22
fit_rcs <- update(fit_rcs)
Predict(fit_rcs, bmi = c(16, 19, 22, 25, 28, 31), ref.zero = TRUE, fun = exp)
  bmi      yhat    lower     upper
1  16  4.875213 2.620985  9.068232
2  19  1.654245 1.329374  2.058506
3  22  1.000000 1.000000  1.000000
4  25  1.891936 1.323810  2.703879
5  28  5.691584 3.825270  8.468454
6  31 18.986823 9.887172 36.461331

Response variable (y):

Limits are 0.95 confidence limits
次に、真のオッズ比と直線モデルが示すオッズ比(いずれもBMI 22が基準)を並べます。
# 比較:真のオッズ比と、直線モデルが示すオッズ比(いずれも BMI 22 が基準)
x <- c(16, 19, 22, 25, 28, 31)
round(data.frame(bmi    = x,
                 true   = exp(0.04 * (x - 22)^2),
                 linear = unname(exp(coef(fit_lin)["bmi"] * (x - 22)))), 2)
  bmi  true linear
1  16  4.22   0.49
2  19  1.43   0.70
3  22  1.00   1.00
4  25  1.43   1.43
5  28  4.22   2.04
6  31 25.53   2.92
結果を1つの表にまとめます(BMI 22 は基準なので除いています)。オッズ比の意味は、オッズ比・相対リスク・ハザード比の違いで確認してください。
| BMI | 真のオッズ比 | RCSモデル(95%信頼区間) | 直線モデル |
|---|---|---|---|
| 16 | 4.22 | 4.88(2.62〜9.07) | 0.49 |
| 19 | 1.43 | 1.65(1.33〜2.06) | 0.70 |
| 25 | 1.43 | 1.89(1.32〜2.70) | 1.43 |
| 28 | 4.22 | 5.69(3.83〜8.47) | 2.04 |
| 31 | 25.53 | 18.99(9.89〜36.46) | 2.92 |
- 直線モデルはBMI 16のオッズ比を0.49(リスクが半分)と示しますが、真の値は4.22です。向きが逆で、低BMIのリスクを完全に見落としています。
- RCSモデルは5点すべてで真の値の向きを再現し、真の値はすべてRCSの95%信頼区間に入っています(BMI 16は2.62〜9.07に4.22、BMI 31は9.89〜36.46に25.53)。
- BMI 31の直線モデル2.92は、真の25.53を大きく過小評価しています。直線は「平均的な傾き」で両端を平らにならしてしまいます。
- BMI 25で直線モデルが真値と同じ1.43になっているのは、偶然の一致にすぎません。
- 基本の流れは、Nonlinearの検定で非線形性を確認し、曲線で効果を示すことです。
最後に、オッズ比の曲線を描きます。
ggplot(Predict(fit_rcs, ref.zero = TRUE, fun = exp)) # オッズ比の曲線を図示
BMI 22 を基準としたオッズ比の曲線と95%信頼帯が描かれ、U字型が一目でわかります。
SASでの実装
SASでは PROC LOGISTIC の EFFECT 文でRCSを使えます。まずRで模擬データをCSVに書き出し、SASに読み込みます。
write.csv(dat, "bmi_ae.csv", row.names = FALSE) # SAS で読み込むために書き出す
/* R で書き出した bmi_ae.csv を読み込む */
proc import datafile="bmi_ae.csv" out=dat dbms=csv replace;
  getnames=yes;
run;

/* 比較用:直線を仮定したロジスティック回帰 */
proc logistic data=dat;
  model ae(event='1') = bmi;
run;

/* 制限付き3次スプライン(ノット4個・R と同じ位置を明示) */
proc logistic data=dat;
  effect spl = spline(bmi / details naturalcubic basis=tpf(noint)
                      knotmethod=list(17.495 21.7 24.3 28.805));
  model ae(event='1') = spl;
  effectplot fit(x=bmi) / link;
run;
主要な指定は次のとおりです。
EFFECT文でsplという名前のスプライン効果を作り、MODEL文で説明変数として使います。naturalcubicとbasis=tpf(noint)の組み合わせで、制限付き3次スプライン(自然3次スプライン)になります。tpfは切断べき関数(truncated power function)基底、nointは基底から切片の列を除く指定で、パラメータ推定値の表が読みやすくなります。detailsは、ノットの位置などの詳細を出力します。knotmethod=list(...)はノットの位置を値で直接指定します。knotmethod=percentilelist(5 35 65 95)と書けばパーセンタイルで指定でき、こちらはSAS/STAT 15.1(SAS 9.4M6)以降で使えます。event='1'で「ae=1(有害事象あり)」の確率をモデル化します。指定しないと、既定では小さい方の値がモデル化されます。effectplot fit(x=bmi) / linkで、BMIに対する当てはめ曲線を対数オッズ(リンク関数)の尺度で描きます。
ノットをRと同じ値で明示する理由:パーセンタイルの計算方法はソフトや設定によって異なる場合があります。Rで求めたノット位置を list で渡すと、両者の条件をそろえやすくなります。
非線形性の確認:直線モデルとスプラインモデルの「モデル適合度統計量(Model Fit Statistics)」の -2 Log L の差を、自由度2(非線形部分の係数の数)のカイ二乗分布で評価すれば、尤度比検定になります。Rの anova() はWald検定なので、検定統計量の値は一致しません(方式が違います)。
また、係数の値は基底の定義(rmsは尺度を調整しています)で変わるため、RとSASの係数を直接見比べず、曲線で比べてください。SASで描いた曲線がRのオッズ比曲線と同じU字型になるかを確かめると、実装の検算になります。
ノット数の選び方と応用 ― AICでの比較とCox回帰への拡張
ここまでで、RCSが直線モデルの見落としを正せることはわかりました。次の疑問は「ノットは何個にすればよいのか」「カテゴリ化と比べて本当に良いのか」でしょう。前章で当てはめたモデル(fit_lin と fit_rcs)を使い、まず数字で確かめます。
ノット数とカテゴリ化をAICで比べる
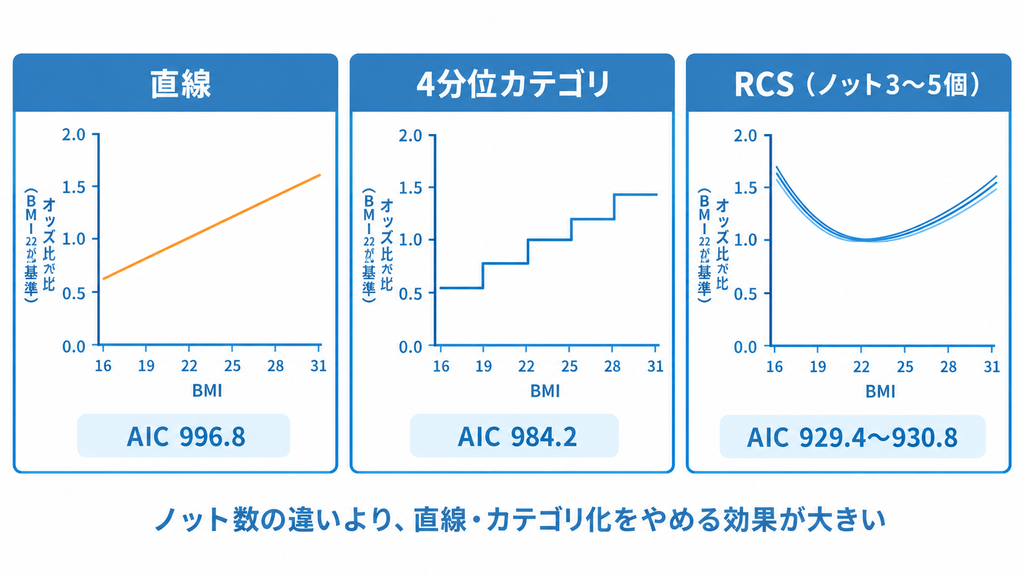
直線、4分位でカテゴリ化したモデル、ノット3・4・5個のRCSを、同じデータでAIC(赤池情報量規準)によって比べます。AICは「当てはまりの良さ」と「パラメータ数の多さ」のバランスを見る指標で、小さいほど良いモデルです。考え方は モデル選択の基礎:AIC・BICを“情報量”として理解する で詳しく解説しています。
# ノット数を変えたモデルと、4分位でカテゴリ化したモデルを AIC で比べる
dat$bmi_q <- cut(dat$bmi, quantile(dat$bmi, 0:4 / 4), include.lowest = TRUE)
fit_cat <- lrm(ae ~ bmi_q, data = dat)
fit_k3  <- lrm(ae ~ rcs(bmi, 3), data = dat)
fit_k5  <- lrm(ae ~ rcs(bmi, 5), data = dat)
round(c(linear   = AIC(fit_lin), quartile = AIC(fit_cat),
        knot3    = AIC(fit_k3),  knot4    = AIC(fit_rcs),
        knot5    = AIC(fit_k5)), 1)
  linear quartile    knot3    knot4    knot5
   996.8    984.2    930.8    929.4    929.9
ノット3個と5個の位置も確認しておきます。
attr(rcs(dat$bmi, 3), "parms")   # ノット3個の位置
attr(rcs(dat$bmi, 5), "parms")   # ノット5個の位置
[1] 18.79 23.05 27.51
[1] 17.4950 20.9000 23.0500 25.0275 28.8050
結果を表に整理します。
| モデル | 推定する係数の数(切片を除く) | AIC |
|---|---|---|
| 直線 | 1 | 996.8 |
| 4分位カテゴリ | 3 | 984.2 |
| RCS(ノット3個) | 2 | 930.8 |
| RCS(ノット4個) | 3 | 929.4 |
| RCS(ノット5個) | 4 | 929.9 |
AICが最小なのはノット4個の929.4で、ノット5個は929.9、ノット3個は930.8です。ノット数による差は1.4以内(930.8−929.4)にすぎません。一方、直線の996.8や4分位カテゴリの984.2とは50以上の差があります(984.2−930.8=53.4)。つまり、ノット数の選び方よりも「直線やカテゴリ化をやめてRCSにする」ことのほうがはるかに効きます。
注目したいのは4分位カテゴリです。推定する係数は3個で、ノット4個のRCSと同じなのに、AICは54.8も悪くなっています(984.2−929.4)。区切りの中の違いを捨て、階段状の関係しか表せないためです。なお、ノット3個の位置は10%・50%・90%点(23.05は中央値)、ノット5個は5%・27.5%・50%・72.5%・95%点に対応しています。
AICを見ながらノット数を何度も選び直すと、そのデータに合わせすぎ(過学習)になり、p値や信頼区間が楽観的になります。ノット数は解析計画書で事前に決めるのが原則です(症例数に応じて3〜5個)。
Cox回帰でも同じ書き方で使える
RCSはロジスティック回帰に限った手法ではありません。生存時間解析のCox回帰でも、lrm() を cph() に替えるだけで、rcs() の書き方は同じです。Rに組み込みの lung(survivalパッケージの進行肺がん患者のデータ)で、年齢の効果を調べます。time は生存時間(日)、status は打ち切り(1)/死亡(2)です。Cox回帰そのものは Cox比例ハザードモデル入門 をご覧ください。
# 生存時間解析(Cox回帰)でも同じ書き方:lung データの年齢
library(survival)
lung2 <- na.omit(lung[, c("time", "status", "age", "sex")])
dd2 <- datadist(lung2)
options(datadist = "dd2")
fit_cox <- cph(Surv(time, status) ~ rcs(age, 3) + sex, data = lung2)
anova(fit_cox)
                Wald Statistics          Response: Surv(time, status)

 Factor     Chi-Square d.f. P
 age         4.07      2    0.1310
  Nonlinear  0.46      1    0.5000
 sex         9.46      1    0.0021
 TOTAL      14.18      3    0.0027
年齢の非線形性の検定は、カイ二乗値0.46・p=0.50です。このデータでは年齢の効果を曲線にする根拠はなく、直線で十分と考えられます。性別はp=0.0021でした。
大切なのは、RCSは「曲線にしなければならない」手法ではなく、「直線でよいかを確かめられる」手法でもあるという点です。非線形でなければ直線モデルで報告して構いません。ただし、どちらで報告するかの手順は事前に決めておきます。また、生存時間解析では、効果の形の問題とは別に比例ハザード性の確認も必要です。Cox比例ハザード性のチェックとRMSTへの切り替え判断 もあわせてご覧ください。
実務でのポイント ― 解析計画から結果の報告まで
最後に、RCSを実際の解析で使うときの注意点をまとめます。
事前規定が原則です。 どの連続変数にRCSを使うか、ノット数(と位置の決め方)、非線形性を検定するかを解析計画書に書いておきます。結果を見てからノット数や区切りを変えてはいけません。書き方は 統計解析計画書(SAP)の書き方 を参考にしてください。
ランダム化試験の共変量調整にも使えます。 ベースライン値などの連続共変量を調整に使うとき、直線の仮定が怪しい場合の選択肢になります。調整に使う共変量と関数形は、やはり事前に決めます。詳しくは 共変量調整(ANCOVA)徹底解説 をご覧ください。
報告は曲線と代表値で行います。 係数の表ではなく、基準値(本記事ではBMI 22)に対するオッズ比(ハザード比)の曲線と信頼帯を図で示し、代表的な値(例:BMI 16・28・31)でのオッズ比と95%信頼区間を表で添えます。基準値は臨床的に意味のある値を選び、明記しましょう。
データの端には注意が必要です。 両端(とくに5%点未満・95%点超)は症例が少なく、信頼区間が広くなります。BMI 31 の信頼区間が9.89〜36.46と広かったのがその例です。端の推定値を強く主張せず、データの範囲外への外挿もしません。
交絡の調整にも効きます。 交絡因子を直線で入れると、調整が不十分になりうるためです。交絡の基本は 【やさしく解説】交絡(交絡因子)とは で確認できます。
効果修飾の評価にも使えます。 「年齢によって治療効果が変わるか」を調べるとき、年齢を「65歳以上/未満」のサブグループに分けると、区切りの恣意性と検出力の低下という、カテゴリ化と同じ問題を抱えます。治療群とRCSの交互作用項をモデルに入れれば、年齢に沿って治療効果がどう変わるかを連続的な曲線で示せます。ただし交互作用の検出力は低く、多重性の問題もあるため、探索的な位置づけを明記して報告します。考え方は サブグループ解析と交互作用検定を正しく行う で整理しています。
予測モデルでも定番です。 臨床予測モデルの構築では、連続の予測因子をカテゴリ化せずRCSで入れるのが一般的です。作ったモデルの評価は 臨床予測モデルの検証とは をご覧ください。
RCSを使うときのチェックリストです。
- 連続変数を安易にカテゴリ化していないか
- ノット数と位置を事前に決めたか(3〜5個・パーセンタイル)
- 非線形性の検定で直線との違いを確認したか
- 結果を基準値つきのオッズ比(ハザード比)曲線と信頼帯で示したか
- データの端の推定を過大に解釈していないか
📚 この記事をより深く理解するための参考書籍
連続変数を「直線で入れて終わり」にしない回帰モデルの組み立て方を、理論と実装の両面から深めるための3冊を紹介します。



関連記事・次のステップ
回帰モデルの土台を固めたい方は、2値変数とロジスティック回帰と一般線形モデルと一般化線形モデルの違いを徹底解説を先に読むと、本記事の「対数オッズの尺度で曲線を当てはめる」意味がすっと入ります。モデルの前提を残差から点検する方法は線形回帰の“本質”をつかむにまとめています。
結果の示し方を深めたい方は、オッズ比とハザード比の読み分けをオッズ比・相対リスク・ハザード比の違いで、モデル同士の比べ方をモデル選択の基礎:AIC・BICを“情報量”として理解するで確認してください。
生存時間解析や予測モデルに応用したい方には、Cox比例ハザードモデル入門と臨床予測モデルの検証とはがおすすめです。連続変数の扱い方は、ランダム化試験の共変量調整(ANCOVA)や、観察研究の傾向スコア分析でも同じように効いてきます。
まとめ
本記事では、連続変数の非線形な効果をモデルに取り込む制限付き3次スプライン(RCS)を、BMIと有害事象のU字型の関係をもつ模擬データで、Rのrmsパッケージを使って確かめながら整理しました。
RCSは、変数の範囲をノットで区切って区間ごとの3次式を滑らかにつなぎ、両端だけは直線にした曲線です。ノットが \(k\) 個なら \(k-1\) 個の係数で済み、ノットはHarrellの推奨どおり分布のパーセンタイルに置けば十分です。カテゴリ化のように情報を捨てることも、多項式のように端で暴れることもありません。
実測では、直線モデルもBMIの効果を「有意」と判定しましたが、BMI 16のオッズ比を0.49と、真の値4.22とは逆向きに示しました。RCSは4.88(95%信頼区間2.62〜9.07)と正しい向きと大きさを取り戻し、非線形性の検定もp<0.0001でした。AICではノット3〜5個の差が1.4以内だったのに対し、直線・4分位カテゴリとは50以上の差がつき、「ノット数をどう選ぶか」より「直線やカテゴリ化をやめること」のほうがはるかに効くことがわかりました。一方、lungデータの年齢のように非線形性が認められない場合は、直線で報告してよいことも確認しました。SASでも EFFECT 文の naturalcubic でRCSを当てはめられます。 RCSは、ロジスティック回帰・Cox回帰・共変量調整・予測モデルのどこでも使える、実務で非常に有用な道具です。ノット数と使い方を解析計画で事前に決め、基準値つきの曲線と代表値の表で結果を示すことで、連続変数の効果を正しく伝える解析を実現していただければと思います。回帰モデルの基礎に戻りたい方は2値変数とロジスティック回帰を、生存時間解析で使いたい方はCox比例ハザードモデル入門をあわせてご覧ください。