ネットワークメタアナリシス(NMA)とは ― 直接比較・間接比較の統合とP-scoreによる順位づけをRのnetmetaで実装する ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- ネットワークメタアナリシス(NMA)とは何か、通常のメタアナリシスと何が違うのか
- 間接比較の仕組み(Bucher法)を、Rで手計算して再現する方法
- Rのnetmetaパッケージでネットワークメタアナリシスを実装する手順
- P-score(SUCRAの頻度論版)とリーグ表の読み方、そして順位づけの落とし穴
- 一貫性の評価と、「不一致」と「異質性」を切り分ける考え方
はじめに
治療の選択肢が3つ以上あるのに、そのすべての組み合わせを直接比べたランダム化比較試験がそろうことは、まずありません。新薬はプラセボや標準治療とは比較されても、「新薬どうしではどちらが良いのか」は、試験から直接はわからないのが普通です。
この問いに答える手法が、ネットワークメタアナリシス(NMA)です。診療ガイドラインの作成や医療技術評価(HTA)で広く使われています。本記事は、製薬企業・CROの生物統計担当者、HTAやメディカルアフェアーズの担当者、メタアナリシスを一度学んだ大学院生に向けて書きました。ランダム化の意義があやふやな方は【やさしく解説】RCT(ランダム化比較試験)とはを、Rを触ったことがない方はR入門を先にご覧ください。
世の中の解説は「netmetaを回して順位が出ました」で終わりがちです。本記事では、間接比較の手計算、順位づけの限界、不一致と異質性の切り分けまで、実測で確かめていきます。
ネットワークメタアナリシスとは ― 直接比較と間接比較をつなぐ考え方
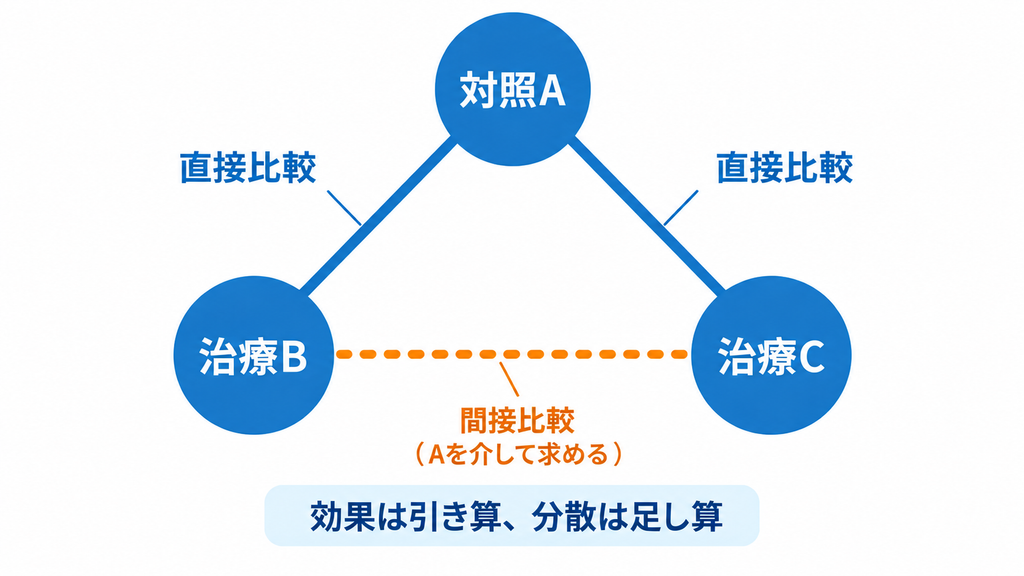
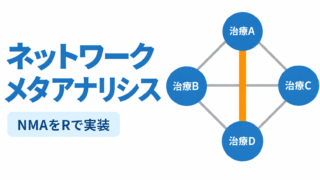
ネットワークメタアナリシス(network meta-analysis, NMA)は、3つ以上の治療を、直接比較と間接比較の両方を使って同時に比べるメタアナリシスです。混合治療比較(mixed treatment comparison, MTC)とも呼ばれます。メタアナリシス入門で扱う通常のメタアナリシスが「2治療の1つの比較」を統合するのに対し、NMAは「3治療以上のネットワーク全体」を統合します。
比較の種類は3つに整理できます。
| 比較の種類 | 何を使うか | 強み | 弱み |
|---|---|---|---|
| 直接比較 | 同じ試験の中で2治療を比べた結果 | 試験内のランダム化に守られ、信頼しやすい | 比べたい組み合わせの試験がないことが多い |
| 間接比較 | 共通の比較相手(対照)を介して導いた結果 | 直接比べた試験がなくても推定できる | 材料より必ず不確かになり、試験集団の違いに弱い |
| 混合比較(NMAの推定値) | 直接と間接を精度に応じた重みで統合 | 全情報を使うので精度が上がり、全治療を順位づけできる | 仮定(推移性・一貫性)が成り立たないと歪む |
間接比較がランダム化の恩恵を保てるのは、各試験の群間差(相対効果)だけを使うからです。試験内のランダム化は壊れません。一方、試験をまたいで禁煙成功割合そのものを比べる「素朴な比較」は、ランダム化を壊すので避けます。
NMAは3つの仮定に依拠します。同じ比較の試験どうしで効果が大きく違わない「均質性」、比較の種類が違う試験どうしで効果修飾因子の分布が似ている「推移性」、直接比較と間接比較が食い違わない「一貫性」です。推移性は統計的に検定できない仮定で、詳しくは後の章で整理します。
間接比較の仕組みをRで手計算する
使うのは、netmeta同梱の smokingcessation です。禁煙支援の4つの介入を比べた24試験(うち2試験は3群試験)、合計16,740人のデータで、Diasら(2013年、Medical Decision Making誌)が不一致の評価の例題に使いました。アウトカムは禁煙に成功した人数で、多いほど良く、オッズ比(OR)が1より大きいほど成功が多いことを表します。R出力では桁をそろえるため、介入を英語名で表示します。
- A →
NoContact:介入なし(対照) - B →
SelfHelp:自助教材(パンフレット等) - C →
Individual:個別カウンセリング - D →
Group:集団カウンセリング
元データは1試験1行の横持ちです。pairwise() で、2群比較ごとの対数オッズ比 TE と標準誤差 seTE に変換します。
library(netmeta)

# 禁煙支援の4つの介入を比べた24試験(netmetaに同梱)
data(smokingcessation)

# A〜Dの記号を介入名に置き換える
lab <- c(A = "NoContact", B = "SelfHelp", C = "Individual", D = "Group")
sc <- smokingcessation
sc$treat1 <- lab[sc$treat1]
sc$treat2 <- lab[sc$treat2]
sc$treat3 <- lab[sc$treat3]

# 1試験1行のデータを「2群比較ごとの対数オッズ比」に変換する
pw <- pairwise(treat = list(treat1, treat2, treat3),
               event = list(event1, event2, event3),
               n = list(n1, n2, n3),
               data = sc, sm = "OR")

nrow(pw)
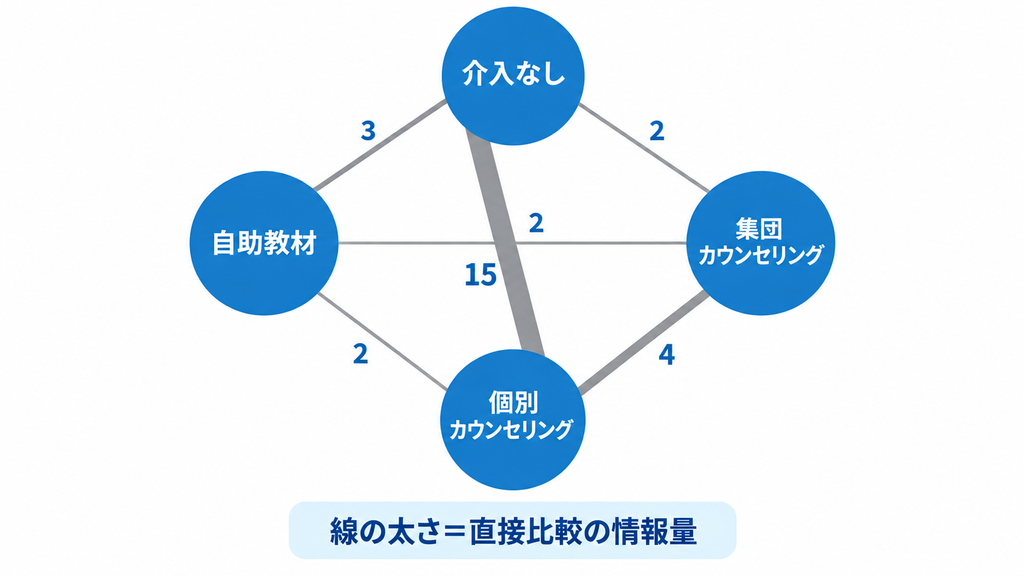
table(paste(pw$treat1, "vs", pw$treat2))
[1] 28

    Individual vs Group      NoContact vs Group NoContact vs Individual
                      4                       2                      15
  NoContact vs SelfHelp       SelfHelp vs Group  SelfHelp vs Individual
                      3                       2                       2
- 24試験が28個の2群比較になりました。2群試験22本は1比較ずつ、3群試験2本は3比較ずつです(22+2×3=28)。
- 比較ごとの本数は大きく偏っています。
NoContact vs Individualが15で、それ以外は2〜4です。エビデンスの厚い辺と薄い辺があるのが、ネットワークの普通の姿です。 - 6通りの組み合わせすべてに直接比較がある「閉じたネットワーク」です。だから直接比較と間接比較の答え合わせができます。
- オッズ比そのものの意味は、オッズ比・相対リスク・ハザード比の違いで確認できます。
次に、個別カウンセリング(Individual)と自助教材(SelfHelp)を、共通の対照(NoContact)を介して間接的に比べます。比べたい2治療をB・C、共通対照をAとし、\(d\) を対数オッズ比とすると、Bucher法の間接比較は次のとおりです。
\[ \hat{d}_{BC}^{\,\mathrm{ind}}=\hat{d}_{AC}-\hat{d}_{AB},\qquad \mathrm{Var}\left(\hat{d}_{BC}^{\,\mathrm{ind}}\right)=\mathrm{Var}\left(\hat{d}_{AB}\right)+\mathrm{Var}\left(\hat{d}_{AC}\right) \]
効果は引き算、分散は足し算です。だから間接比較は、材料になった2つの比較のどちらよりも必ず不確かになります。pairwise() の TE は「treat1 対 treat2」の対数オッズ比なので、sh は「対照 対 自助教材」、ic は「対照 対 個別」です。sh - ic で対照が打ち消され、「個別 対 自助教材」が残ります。数式の \(d_{AB}\) は「B 対 A(治療 対 対照)」の向きで書いていますが、コードの sh・ic は「対照 対 治療」と符号が逆なので、引く順序も逆になります。計算しているものは同じです。metagen() は通常の(2治療の)変量効果メタアナリシスです。
# 対照(NoContact)を共通の比較相手にして、SelfHelp と Individual を間接比較する
pick <- function(t1, t2) {
  m <- metagen(TE, seTE, data = pw, sm = "OR",
               subset = treat1 == t1 & treat2 == t2)
  c(logOR = m$TE.random, se = m$seTE.random)
}

sh <- pick("NoContact", "SelfHelp")     # 対照 vs 自助教材(3比較)
ic <- pick("NoContact", "Individual")   # 対照 vs 個別カウンセリング(15比較)

# 間接比較(Individual 対 SelfHelp):対数オッズ比は引き算、分散は足し算
ind_logOR <- sh["logOR"] - ic["logOR"]
ind_se    <- sqrt(sh["se"]^2 + ic["se"]^2)

# 直接比較(SelfHelp と Individual を直接比べた2比較)。向きをそろえるため符号を反転
dr <- pick("SelfHelp", "Individual")
dir_logOR <- -dr["logOR"]
dir_se    <- dr["se"]

ci <- function(est, se) exp(c(est, est - 1.96 * se, est + 1.96 * se))
res <- rbind(indirect = ci(ind_logOR, ind_se),
             direct   = ci(dir_logOR, dir_se))
colnames(res) <- c("OR", "lower", "upper")
round(res, 2)
           OR lower upper
indirect 1.69  0.92  3.12
direct   0.92  0.50  1.70
- 間接比較では、個別カウンセリングは自助教材に対して OR 1.69(95%信頼区間 0.92〜3.12)、直接比較では OR 0.92(0.50〜1.70)でした。点推定値は1をはさんで逆向きですが、どちらの信頼区間も1を含み、区間どうしも大きく重なります。
- 「直接と間接で結論が矛盾した」とまでは言えません。ただし、どちらか一方だけを見ていたら印象が変わっていたはずです。NMAは、この2つの情報を精度に応じた重みで1つにまとめる手法です。
- この手計算は仕組みを見るための簡略版です。3群試験から来た比較を独立な試験のように扱い、比較ごとに別々の異質性を推定しています。NMAではこれらを正しく処理します。このあとの章で確かめましょう。
Rのnetmetaでネットワークメタアナリシスを実行する
ここからは、前章で作った pw(2群比較ごとの対数オッズ比に変換したデータ)を使って、ネットワークメタアナリシス(NMA)を本番の形で実行します。使うのはRの netmeta パッケージです。netmetaは頻度論のグラフ理論的アプローチ(電気回路網の理論を応用した重み付き最小二乗法)でNMAを行います。ベイズ流で解析したいときは gemtc や multinma といったパッケージもありますが、本記事ではnetmetaに絞ります。
# 変量効果モデルでネットワークメタアナリシスを実行(対照は NoContact)
net <- netmeta(pw, common = FALSE, reference.group = "NoContact")
net
common = FALSE は変量効果モデルの結果だけを表示する指定、reference.group は比較の基準にする治療です。
Number of studies: k = 24
Number of pairwise comparisons: m = 28
Number of observations: o = 16740
Number of treatments: n = 4
Number of designs: d = 8

Random effects model

Treatment estimate (other treatments vs 'NoContact'):
               OR           95% CI    z p-value
Group      2.4653 [1.1003; 5.5234] 2.19  0.0284
Individual 2.0822 [1.3557; 3.1979] 3.35  0.0008
NoContact       .                .    .       .
SelfHelp   1.5162 [0.7370; 3.1196] 1.13  0.2582

Quantifying heterogeneity / inconsistency:
tau^2 = 0.5989; tau = 0.7739; I^2 = 88.6% [84.4%; 91.7%]

Tests of heterogeneity (within designs) and inconsistency (between designs):
                     Q d.f.  p-value
Total           202.62   23 < 0.0001
Within designs  187.40   16 < 0.0001
Between designs  15.22    7   0.0333

Details of network meta-analysis methods:
- Frequentist graph-theoretical approach
- DerSimonian-Laird estimator for tau^2
- Calculation of I^2 based on Q
続けて、ネットワーク図とフォレストプロットを描きます。
netgraph(net, number.of.studies = TRUE)   # ネットワーク図(辺に試験数を表示)
forest(net)                               # 対照に対するフォレストプロット
ネットワーク図が描かれ、続いて対照に対する各治療のフォレストプロットが描かれます。ネットワーク図の点(ノード)は治療、線(エッジ)は直接比較した試験があることを表し、線の太さは情報量に対応します。今回は NoContact と Individual を結ぶ線が最も太くなります。
対照に対する効果:オッズ比は、集団カウンセリングが 2.47(95%信頼区間 1.10〜5.52)、個別カウンセリングが 2.08(1.36〜3.20)、自助教材が 1.52(0.74〜3.12)です。カウンセリング2種は信頼区間が1を上回りますが、自助教材は1をまたぎます。信頼区間の読み方は信頼区間とp値の関係を図解で理解するで詳しく解説しています。
点推定値と精度は別物:点推定値は集団が最大ですが、信頼区間は個別のほうがずっと狭くなっています。個別は対照との直接比較が15比較あるのに対し、集団は2比較しかないためです。
異質性は非常に大きい:\(\tau^2\) は 0.5989、\(I^2\) は 88.6% です。試験間で効果が大きくばらついており、「1つの真の効果」を推定しているとは言いにくい状況です。なお netmeta は、全比較に共通の異質性分散 \(\tau^2\) を1つだけ仮定します。
Q統計量の分解:全体の 202.62(自由度23)は、デザイン内の 187.40(自由度16)とデザイン間の 15.22(自由度7)に分かれます。デザイン(design)とは、その試験が比べた治療の組み合わせのことで、2群の組み合わせ6種類と3群の組み合わせ2種類で d = 8 です。デザイン内のQは、同じ比較をした試験どうしのばらつき、つまり異質性を表します。デザイン間のQは、比較の組み合わせが違う試験群どうしの食い違い、つまり不一致を表します。デザイン間のp値が 0.0333 と0.05を下回っている点は、このあとの章であらためて検討します。
P-scoreとリーグ表で治療を順位づける
NMAでは、治療を順位づけたくなります。netmetaが出す指標がP-scoreで、0〜1の値をとり、ある治療が他の治療より優れている確からしさの平均を表します。ベイズ流NMAで使われるSUCRA(累積順位曲線下面積)の頻度論版にあたり、数値の意味もほぼ同じです。SUCRAの背景にあるベイズの考え方は、ベイズ統計の解析手法と製薬業界での活用をご覧ください。
# P-score:値が大きいほど「良い介入」である確からしさが高い
# 禁煙成功は多いほど良いので small.values = "undesirable"
netrank(net, small.values = "undesirable")

# リーグ表:全6通りの比較を1枚にまとめる
netleague(net, digits = 2, common = FALSE)
small.values = "undesirable" は「値が小さいのは望ましくない」という意味です。死亡や有害事象のように少ないほど良いアウトカムでは "desirable" にします。ここを逆にすると順位が丸ごと反転します。
           P-score
Group       0.8376
Individual  0.7103
SelfHelp    0.4042
NoContact   0.0479
League table (random effects model):

             Group 0.92 [0.38;  2.24] 2.44 [0.51; 11.71] 1.86 [0.55;  6.28]
 1.18 [0.55; 2.55]         Individual 2.10 [1.34;  3.31] 0.93 [0.27;  3.18]
 2.47 [1.10; 5.52]  2.08 [1.36; 3.20]          NoContact 0.72 [0.28;  1.86]
 1.63 [0.67; 3.93]  1.37 [0.65; 2.89]  0.66 [0.32; 1.36]           SelfHelp

Lower triangle: results from network meta-analysis (column vs row)
Upper triangle: results from direct comparisons (row vs column)
リーグ表の読み方
対角線に治療名が並びます。左下の三角がNMAの結果(列の治療 対 行の治療)、右上の三角が直接比較だけの結果(行の治療 対 列の治療)です。たとえば2行目・1列目の 1.18 [0.55; 2.55] は「Group 対 Individual」のNMA推定値で、1行目・2列目の 0.92 [0.38; 2.24] は同じ比較を直接比較だけで求めた値です。
順位:P-scoreは、集団 0.84、個別 0.71、自助教材 0.40、対照 0.05 の順です。
1位と2位は区別できていません:集団 対 個別のNMA推定値は OR 1.18(0.55〜2.55)で、信頼区間は1を大きくまたぎます。直接比較だけなら 0.92(0.38〜2.24)と、点推定値はむしろ個別が上です。P-scoreは「差の大きさ」も「不確かさ」も1つの数字に潰してしまいます。順位表だけを抜き出して「集団カウンセリングが最も有効」と結論するのは誤りで、順位は必ずリーグ表(効果の大きさと信頼区間)とセットで読んでください。
NMAは直接と間接を統合している:個別 対 自助教材のNMA推定値は 1.37(0.65〜2.89)です。「間接比較の仕組みをRで手計算する」で求めた直接比較の 0.92 と間接比較の 1.69 のあいだに落ちており、NMAが両者を統合していることが数字で確認できます。
P-scoreやSUCRAは確率そのものではなく、順位の要約です。0.84は「84%の確率で最良」という意味ではありません。
一貫性の評価 ― 直接比較と間接比較は食い違っていないか
NMAの結果が信頼できるかどうかは、3つの仮定が成り立っているかにかかっています。netmetaの実行で作った net を使い、それぞれ何を見れば確かめられるのかを整理してから、一貫性を実際に評価します。
| 仮定 | 意味 | どう確かめるか |
|---|---|---|
| 均質性 | 同じ比較をした試験どうしで、効果が大きく違わない | \(\tau^2\)、\(I^2\)、デザイン内のQを見る |
| 推移性 | 比較の種類が違う試験どうしで、効果修飾因子の分布が似ている | 効果修飾因子の分布を比較ごとに表で並べて吟味する(統計的には検定できない) |
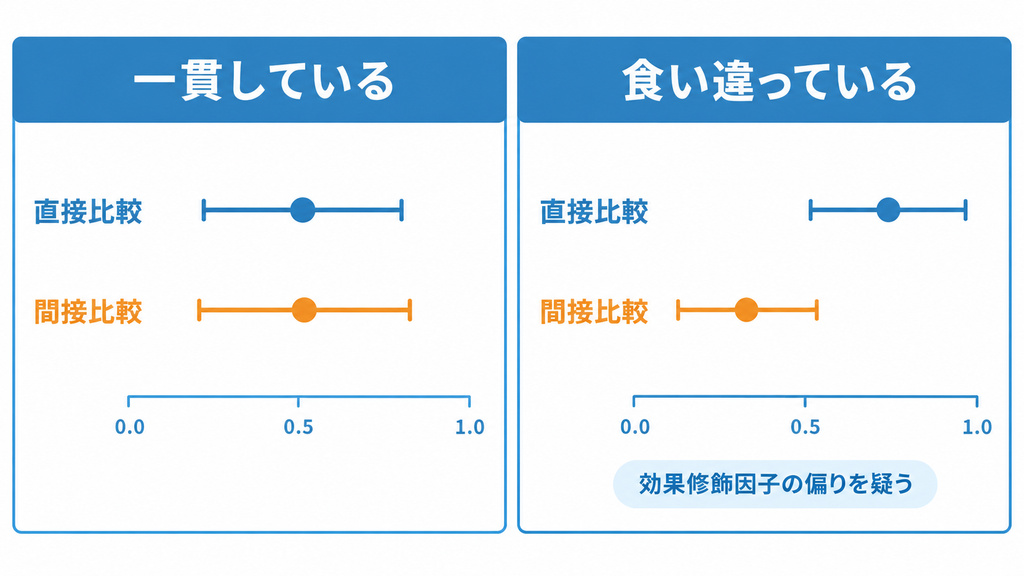
| 一貫性 | 直接比較と間接比較の結果が食い違わない | ノード分割、デザイン間のQで検定する |
推移性が崩れる典型例は、比較の種類と患者背景が連動している場合です。たとえば、対照との比較試験は古い年代で軽症例が多く、新しい治療どうしの比較試験は重症例が多いとします。すると、間接比較には治療の効果ではなく重症度の違いが混ざり込み、結果が歪みます。効果修飾の考え方はサブグループ解析と交互作用検定を正しく行うの記事で、「比べたい要因以外が群間でそろっていない」という構造は【やさしく解説】交絡(交絡因子)とはの記事で詳しく説明しています。推移性はデータから検定できないので、一貫性の評価は「推移性が崩れていないか」の手がかりとして使います。
ノード分割で直接と間接を分ける
netmetaの netsplit() は、SIDE(back-calculation法)と呼ばれる方法で、各比較のNMA推定値を、直接比較だけの部分と間接比較だけの部分に分けて見比べます。
# 直接比較と間接比較を分けて、食い違いを調べる(ノード分割)
netsplit(net)
Separate indirect from direct evidence (SIDE) using back-calculation method

Random effects model:

           comparison  k prop    nma direct indir.    RoR     z p-value
     Group:Individual  4 0.74 1.1840 0.9232 2.4489 0.3770 -1.09  0.2764
      Group:NoContact  2 0.26 2.4653 2.4421 2.4737 0.9872 -0.01  0.9890
       Group:SelfHelp  2 0.53 1.6259 1.8591 1.4016 1.3264  0.31  0.7542
 Individual:NoContact 15 0.90 2.0822 2.1032 1.9040 1.1047  0.14  0.8910
  Individual:SelfHelp  2 0.36 1.3732 0.9267 1.7178 0.5395 -0.78  0.4337
   SelfHelp:NoContact  3 0.58 1.5162 1.3843 1.7182 0.8057 -0.29  0.7719

Legend:
 comparison - Treatment comparison
 k          - Number of studies providing direct evidence
 prop       - Direct evidence proportion
 nma        - Estimated treatment effect (OR) in network meta-analysis
 direct     - Estimated treatment effect (OR) derived from direct evidence
 indir.     - Estimated treatment effect (OR) derived from indirect evidence
 RoR        - Ratio of Ratios (direct versus indirect)
 z          - z-value of test for disagreement (direct versus indirect)
 p-value    - p-value of test for disagreement (direct versus indirect)
各比較について、直接比較だけのOR(
direct)、間接比較だけのOR(indir.)、その比(RoR、1なら完全に一致)、食い違いの検定のp値が並びます。prop はNMA推定値のうち直接比較が担っている割合です。- 6つの比較すべてで p > 0.27で、有意な食い違いは見つかりません。
- ただし最も離れているのは集団 対 個別で、直接 0.92、間接 2.45、RoR 0.38(p=0.2764)です。点推定値は2倍以上違うのに有意になりません。この検定は検出力が低く、「有意でない=一貫している」とは言えません。
- 集団 対 対照のNMA推定値(2.47)は、直接比較の寄与が 0.26 しかなく、74%が間接比較に支えられています。逆に個別 対 対照は 0.90 が直接比較です。
- 個別 対 自助教材は直接 0.93、間接 1.72 で、冒頭の手計算(直接0.92、間接1.69)とほぼ同じ値です。3群試験と共通の異質性を正しく扱っても、手計算の結果が再現されました。
不一致の検定を、異質性を許して検定し直す
netmeta() の出力のQの分解で、デザイン間のQは15.22(p=0.0333)でした。これは試験間の異質性がない(共通効果)ことを前提にした分解です。デザイン内の異質性を許す「デザイン×治療の交互作用(design-by-treatment interaction)変量効果モデル」のもとで、同じ不一致を検定し直します。
# デザイン間の不一致を、デザイン×治療の交互作用モデルで検定する
dd <- decomp.design(net)
dd$Q.inc.random
                       Q df      pval tau.within
Between designs 4.663506  7 0.7009494  0.8131065
異質性を許すと、不一致のQは 15.22 → 4.66(自由度7)に下がり、p値は 0.0333 → 0.70 になります。つまり先ほどの p=0.033 は、不一致というより、巨大な異質性(\(I^2\)=88.6%)が不一致の検定に漏れ出していたと読めます。このデータの本当の問題は不一致ではなく異質性です。カウンセリングの中身・対象者・追跡期間が試験ごとに違う、といった臨床的な多様性を疑うべき状況です。
不一致の検定が有意でも、すぐに「NMAは使えない」と結論しないでください。まず異質性を確認し、異質性を許したモデルで再検定します。逆に有意でなくても、点推定値の乖離(RoR)は必ず見ます。
実務でのポイント ― 結果の読み方と報告で押さえること
計画段階で決めておく
対象とする治療・アウトカム・効果修飾因子の候補・一貫性の評価方法・不一致が見つかったときの対応は、結果を見る前にプロトコルや解析計画書で決めておきます。結果を見てから決めると、都合のよい解析を選んだという疑いが残ります。書き方は統計解析計画書(SAP)の書き方を参考にしてください。
ネットワークの形を先に見る
今回のデータは6通りの比較すべてに直接比較がある、恵まれたネットワークでした。実際の医薬品のNMAでは、各治療がプラセボとしか比較されていない「星型」のネットワークも珍しくありません。星型には直接比較と間接比較の両方がそろった閉じた輪(ループ)がないため、治療どうしの比較はすべて間接比較だけに頼ることになり、一貫性をデータから確かめる手段がなくなります。ノード分割やデザイン間のQが「問題なし」と出たのか、そもそも「評価できない」のかは、ネットワーク図を見ないと区別できません。試験数が少ない辺ばかりの疎なネットワークでは、異質性分散 \(\tau^2\) の推定も不安定になります。結果の表を読む前に、まずネットワーク図で辺の本数と太さ、ループの有無を確認してください。
報告の指針
NMAの報告指針として、PRISMA声明のNMA向け拡張版であるPRISMA-NMA(2015年公表)があります。ネットワーク図、ネットワークの形状の記述、不一致の評価の報告が求められます。エビデンスの確実性の評価には、GRADEの考え方をNMAに拡張した枠組みや CINeMA が使われます。
HTAとの関係
日本では2019年度から費用対効果評価制度が本格運用されており、比較対照技術と直接比べた試験がない場合に間接比較が検討されます。個別患者データが自社試験にしかない場合の手法として、MAIC(matching-adjusted indirect comparison:マッチング調整間接比較)があります。詳しくは外部対照群の統計手法 (2/2) ― 傾向スコアマッチング・MAIC・ベイズ動的借用の記事をご覧ください。
NMAの結果を読むときのチェックリストです。
- ネットワーク図で辺の太さ(直接比較の厚み)を見たか
- 異質性(\(\tau^2\)・\(I^2\))はどの程度か
- 順位はリーグ表の信頼区間とセットで読んだか
- 直接と間接の乖離(RoR)と検定の両方を見たか
- 効果修飾因子の分布を比較ごとに確認したか
📚 この記事をより深く理解するための参考書籍
ネットワークメタアナリシスを「読める」段階から「自分で実行し、理論的に説明できる」段階へ進むための3冊を紹介します。



関連記事・次のステップ
メタアナリシスの基礎を固めたい方は、固定効果・変量効果モデルと異質性の考え方をメタアナリシス入門で確認しておくと、本記事の \(\tau^2\) や \(I^2\) がすっと入ります。効果指標そのものはオッズ比・相対リスク・ハザード比の違いと効果量(Effect Size)を理解すると統計が一気に実務的になる、区間の読み方は信頼区間とp値の関係を図解で理解するにまとめています。
推移性や効果修飾をもう一歩掘り下げたい方には、サブグループ解析と交互作用検定を正しく行うと【やさしく解説】交絡(交絡因子)とはが直接の続きになります。直接比較試験がない場面でのもう1つの道具であるMAICは外部対照群の統計手法 (2/2)で、その土台になる考え方は傾向スコア分析(Propensity Score Analysis)とはで扱っています。
ベイズ流のNMAに進みたい方は、ベイズ統計入門からベイズ統計の解析手法と製薬業界での活用、試験間で情報を借りる階層モデルの発想はベイズ階層モデルの順に読むのがおすすめです。
試験の計画や実務の流れを知りたい方は、【やさしく解説】RCT(ランダム化比較試験)とは、非劣性試験(Non-inferiority Trial)設計と解析、統計解析計画書(SAP)の書き方をどうぞ。HTAやメディカルアフェアーズを含め、統計を仕事にする場の広がりは生物統計家の就職先はどこ?で整理しています。
まとめ
本記事では、ネットワークメタアナリシス(NMA)の考え方を、禁煙支援の4つの介入を比べた24試験のデータを使い、Rのnetmetaで確かめながら整理しました。
出発点は間接比較の仕組みです。共通の対照を介して個別カウンセリングと自助教材を比べると、間接比較ではオッズ比 1.69(95%信頼区間 0.92〜3.12)、直接比較では 0.92(0.50〜1.70)と、点推定値が1をはさんで逆を向きました。NMAはこの2つを精度に応じて統合し、1.37(0.65〜2.89)という1つの答えを返します。効果は引き算、分散は足し算というBucher法の式を手で動かしておくと、netmetaの出力が何をまとめた数字なのかが見えてきます。
順位づけの落とし穴も実測で確認しました。P-scoreは集団カウンセリング 0.84、個別カウンセリング 0.71 の順でしたが、両者を比べたオッズ比は 1.18(0.55〜2.55)で、1位と2位は区別できていません。対照との直接比較が15比較ある個別に対し、集団は2比較しかなく、集団 対 対照の推定値は74%が間接比較に支えられていました。順位表は必ずリーグ表の信頼区間とネットワーク図の辺の太さとセットで読む必要があります。
一貫性の評価では、デザイン間の不一致を示すQ統計量が 15.22(p=0.033)と有意に見えたものの、試験間の異質性を許したモデルでは 4.66(p=0.70)まで下がりました。このデータの本当の課題は、\(I^2\)=88.6% という大きな異質性のほうにあります。不一致の検定が有意でも有意でなくても、異質性の大きさと直接・間接の点推定値の乖離をあわせて見る、という読み方が大切です。
NMAは、直接比べた試験がない治療どうしの優劣という、診療ガイドラインや医療技術評価が最も知りたい問いに答えられる強力な道具です。その一方で、推移性という検定できない仮定の上に立っています。ネットワーク図・異質性・リーグ表・直接と間接の乖離・効果修飾因子の分布という5つの確認を習慣にして、順位表の数字に引っ張られない解釈を実現していただければと思います。通常のメタアナリシスから復習したい方はメタアナリシス入門を、効果修飾の見方を深めたい方はサブグループ解析と交互作用検定を正しく行うをあわせてご覧ください。