Simonの二段階デザインとは ― 第II相単群試験の症例数設計と早期無効中止をRのclinfunで実装する ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- Simonの二段階デザインとは何か、単段階デザインと何が違うのか
- 最適デザインとミニマックスデザインの違いと、場面に応じた選び方
- Rのclinfunで設計値を求め、二項分布の計算から手計算で再現する方法
- 試験終了後に二段階であることを考慮して、奏効率・p値・信頼区間を求める方法
- プロトコル作成から結果の報告までの実務ポイント
はじめに
第II相試験は、「この薬を第III相(大規模な検証試験)に進めるか」を決める関門です。とくにがん領域では、対照群を置かない単群試験で、腫瘍が縮小した患者の割合(奏効率)を調べることがよくあります。ただし、効かない薬に多くの患者さんを割り当てるのは、倫理的にも資源の面でも避けたいところです。
そこで、「途中で見込みがなければ早めにやめる」仕組みを症例数設計に組み込んだのが、Simonの二段階デザインです。第II相単群試験の標準的な設計として、長く使われています。
この記事は、製薬企業・CROの生物統計担当者、臨床開発・メディカルの担当者、臨床試験デザインを学ぶ大学院生を想定しています。試験の位置づけは臨床試験のフェーズ(第I相〜第IV相)とは、第I相で用量を決める流れは第I相がん臨床試験の用量探索デザインで確認できます。第I相で用量を決め、第II相で有効性の手応えを見る、という順序です。Rを触ったことがない方は、先にR入門に目を通しておくと、コードが読みやすくなります。
Simonの二段階デザインとは ― 第II相単群試験で「早めにやめる」仕組み
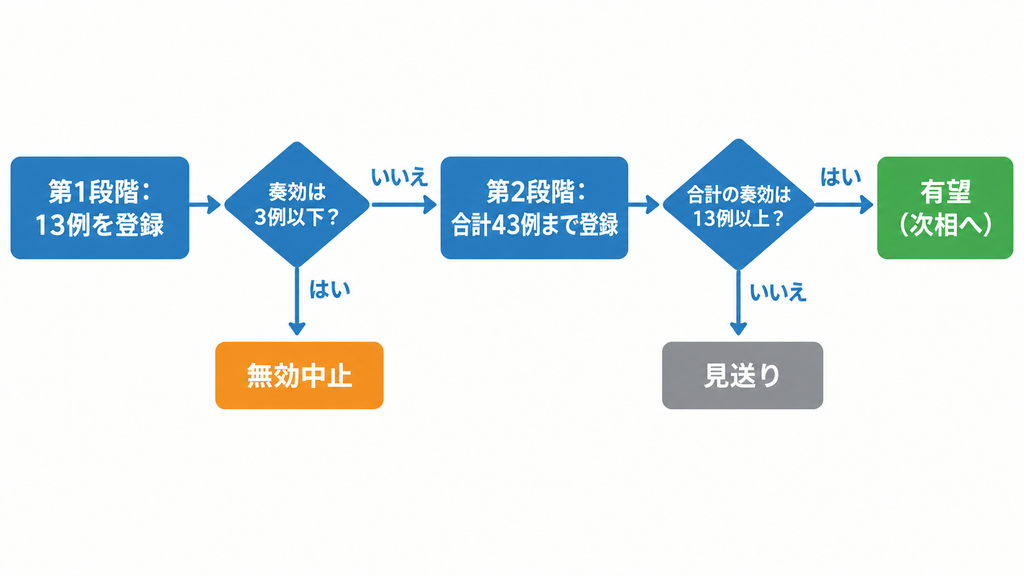
仮説の立て方
固形がんでは、RECISTなどの基準で判定した奏効(あり/なしの二値)を主要評価項目にします。そして2つの奏効率を決めます。
- 閾値奏効率 \(p_0\):既存治療で得られる程度の奏効率。これ以下なら開発を続ける価値がありません。考え方としては、既存治療の奏効率にあたります
- 期待奏効率 \(p_1\):これくらいあれば次の相へ進めたい奏効率。臨床的に意味のある上乗せ分を足した値です
そして \(H_0: p\le p_0\) 対 \(H_1: p\ge p_1\) を検定します。
二段階デザインの流れ
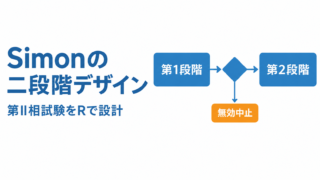
Richard Simon が1989年に Controlled Clinical Trials 誌で提案したデザインです。
- 第1段階で \(n_1\) 例を登録する
- 奏効が \(r_1\) 例以下なら、無効中止
- \(r_1\) 例を超えたら第2段階へ進み、合計 \(n\) 例まで登録する
- 合計の奏効が \(r\) 例を超えたら「有望(次相へ進む価値あり)」と判定する
設計は r1/n1, r/n の4つの数字で表します。大切なのは、止まるのは「無効」のときだけという点です。第1段階の成績がとても良くても、有効中止はしません。
設計の基準と、PET・EN
条件(α・β)を満たす設計は複数あるため、何を最小にするかで選びます。その前に2つの指標を押さえます。PET(probability of early termination)は第1段階で中止する確率、EN(expected sample size)は期待症例数で、\(n_1+(1-\mathrm{PET})\times(n-n_1)\) と表せます。
| デザイン | 何を最小にするか | 向いている場面 |
|---|---|---|
| 最適(Optimal) | 薬が効かないときの期待症例数 EN(p0) | 効かない可能性が高い候補を多数ふるい分けたいとき |
| ミニマックス(Minimax) | 最大症例数 \(n\) | 登録が遅い、予算・期間に上限があるとき |
| Admissible | 最大症例数と EN(p0) の重み付き和 \(q\cdot n+(1-q)\cdot EN(p_0)\) | 両者の中間の妥協案がほしいとき |
最適デザインは、効かない薬に割り当てる人数を平均的に最も少なくする設計です。ミニマックスデザインは、最悪でも何例で済むかを最小にする設計です。Admissible デザインは Jung らが2004年に Statistics in Medicine 誌で提案したもので、最大症例数と期待症例数の重み付き和 \(q\cdot n+(1-q)\cdot EN(p_0)\) を最小にする設計の総称です。\(q=0\) なら最適デザイン、\(q=1\) ならミニマックスデザインに一致し、その間の \(q\) で最良になる設計が、clinfunの出力で「Admissible」と表示される中間の妥協案です。
まず単段階デザインで症例数を求める
二段階の良さを測るには、比べる相手が必要です。本記事の設定は、\(p_0=0.2\)(20%)、\(p_1=0.4\)(40%)、α=0.05(片側)、β=0.2(検出力80%)とし、全章で共通です。まず、途中でやめない単段階デザインの症例数をclinfunの ph2single() で求めます。
library(clinfun)

# 単段階デザイン:閾値奏効率 p0 = 20%、期待奏効率 p1 = 40%、α = 0.05、β = 0.2
ph2single(pu = 0.2, pa = 0.4, ep1 = 0.05, ep2 = 0.2)
   n  r Type I error Type II error
1 35 11   0.03435740     0.1951745
2 36 11   0.04242772     0.1620064
3 38 12   0.02879211     0.1863650
4 39 12   0.03549549     0.1553711
5 40 12   0.04324162     0.1285097
- 条件(第1種の過誤≦0.05、第2種の過誤≦0.2)を満たす最小の症例数は n = 35 です。
r = 11は「奏効が11例以下なら見送り」の意味で、12例以上の奏効で有望と判定します - このとき第1種の過誤は 0.0344、第2種の過誤は 0.195 です。検出力は約80.5%(1−0.195)になります
- 二項分布は離散なので、αはぴったり0.05にはならず、0.05を下回る値になります。二項分布の正確な扱いは二項比率の信頼区間で解説しています
- 単段階デザインでは、薬が効かなくても必ず35例全員を登録することになります。これが二段階デザインを使う動機です
この設計値が何を数えているのか、手計算で確かめてみます。\(X\) を35例中の奏効数とすると、次のように書けます。
\[ \alpha=P(X\ge 12\mid p=0.2),\qquad \beta=P(X\le 11\mid p=0.4),\qquad X\sim \mathrm{Bin}(35,\,p) \]
第1種の過誤は「本当は奏効率20%なのに12例以上奏効してしまう確率」、第2種の過誤は「本当は40%なのに11例以下にとどまる確率」です。
# n = 35 で「12 例以上の奏効なら有望」と判定するときの誤り確率
1 - pbinom(11, size = 35, prob = 0.2)  # 第1種の過誤:本当は20%なのに有望と判定
pbinom(11, size = 35, prob = 0.4)      # 第2種の過誤:本当は40%なのに見送る
[1] 0.0343574
[1] 0.1951745
ph2single()の1行目(0.03435740/0.1951745)と一致します。設計値は二項分布の累積確率を数えているだけですpbinom(11, …)は「11例以下」の確率です。だから「12例以上」は1 - pbinom(11, …)と書きます。境界が1例ずれるミスは、実務で最も起きやすいものです- α・βの意味は仮説検定の“二種類の誤り”を深く理解するで整理しています
では、途中で止める仕組みを入れると、何例で済むのでしょうか。次章で、二段階デザインを実際に求めてみます。
Rのclinfunで最適デザインとミニマックスデザインを求める
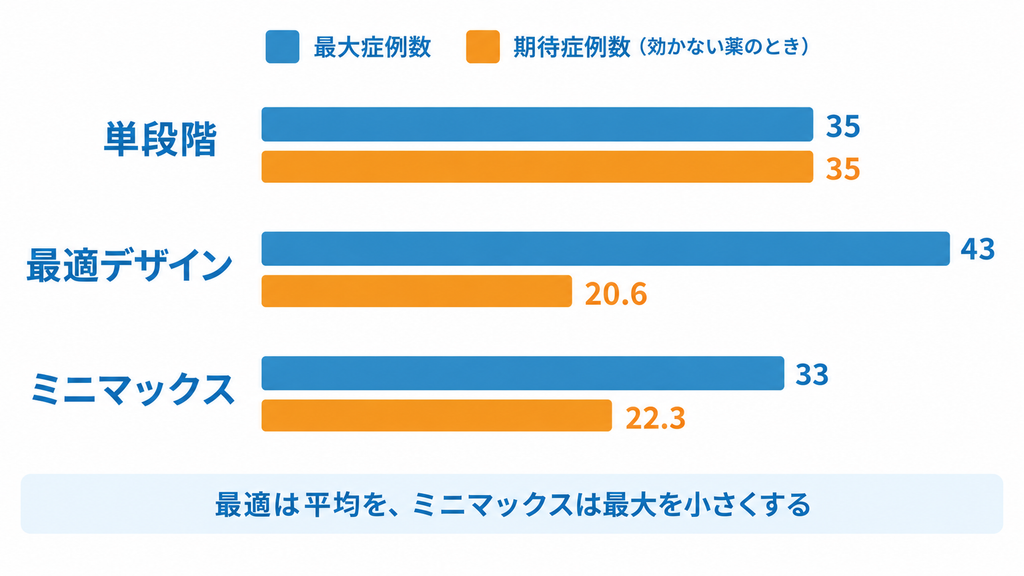
前章で読み込んだ clinfun を使って、いよいよ二段階デザインを求めます。ph2simon() の引数は次の4つです。
pu:閾値奏効率 \(p_0\)(本記事では0.2)pa:期待奏効率 \(p_1\)(0.4)ep1:第1種の過誤 α(0.05)ep2:第2種の過誤 β(0.2)
# Simonの二段階デザイン(最適デザインとミニマックスデザイン)
des <- ph2simon(pu = 0.2, pa = 0.4, ep1 = 0.05, ep2 = 0.2)
des
 Simon 2-stage Phase II design

Unacceptable response rate:  0.2
Desirable response rate:  0.4
Error rates: alpha =  0.05 ; beta =  0.2

           r1 n1  r  n EN(p0) PET(p0)   qLo   qHi
Minimax     4 18 10 33  22.25  0.7164 0.168 1.000
Admissible  3 14 11 38  21.24  0.6982 0.117 0.168
Optimal     3 13 12 43  20.58  0.7473 0.000 0.117
出力の読み方を、最適デザインとミニマックスデザインについて表に整理します。
| デザイン | 第1段階 | 中止の条件 | 最大症例数 | 有望と判定する条件 | EN(p0) | PET(p0) |
|---|---|---|---|---|---|---|
| 最適 | 13例 | 奏効3例以下で中止 | 43例 | 43例中13例以上 | 20.58 | 0.7473 |
| ミニマックス | 18例 | 奏効4例以下で中止 | 33例 | 33例中11例以上 | 22.25 | 0.7164 |
最適デザインは、効かない薬(真の奏効率20%)なら約75%の確率で13例の時点で止まり、期待症例数は平均20.58例で済みます。そのかわり、最後まで進むと43例が必要です。
注目してほしいのは、ミニマックスデザインの最大症例数が33例で、前章の単段階デザインの35例より少ないことです。第1段階の無効中止によって、効かない薬が「たまたま有望と判定される」経路の一部が切り落とされ、第1種の過誤に余裕が生まれるためです。二段階にすると、平均だけでなく最大の症例数まで小さくできる場合があります。
Admissible デザイン(14例で3例以下なら中止、最大38例)は両者の中間の妥協案です。
qLo と qHi は、その設計が最良になる重み \(q\) の範囲を表します。図は次のコードで描けます。最大症例数と期待症例数の関係の中で、最適・ミニマックス・Admissible の各デザインの位置が描かれます。
plot(des) # 候補デザインの最大症例数と期待症例数の関係を図示
設計値を二項分布から手計算で確かめる
出力された数字を鵜呑みにせず、二項分布から再現してみましょう。第1段階の奏効数を \(X_1\)、第2段階の奏効数を \(X_2\) とすると、中止する確率(PET)と「有望」と判定する確率は次のとおりです。
\[ \mathrm{PET}=P(X_1\le r_1),\qquad P(\text{有望})=\sum_{x_1=r_1+1}^{n_1}P(X_1=x_1)\,P(X_2>r-x_1) \]
第2段階に進んだ各ケース(第1段階の奏効数 \(x_1\) ごと)について、第2段階で「残り」の奏効数を上回る確率を掛けて足し合わせています。\(p=p_0\) で計算すればα、\(p=p_1\) で計算すれば検出力になります。
# 二段階デザインの動作特性を二項分布から直接計算する関数
oc_simon <- function(r1, n1, r, n, p) {
  pet <- pbinom(r1, n1, p)                 # 第1段階で中止する確率(PET)
  x1  <- (r1 + 1):n1                       # 第2段階へ進むときの第1段階の奏効数
  # 合計の奏効数が r を超えたら「有望」と判定する確率
  reject <- sum(dbinom(x1, n1, p) * (1 - pbinom(r - x1, n - n1, p)))
  c(PET = pet, EN = n1 + (1 - pet) * (n - n1), reject = reject)
}

round(rbind(
  optimal_p0 = oc_simon(3, 13, 12, 43, p = 0.2),
  optimal_p1 = oc_simon(3, 13, 12, 43, p = 0.4),
  minimax_p0 = oc_simon(4, 18, 10, 33, p = 0.2),
  minimax_p1 = oc_simon(4, 18, 10, 33, p = 0.4)), 4)
              PET      EN reject
optimal_p0 0.7473 20.5803 0.0496
optimal_p1 0.1686 37.9426 0.8002
minimax_p0 0.7164 22.2547 0.0458
minimax_p1 0.0942 31.5875 0.8011
- \(p=0.2\) の行の
rejectが第1種の過誤です。最適は0.0496、ミニマックスは0.0458で、どちらも0.05以下に収まっています。 - \(p=0.4\) の行の
rejectが検出力です。最適は0.8002、ミニマックスは0.8011で、どちらも80%以上です。 - \(p=0.2\) の行の PET と EN は、
ph2simon()の出力(0.7473/20.58、0.7164/22.25)と一致します。clinfun の出力は、二項分布の足し算で完全に再現できます。 - 薬が本当に効く場合(\(p=0.4\))でも、最適デザインは16.9%(0.1686)の確率で第1段階で止まってしまいます。ミニマックスでは9.4%(0.0942)です。無効中止は、効く薬を誤って止めるリスクと引き換えであり、そのぶんも含めて検出力80%を確保しています。
最適デザインとミニマックスデザインの選び方 ― 動作特性で比べる
設計の吟味は、\(p_0\) と \(p_1\) の2点だけで終わらせてはいけません。真の奏効率をいろいろ動かしたとき、「有望」と判定される確率(動作特性:operating characteristics)と期待症例数がどう変わるかを見ます。前節の oc_simon() を使います。症例数設計の考え方そのものは、検出力分析(Power Analysis)入門で復習できます。
# 真の奏効率を動かしたときの「有望」判定確率と期待症例数
p_true <- c(0.1, 0.2, 0.3, 0.4, 0.5)
opt <- sapply(p_true, function(p) oc_simon(3, 13, 12, 43, p))
mmx <- sapply(p_true, function(p) oc_simon(4, 18, 10, 33, p))
tab <- data.frame(p_true,
                  opt_reject = opt["reject", ], opt_EN = opt["EN", ],
                  mmx_reject = mmx["reject", ], mmx_EN = mmx["EN", ])
round(tab, 3)
  p_true opt_reject opt_EN mmx_reject mmx_EN
1    0.1      0.000 14.025      0.000 18.423
2    0.2      0.050 20.580      0.046 22.255
3    0.3      0.408 30.382      0.373 28.010
4    0.4      0.800 37.943      0.801 31.587
5    0.5      0.953 41.616      0.973 32.768
- 薬がまったく効かない(\(p=0.1\))とき、最適デザインの期待症例数は14.0(14.025)例で、ほぼ第1段階だけで終わります。ミニマックスは18.4(18.423)例です。
- 真の奏効率が \(p_0\) と \(p_1\) の中間の30%のとき、有望と判定される確率は最適が0.408、ミニマックスが0.373です。「そこそこ効く薬」は、半々以下の確率でしか拾えません。\(p_1\) を楽観的に高く置きすぎると、この灰色地帯が広がります。
- 期待症例数で有利なのは、「効かない」側では最適、「効く」側ではミニマックスです。\(p=0.3\) 以上では、ミニマックスのほうが少なくなります(30.382 対 28.010、37.943 対 31.587)。
- 選び方の目安は次のとおりです。効かない可能性が高い候補を多数ふるい分けるなら最適デザイン、登録が遅い・最大症例数(予算や期間)に上限がある希少疾患などではミニマックス、迷えば Admissible です。
設計表の「最適」は、ある基準で最良という意味にすぎません。最適デザインは \(H_0\) のもとでの期待症例数だけを最小化しており、最大症例数は43例とミニマックスより10例多くなります。
なお、ランダム化試験の中間解析では、条件付き検出力(Conditional Power)と無効中止で、観測データを踏まえて無効中止を判断します。Simonの二段階デザインは、中止の境界を試験開始前に表で決めておく点が対照的です。
試験終了後の解析 ― 二段階であることを無視するとどうずれるか
設計どおりに試験を終えたとします。最適デザイン(3/13, 12/43)で試験を行い、第1段階で4例以上が奏効したので第2段階へ進み、最終的に43例中15例が奏効しました。15例は13例以上ですから「有望」と判定されます。ここで「15/43=34.9%、二項検定でp=0.016」と報告してよいでしょうか。
この試験は「第1段階で止まっていたかもしれない」二段階の試験です。その事実を無視して43例の単純な試験として解析すると、推定値もp値も信頼区間もずれます。p値そのものの考え方はp値とは何か?で復習できます。
まず、clinfunの twostage.inference() で二段階を考慮した解析を行い、binom.test() による素朴な解析と並べます。前章までに読み込んだ clinfun を使います。
# 最適デザインで、第2段階まで進み 43 例中 15 例が奏効した場合の解析
twostage.inference(x = 15, r1 = 3, n1 = 13, n = 43, pu = 0.2)

# 二段階であることを無視して、43 例の単純な二項検定として解析した場合
bt   <- binom.test(15, 43, p = 0.2, alternative = "greater")
ci90 <- binom.test(15, 43, conf.level = 0.90)$conf.int
round(c(estimate = unname(bt$estimate), p.value = bt$p.value,
        LCL = ci90[1], UCL = ci90[2]), 4)
    pumvue    p.value     5% LCL    95% UCL
0.39485004 0.01301676 0.23540000 0.50630000
estimate  p.value      LCL      UCL
  0.3488   0.0164   0.2288   0.4852
| 解析方法 | 奏効率の推定値 | 片側p値 | 90%信頼区間 |
|---|---|---|---|
| 二段階を考慮(twostage.inference) | 0.395(UMVUE) | 0.0130 | 0.235〜0.506 |
| 二段階を無視(binom.test) | 0.349(15/43) | 0.0164 | 0.229〜0.485 |
pumvueは UMVUE(一様最小分散不偏推定量。偏りのない推定量のうち分散が最小のもの)です。p.valueは二段階を考慮した片側p値、5% LCLと95% UCLは二段階を考慮した両側90%信頼区間です。比較のため、素朴な解析も90%信頼区間にそろえています。- 結論(有望と判定)はどちらでも変わりません。しかし推定値は 0.395−0.349 で約4.6ポイント違います。論文や第III相の症例数設計に使う奏効率が、これだけずれるのです。
- 二段階を考慮したp値は、「\(p=0.2\) のもとで、第2段階まで進み、かつ合計の奏効数が15例以上になる確率」です。素朴な二項検定は、第1段階で3例以下だった(本来はそこで止まっていた)のに合計が15例以上になる経路まで数えてしまうため、p値が大きくなります。
二段階を考慮したp値は、二項分布の足し算で再現できます。
sum(dbinom(4:13, 13, 0.2) * (1 - pbinom(14 - (4:13), 30, 0.2)))
これを実行すると 0.01301676 となり、twostage.inference() の p.value と完全に一致します。clinfunの出力も、ここまでは二項分布の足し算にすぎません。では、素朴な推定値の15/43はなぜ小さく出るのでしょうか。
素朴な推定値が過小になる理由をシミュレーションで確かめる
真の奏効率を40%とおいて、最適デザインの試験を10万回くり返します。止まった試験は第1段階の x1/13、進んだ試験は合計/43を素朴な推定値とし、UMVUEと平均を比べます。
# 真の奏効率 40% で最適デザインの試験を 10 万回くり返す
set.seed(2026)
B  <- 100000
x1 <- rbinom(B, 13, 0.4)          # 第1段階の奏効数
x2 <- rbinom(B, 30, 0.4)          # 第2段階の奏効数(進んだ場合に使う)
go <- x1 > 3                      # 第2段階へ進んだ試験

# 素朴な推定値:止まった試験は x1/13、進んだ試験は合計/43
naive <- ifelse(go, (x1 + x2) / 43, x1 / 13)

# UMVUE:進んだ試験の合計奏効数(4〜43)ごとに計算しておき、当てはめる
um_tab <- sapply(4:43, function(x)
  twostage.inference(x, r1 = 3, n1 = 13, n = 43, pu = 0.2)[["pumvue"]])
umvue  <- ifelse(go, um_tab[x1 + x2 - 3], x1 / 13)

round(c(naive = mean(naive), umvue = mean(umvue)), 4)
 naive  umvue
0.3764 0.4001
- 真の奏効率は 0.40 ですが、素朴な推定値の平均は 0.3764 で、0.40−0.3764 の約2.4ポイント過小です。UMVUEの平均は 0.4001 で、ほぼ偏りがありません。
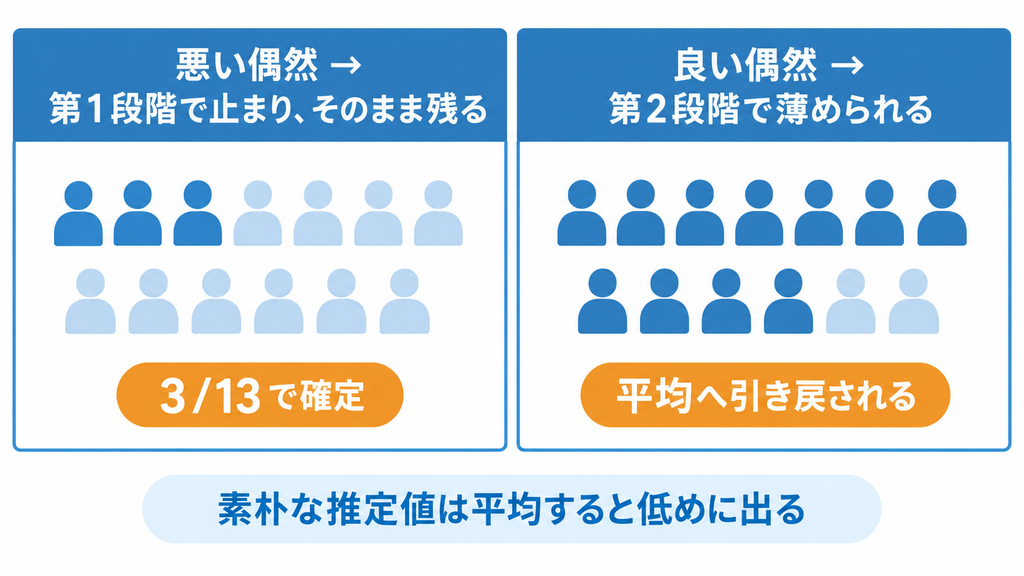
- 理由は次のとおりです。第1段階でたまたま成績が悪かった試験だけが13例の時点で止まり、その低い値(たとえば 3/13)が少ない症例数のまま確定します。一方、たまたま成績が良かった試験は第2段階へ進み、残り30例で平均へ引き戻されます。「悪い偶然はそのまま残り、良い偶然は薄められる」ので、全体として下に偏ります。
- 第1段階で止まった試験のUMVUEは x1/13で、素朴な推定値と同じです。違いが出るのは第2段階まで進んだ試験です。
二段階・逐次的なデザインでは、「どこで止まったか」自体が情報になります。止まり方を無視した解析が偏るという構造は、群逐次デザインでも同じです。詳しくはGroup Sequential Design R実装比較をご覧ください。
Simonの二段階デザインで得た結果は、
binom.test() ではなく二段階を考慮した方法(UMVUE・段階を考慮したp値と信頼区間)で報告します。どの方法で推定するかは、解析計画書に事前に書いておきます。実務でのポイント ― プロトコル作成から結果の報告まで
設計値が求まれば終わり、ではありません。プロトコル作成から報告までに、判断を誤りやすい点が6つあります。
\(p_0\) の根拠を示す:既存治療の奏効率を、文献や過去の試験から示します。\(p_0\) を低く見積もると、効かない薬が有望に見えてしまいます。根拠とした試験と、対象集団(前治療歴など)がそろっているかも確認してください。
第1段階と第2段階のあいだ:第1段階の \(n_1\) 例の奏効判定がそろうまで、登録を一時中断するのが原則です。判定を待たずに登録を続けると、第1段階で中止になったときに余分な患者が組み入れられてしまいます。中断と再開の手順、実際の登録数が計画からずれた場合の扱いは、プロトコルに書いておきます。
評価可能例の定義:奏効の判定ができなかった患者(早期の脱落など)を分母に含めるかを、事前に決めます。含めない運用にすると、奏効率が見かけ上高くなります。
単群試験の限界:対照群がないため、患者選択の偏りや \(p_0\) の設定違いの影響を受けやすい試験です。有望と判定されても、それは「次の比較試験に進む価値がある」という意味にとどまります。比較の意義は【やさしく解説】RCT(ランダム化比較試験)とはで確認できます。
ベイズ流の代替:途中で何度も見直したい場合は、事後確率や予測確率に基づくベイズ流の単群デザインも選択肢です。二値エンドポイントの単群臨床試験におけるベイズ流デザイン入門を参照してください。
解析計画書に書く:推定方法(UMVUE等)、p値と信頼区間の計算方法、評価可能例の定義を事前に明記します。書き方は統計解析計画書(SAP)の書き方が参考になります。
Simonの二段階デザインを使うときのチェックリスト
- \(p_0\)・\(p_1\) の根拠を、文献で示したか
- 最適・ミニマックスを、動作特性(\(p_0\)〜\(p_1\) の中間も含む)で比べたか
- 第1段階の判定待ちの登録中断と、登録数のずれへの対応を決めたか
- 評価可能例の定義を決めたか
- 結果を、二段階を考慮した推定・p値・信頼区間で報告する計画か
📚 この記事をより深く理解するための参考書籍
第II相試験のデザインを「ツールで計算できる」段階から「設計の理由を説明できる」段階へ進むための3冊を紹介します。



関連記事・次のステップ
症例数設計の基礎を固めたい方は、α・β・検出力の関係を仮説検定の“二種類の誤り”を深く理解するで、設計の一般論を検出力分析(Power Analysis)入門と1標本の群比較におけるサンプルサイズ設定で確認しておくと、本記事の設計値の意味がすっと入ります。奏効率の区間推定そのものは二項比率の信頼区間にまとめています。
開発の流れの中で第II相を位置づけたい方は、臨床試験のフェーズ(第I相〜第IV相)とはと第I相がん臨床試験の用量探索デザインが直接の前段になります。
途中で「やめる」判断をさらに深めたい方には、ランダム化試験の中間解析を扱った条件付き検出力(Conditional Power)と無効中止とGroup Sequential Design R実装比較、より柔軟な設計の枠組みとしてICH E20(臨床試験のためのアダプティブデザイン)とはがおすすめです。
ベイズ流の単群デザインに進みたい方は、二値エンドポイントの単群臨床試験におけるベイズ流デザイン入門からベイズ臨床試験デザイン入門の順に読むと、本記事の頻度論の設計との違いがよく見えます。試験デザインを仕事にする場の広がりは生物統計家の就職先はどこ?で整理しています。
まとめ
本記事では、第II相単群試験の標準的な設計であるSimonの二段階デザインを、閾値奏効率20%・期待奏効率40%・α=0.05・β=0.2という設定で、Rのclinfunを使って確かめながら整理しました。
出発点の単段階デザインでは35例が必要で、薬が効かなくても全員を登録しなければなりません。二段階にすると、最適デザイン(3/13, 12/43)は効かない薬なら約75%の確率で13例の時点で止まり、期待症例数は20.58例まで減ります。ミニマックスデザイン(4/18, 10/33)は最大症例数が33例で、単段階の35例より少なくなりました。無効中止が「効かない薬がたまたま有望に見える経路」を切り落とすためで、二段階にすると平均だけでなく最大まで小さくできる場合があります。これらの設計値は、すべて二項分布の足し算で手計算でき、αは0.0496、検出力は0.8002と、clinfunの出力と完全に一致しました。
試験終了後の解析にも落とし穴がありました。43例中15例が奏効したとき、二段階を無視した素朴な推定値は0.349ですが、二段階を考慮したUMVUEは0.395です。真の奏効率40%でのシミュレーションでは、素朴な推定値の平均は0.3764と過小に偏り、UMVUEは0.4001とほぼ偏りがありませんでした。「どこで止まったか」自体が情報になる設計では、止まり方を考慮した推定・p値・信頼区間で報告する必要があります。
Simonの二段階デザインは、効かない薬に患者を割り当てる人数を減らしつつ、次相へ進む候補を客観的な基準でふるい分けられる、実務で非常に有用な設計です。閾値奏効率の根拠、最適とミニマックスの動作特性の比較、第1段階の判定待ちの運用、評価可能例の定義、そして二段階を考慮した解析方法を事前に決めておくことで、信頼できる第II相試験の設計を実現していただければと思います。ベイズ流の単群デザインと比べてみたい方は二値エンドポイントの単群臨床試験におけるベイズ流デザイン入門を、中間解析の考え方を広げたい方は条件付き検出力(Conditional Power)と無効中止をあわせてご覧ください。