【やさしく解説】平均値と中央値の違い ― 外れ値・歪んだ分布での使い分けと最頻値との関係をRで体感する ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- 平均値・中央値・最頻値の決め方と、それぞれの性格の違い
- 外れ値が1つ入ったとき、そして分布が歪んでいるときに、平均値がどうずれるか
- いつも中央値が正解ではなく、平均値のほうが優れている場面があること
- 論文での書き分け(平均値±標準偏差/中央値[四分位範囲])
- 生存時間の解析で、平均値ではなく中央値が使われる理由
はじめに
「平均年収」「平均睡眠時間」「平均入院日数」など、私たちの身のまわりには「平均」という言葉があふれています。ところが、平均値がそのデータの「ふつう」を表しているとは限りません。ニュースで「平均は○○円」と聞いて、「自分の感覚とずいぶん違う」と感じたことはないでしょうか。
この記事は、統計を学び始めた大学生や社会人、製薬業界の新人、医療職や臨床開発で統計の専門家ではない方に向けて書いています。数式はほとんど使いません。Rで実際にデータを動かしながら、3つの代表値(平均値・中央値・最頻値)の性格の違いを体感していきましょう。Rをまだ触ったことがない方は、先にR入門の記事で環境を整えておくと、コードを自分の手で動かせて理解が深まります。
平均値・中央値・最頻値とは ― 3つの代表値の決め方
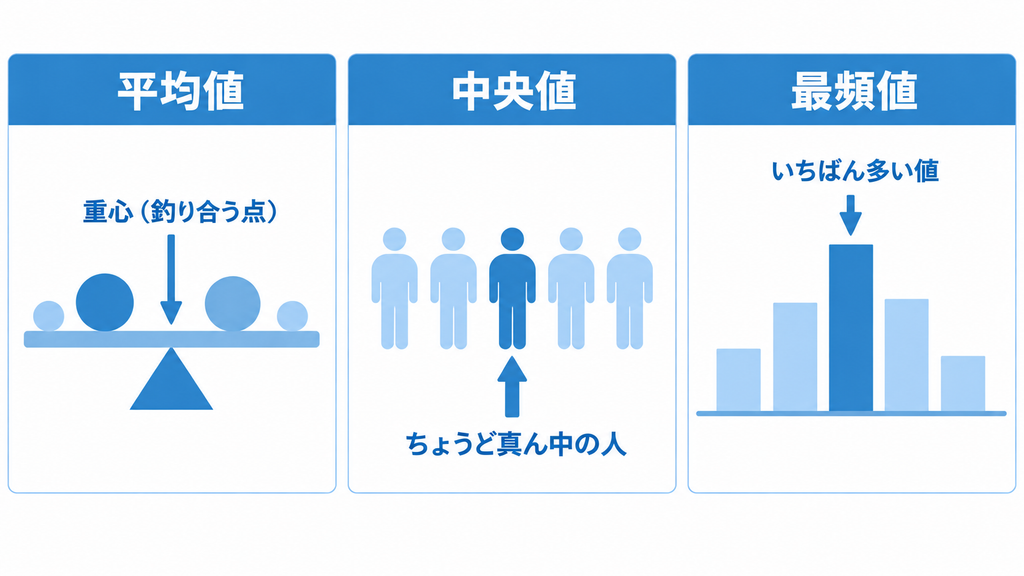
まず用語を整理します。代表値とは、データ全体を1つの数字で要約したものです。何百人分の検査値も、代表値を1つ示せば「だいたいこのあたり」と伝えられます。その決め方が3通りあります。
- 平均値:全部の値を足して、人数で割ったもの
- 中央値:小さい順に並べたときの真ん中の値(人数が偶数のときは、真ん中2つの平均)
- 最頻値:いちばん多く現れる値
イメージとしては、平均値はシーソーが釣り合う点(重心)、中央値は人数をちょうど半分に分ける線、最頻値はいちばん高い山の位置です。シーソーの端に重い人が1人乗ると釣り合う点が大きく動くように、平均値は極端な値に引っ張られます。一方、中央値は「何番目か」しか見ないので、端の値がどれほど大きくても動きません。
3つの違いをまとめます。
| 代表値 | 決め方 | 外れ値への強さ | 得意なデータ | 弱点 |
|---|---|---|---|---|
| 平均値 | 全部足して人数で割る | 弱い(極端な値で大きく動く) | 左右対称に近いデータ、合計や総量を知りたいとき | 外れ値や分布の歪みに引っ張られる |
| 中央値 | 小さい順に並べた真ん中の値 | 強い | 歪んだデータ、外れ値を含むデータ | 値の大きさを使い切らないため、きれいなデータでは精度が落ちる |
| 最頻値 | いちばん多く現れる値 | 強い | カテゴリや順序のあるデータ、山の位置を知りたいとき | 値がばらばらだと決まりにくい |
「平均値は真ん中の人の値」と混同してしまう方がよくいます。しかし、データを小さい順に並べて真ん中に来る人の値は、平均値ではなく中央値です。平均値は、あくまで「全員の値を足して割った計算結果」であり、実際には誰もその値を持っていないこともあります。
もう1つ大切なことがあります。代表値だけでは、データの姿は語れません。同じ平均値でも、全員がほぼ同じ値のグループと、大きくばらついたグループでは中身がまったく違います。代表値は、ばらつきの指標とセットで示す必要があります。ばらつきの指標の読み方は、【やさしく解説】標準偏差(SD)と標準誤差(SE)の違いで解説しています。
なお、代表値と分布の歪みの関係は、統計検定2級でも定番の出題です。試験対策を考えている方は、統計検定2級の勉強法もあわせてご覧ください。
それでは次の章から、実際にRでデータを動かして、3つの代表値がどう振る舞うかを見ていきましょう。
外れ値が1つ入ると平均値と中央値はどう動くか
まずは、ある病棟の入院日数という身近な例で試してみましょう。9人分の入院日数から3つの代表値を求め、そこへ「90日間入院した患者さん」が10人目として加わったらどう変わるかを見ます。
Rには最頻値を求める組み込み関数がありません(mode() は別の意味の関数です)。そこで table() で値を数えて、いちばん多い値を返す関数を自作しています。あわせてトリム平均(両端のデータをあらかじめ決めた割合だけ除いて平均したもの)も出します。10人のときの中央値は、5番目と6番目(どちらも7)の平均です。トリム平均は上下10%、つまり最小の5と最大の90を1人ずつ除いた8人の平均です。
# ある病棟の入院日数(日):9人分
days <- c(5, 6, 6, 7, 7, 7, 8, 9, 10)

mode_value <- function(x) as.numeric(names(which.max(table(x))))

cat("【9人】      平均値:", round(mean(days), 2),
    " 中央値:", median(days), " 最頻値:", mode_value(days), "\n")

# 10人目として、90日間入院した患者が1人加わった
days2 <- c(days, 90)

cat("【10人】     平均値:", round(mean(days2), 2),
    " 中央値:", median(days2), " 最頻値:", mode_value(days2), "\n")
cat("平均値より入院が短かった人:", sum(days2 < mean(days2)), "人 / 10人\n")
cat("上下10%を除いたトリム平均:", mean(days2, trim = 0.1), "\n")
【9人】      平均値: 7.22  中央値: 7  最頻値: 7
【10人】     平均値: 15.5  中央値: 7  最頻値: 7
平均値より入院が短かった人: 9 人 / 10人
上下10%を除いたトリム平均: 7.5
- 9人のときは、平均値 7.22・中央値 7・最頻値 7 がほぼ一致しています。左右対称に近いデータなら、3つの代表値はどれを使ってもほぼ同じです。
- 90日の患者さんが1人加わっただけで、平均値は 7.22 → 15.5 と2倍以上になりました。一方、中央値と最頻値は 7 のまま動きません。
- 平均値の15.5日より入院が短かった人は10人中9人です。「平均入院日数は15.5日」と報告すると、実際には誰にも当てはまらない数字が病棟の代表になってしまいます。
- トリム平均は 7.5 でした。外れ値を「捨てる」か「残す」かの二択ではなく、あらかじめ決めたルールで両端を除く中間的な方法もあります。
ただし、90日の患者さんを「外れ値だから」と消してはいけません。入力ミスでない限り、この方は実在の患者さんです。病床の運用や医療費を考える立場では、むしろ最重要の1人でしょう。外れ値をどう見つけ、どう扱うかは 外れ値検出とSmirnov-Grubbs棄却検定 で詳しく解説しています。
平均値にしか答えられない問いもあります。たとえば「この病棟では10人でのべ何日分のベッドが必要か」を知りたい場面を考えます。平均値 15.5日に人数の10を掛けると155日となり、10人の入院日数の合計とぴったり一致します。ところが中央値の7日に10を掛けても70日にしかならず、実際に必要なベッドの半分にも届きません。平均値は「合計を人数で割ったもの」なので、人数を掛ければ必ず合計に戻ります。中央値にはこの性質がありません。
つまり、90日の患者さんに引っ張られた平均値 15.5日は「典型的な患者さんの入院日数」としては不適切でも、「病棟全体の負荷」を測る数字としては正しく働いています。医療費の総額、薬剤の必要量、スタッフの配置のように合計が問題になる場面では、外れ値があっても平均値が必要です。平均値と中央値のどちらが優れているかではなく、「いま知りたいのは典型的な1人のことか、全体の合計のことか」で選ぶ、というのが使い分けの出発点になります。
歪んだ分布では「平均値より下」が多数派になる
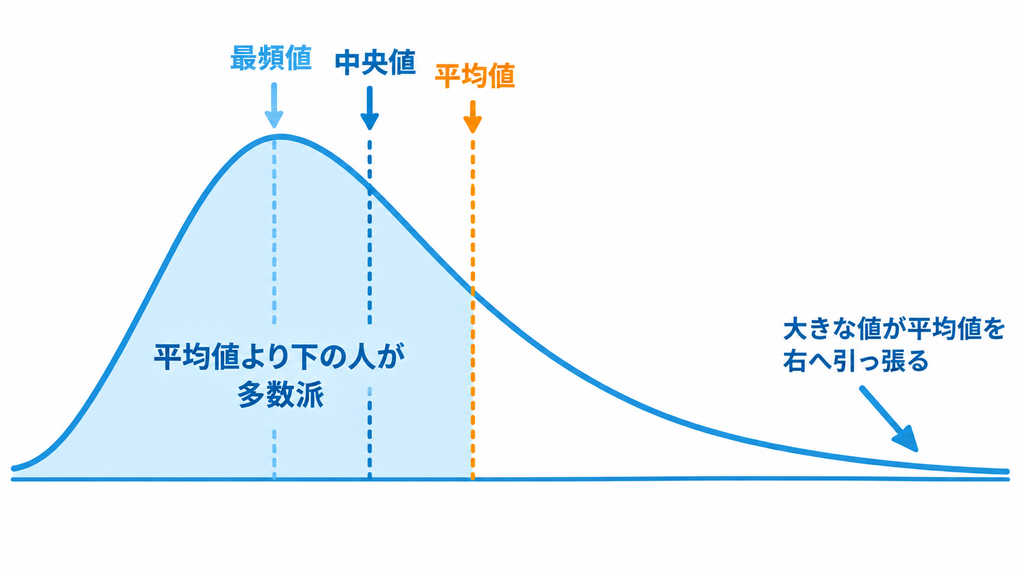
検査値、入院費、年収のように「下限は0で、上にはいくらでも伸びる」データは、右に長い裾を引く分布(右に歪んだ分布)になりやすい性質があります。ここでは、そうした分布の代表である対数正規分布から1,000人分の検査値をつくって確かめます。
set.seed(20261005)
# 右に長い裾を引く検査値を1,000人分つくる(対数正規分布)
x <- rlnorm(1000, meanlog = log(100), sdlog = 0.8)

cat("平均値:", round(mean(x), 1), " 中央値:", round(median(x), 1), "\n")
cat("平均値より小さい人の割合:", mean(x < mean(x)), "\n")
cat("標準偏差:", round(sd(x), 1),
    " 四分位範囲: [", round(quantile(x, 0.25), 1), ",", round(quantile(x, 0.75), 1), "]\n")
cat("平均値-標準偏差:", round(mean(x) - sd(x), 1), "\n")
cat("幾何平均:", round(exp(mean(log(x))), 1), "\n")
cat("最小値:", round(min(x), 1), " 最大値:", round(max(x), 1), "\n")
平均値: 136  中央値: 98.5
平均値より小さい人の割合: 0.645
標準偏差: 126.7  四分位範囲: [ 59.8 , 167.6 ]
平均値-標準偏差: 9.3
幾何平均: 99
最小値: 10.1  最大値: 1402.3
- 平均値 136 に対して中央値は 98.5 です。平均値は裾にある大きな値(最大 1402.3)に引っ張られ、右へずれています。
- 平均値より小さい人が 64.5% もいます。つまり「平均以下」が多数派になります。「平均=ふつうの人」という感覚は、歪んだ分布では成り立ちません。
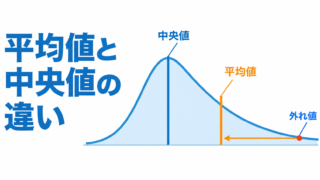
- 右に歪んだ分布では、一般に最頻値 < 中央値 < 平均値の順に並びます。山のてっぺんが左にあり、裾の長い右側へ向かって中央値、平均値と引きずられていくイメージです。
- 幾何平均 99 は中央値 98.5 とほぼ一致しました。対数をとると左右対称になるデータでは、対数の世界で平均してから元に戻した幾何平均が「真ん中」を表します。血中濃度などの薬物動態の指標で幾何平均が標準的に使われるのはこのためです。詳しくは 生物学的同等性試験(BE)とは をご覧ください。
歪んだデータに「平均値±標準偏差」は危険です。平均値−標準偏差は 9.3 で、最小値 10.1 より小さくなっています。「136±126.7」と書くと、実際には1人もいない範囲まで含めて示すことになります。歪んだデータは「中央値 98.5[四分位範囲 59.8〜167.6]」と書くほうが実態を表します。
分布の形ごとに、3つの代表値の並びとおすすめの要約方法をまとめると次の表のとおりです。
| 分布の形 | 3つの代表値の並び | おすすめの要約 |
|---|---|---|
| 左右対称 | 平均値 ≒ 中央値 ≒ 最頻値 | 平均値±標準偏差 |
| 右に歪む(右に長い裾) | 最頻値 < 中央値 < 平均値 | 中央値[四分位範囲] |
| 左に歪む(左に長い裾) | 平均値 < 中央値 < 最頻値 | 中央値[四分位範囲] |
「自分のデータが左右対称かどうか」を確かめたくなったら、正規性の検定も1つの手です。ただし、検定の前にまずヒストグラムやQ-Qプロットで形を見るのが先です。検定の考え方は 正規性の検定(Shapiro-Wilk)とは で解説しています。
いつも中央値が正解ではない ― 平均値の強みをRで確かめる
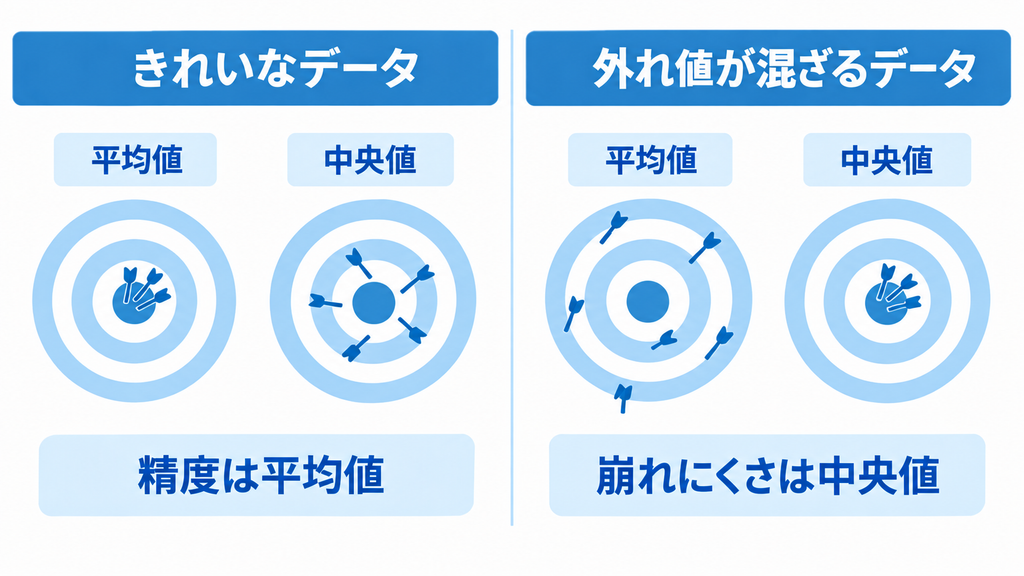
ここまで読むと「外れ値が怖いから、とりあえず中央値を使えばいい」と思いたくなります。しかし、それは半分だけ正解です。きれいなデータでは、平均値のほうが少ないデータで真ん中を精度よく当てられます。
実験の設定:同じ母集団から50人分の標本を5,000回とり、平均値と中央値が毎回どれくらいブレるか(5,000個の推定値の標準偏差)を比べます。比べるのは、(1)きれいな正規分布(収縮期血圧:平均120、標準偏差15)と、(2)全体の5%だけ極端にばらつく値が混ざる場合(入力ミスや特殊な患者のイメージ)の2通りです。
set.seed(123)
# n=50 の標本を5,000回とり、平均値と中央値が毎回どれくらいブレるかを比べる
compare_stability <- function(generator, nsim = 5000, n = 50) {
  est <- replicate(nsim, {
    x <- generator(n)
    c(mean(x), median(x))
  })
  round(apply(est, 1, sd), 2)
}

# (1) きれいな正規分布:収縮期血圧(平均120、標準偏差15)
clean <- function(n) rnorm(n, 120, 15)

# (2) 5%だけ極端にばらつく値が混ざる(入力ミスや特殊な患者をイメージ)
dirty <- function(n) {
  ifelse(runif(n) < 0.05, rnorm(n, 120, 150), rnorm(n, 120, 15))
}

r1 <- compare_stability(clean)
r2 <- compare_stability(dirty)
cat("きれいな正規分布   平均値のブレ:", r1[1], " 中央値のブレ:", r1[2], "\n")
cat("外れ値が5%混ざる   平均値のブレ:", r2[1], " 中央値のブレ:", r2[2], "\n")
きれいな正規分布   平均値のブレ: 2.07  中央値のブレ: 2.61
外れ値が5%混ざる   平均値のブレ: 5.26  中央値のブレ: 2.82
- きれいな正規分布では、平均値のブレ2.07に対して中央値は2.61です。中央値のほうが約1.26倍(2.61÷2.07)ブレます。同じ精度を中央値で得るには、より多くの症例が必要になります。
- 理由は直感的です。平均値は全員の値を使い切りますが、中央値は「真ん中付近の順番」しか使わず、情報を一部捨てているからです。
- 外れ値が5%混ざると逆転します。平均値のブレは2.07→5.26と約2.5倍に膨らむのに、中央値は2.61→2.82とほとんど変わりません。この「崩れにくさ」を頑健性(ロバスト性)と呼びます。
t検定など多くの手法が平均値を土台にしているのは、この精度の高さに加えて、数学的な扱いやすさ(足し合わせられる・中心極限定理が使える)があるためです。標本平均が正規分布に近づく性質は、中心極限定理とはで詳しく解説しています。一方、中央値の信頼区間は公式が簡単ではありません。そんなときは、データを再抽出して揺れ幅を見るブートストラップ法とはが便利です。
精度の平均値、頑健性の中央値。これはトレードオフです。きれいなデータで「とりあえず中央値」にすると精度を捨てることになり、外れ値が混ざるデータで平均値に頼るとブレが大きくなります。データの形を見て選びましょう。
臨床試験・医学論文での平均値と中央値の使い分け
生存時間は打ち切りがあるので単純に計算できない
生存時間データには、平均値でも中央値でも単純に計算できない事情があります。打ち切り(観察が終わった時点で、まだイベントが起きていないこと)です。Rのsurvivalパッケージに入っているlungデータ(進行肺がん患者228人の生存時間)で確かめましょう。statusは1が打ち切り、2が死亡です。
library(survival)

# 進行肺がん患者228人の生存時間データ(status: 1=打ち切り, 2=死亡)
cat("打ち切り(まだ生存中に観察が終わった)人数:", sum(lung$status == 1), "人 / 228人\n")
cat("打ち切りを無視した単純な中央値:", median(lung$time), "日\n")
cat("打ち切りを無視した単純な平均値:", round(mean(lung$time), 1), "日\n\n")

# カプラン・マイヤー法による生存期間中央値
fit <- survfit(Surv(time, status) ~ 1, data = lung)
print(fit)
打ち切り(まだ生存中に観察が終わった)人数: 63 人 / 228人
打ち切りを無視した単純な中央値: 255.5 日
打ち切りを無視した単純な平均値: 305.2 日

Call: survfit(formula = Surv(time, status) ~ 1, data = lung)

       n events median 0.95LCL 0.95UCL
[1,] 228    165    310     285     363
- 228人中63人は、観察終了時点でまだ生存していました。この63人の本当の生存時間は、記録された日数より長いことしか分かりません。
- それを無視して
median()を当てると255.5日、mean()では305.2日です。どちらも打ち切りの人を実際より短く扱っているため、過小評価になります。 - カプラン・マイヤー法で打ち切りを正しく扱うと、生存期間中央値は310日(95%信頼区間285〜363日)です。単純な中央値255.5日とは54.5日の差があります。
生存時間で平均値ではなく中央値が報告されるのには、2つの理由があります。1つ目は、分布が右に歪みやすいことです。2つ目は、全員にイベントが起きるまで待たないと平均値は確定しないのに対し、中央値は半数にイベントが起きた時点で求まることです。打ち切りの扱いはカプランマイヤー法(Kaplan-Meier法)とはで学べます。それでも平均が知りたいときの道具として、ある時点までに区切った平均生存時間であるRMSTがあります。詳しくはRMST(制限付き平均生存時間)解析ガイドをご覧ください。
論文の背景表(Table 1)での書き分け
論文の背景表では、左右対称に近い連続変数は「平均値±標準偏差」、歪んだ変数は「中央値[四分位範囲]」と書くのが一般的です。
| データの種類 | よく使う代表値 | ばらつきの示し方 | 例 |
|---|---|---|---|
| 左右対称に近い連続値 | 平均値 | 標準偏差 | 血圧・身長など |
| 右に歪む連続値 | 中央値 | 四分位範囲 | 検査値・入院日数など |
| 薬物動態の指標 | 幾何平均 | 幾何変動係数 | 血中濃度など |
| 生存時間 | カプラン・マイヤー法による中央値 | 95%信頼区間 | 全生存期間など |
| 順序のあるカテゴリ | 中央値・最頻値 | 各段階の人数と割合 | 重症度の段階など |
代表値の選択は、検定の選択ともつながっています。平均値の差を見るならt検定、分布の位置のずれを順位で見るならウィルコクソン検定です。ただしウィルコクソン検定は、厳密には「中央値の差の検定」ではない点に注意してください。詳しくはノンパラメトリック検定の代表格:ウィルコクソン検定の数理と実装で解説しています。
また、どちらを使うかを、データを見てから都合よく選んではいけません。結果が良く見えるほうを後から選ぶと、結論が歪みます。臨床試験では、解析計画であらかじめ決めておきます。
最後に、初めて代表値を使い分けるときによく出る疑問を3つ取り上げます。
平均値と中央値が大きく違うときは、どちらを報告すればよいですか。 迷ったら両方を示すのが安全です。2つの値が離れていること自体が「分布が歪んでいる」「外れ値がある」という大事な情報だからです。本記事の検査値の例でも、平均値 136 と中央値 98.5 を並べて見せるだけで、読み手は右に長い裾があることに気づけます。逆に、平均値と中央値がほぼ同じなら、分布は左右対称に近いと見当がつきます。まず mean() と median() を両方計算して見比べる習慣をつけると、ヒストグラムを描く前の簡単な点検になります。
人数が少ないときは、どちらが向いていますか。 人数が少ないほど、1人の値が平均値を動かす力は大きくなります。入院日数の例では、10人のうち1人が平均値を2倍以上にしました。これが1,000人の中の1人であれば、平均値への影響はずっと小さくなります。少人数のデータこそ、1人ひとりの値を点で描いたグラフを見て、平均値が特定の誰かに引っ張られていないかを確かめてください。
最頻値はいつ使うのですか。 連続した数値では同じ値がほとんど重ならないため、最頻値は区切り方しだいで変わってしまい、あまり使われません。活躍するのは、血液型や重症度の段階のようなカテゴリのデータです。こうしたデータは足したり割ったりできないので平均値が計算できず、「いちばん多いのはどれか」という最頻値が自然な代表値になります。
迷ったときは、次の4項目を確認しましょう。
- ヒストグラムを描いて、分布の形を見たか
- 外れ値は入力ミスか、実在の値か(実在なら安易に消さない)
- 知りたいのは「合計に効く平均」か、「典型的な1人」か
- 打ち切りはないか(あるなら単純な平均値・中央値は使えない)
📚 この記事をより深く理解するための参考書籍
「平均」という言葉にだまされない感覚を養い、そこから統計学の基礎へ進むための3冊を紹介します。



関連記事・次のステップ
基礎統計をもう一歩進めたい方は、代表値の相棒であるばらつきの指標を【やさしく解説】標準偏差(SD)と標準誤差(SE)の違いで押さえ、平均値がなぜ扱いやすいのかを中心極限定理とはで確かめるのがおすすめです。そこから区間推定入門・p値とは何か?・効果量(Effect Size)を理解すると統計が一気に実務的になるへ進むと、推測統計の入口がひととおり見渡せます。
外れ値や分布の形が気になった方には、外れ値検出とSmirnov-Grubbs棄却検定と正規性の検定(Shapiro-Wilk)とはが直接の続きになります。順位にもとづく検定はウィルコクソン検定の数理と実装、中央値の信頼区間のつくり方はブートストラップ法とはで扱っています。
臨床試験での使われ方を知りたい方は、生存期間中央値の求め方をカプランマイヤー法(Kaplan-Meier法)とはで、平均で語る方法をRMST(制限付き平均生存時間)解析ガイドでご覧ください。幾何平均が主役になる場面は生物学的同等性試験(BE)とは、試験そのものの仕組みは【やさしく解説】RCT(ランダム化比較試験)とはにまとめています。
Rの操作や資格の勉強から始めたい方は、R入門と統計検定2級の勉強法、統計検定2級「仮説検定・区間推定」攻略をどうぞ。統計を仕事にすることに興味が出てきた方は生物統計家の就職先はどこ?もあわせてご覧ください。
まとめ
本記事では、平均値と中央値の違いを、最頻値との関係も含めてRで確かめながら整理しました。
最初に見たのは、平均値がたった1人の値で大きく動くという性質です。9人の入院日数では平均値 7.22・中央値 7・最頻値 7 とほぼ揃っていたのに、90日入院した患者が1人加わるだけで平均値は 15.5 に跳ね上がり、10人中9人が「平均より短い」側に回りました。右に長い裾を引く検査値でも同じことが起き、平均値 136 に対して中央値は 98.5、平均値より小さい人が 64.5% を占めました。こうしたデータを「平均値±標準偏差」で要約すると、平均値−標準偏差が 9.3 と最小値 10.1 を下回り、誰もいない範囲まで示してしまいます。中央値と四分位範囲[59.8〜167.6]で示すほうが実態に合います。
一方で、中央値がいつも正解というわけでもありませんでした。きれいな正規分布では、平均値のブレ 2.07 に対して中央値は 2.61 と、平均値のほうが少ないデータで精度よく真ん中を当てられます。外れ値が5%混ざると平均値のブレは 5.26 まで膨らみ、中央値は 2.82 とほとんど変わりません。精度の平均値、頑健性の中央値という持ち味の違いを知ったうえで選ぶことが大切です。さらに生存時間のように打ち切りがあるデータでは、単純な中央値 255.5日 は過小評価であり、カプラン・マイヤー法で求めた 310日(95%信頼区間 285〜363日)が正しい生存期間中央値でした。
代表値を選ぶ前に、まずヒストグラムを描いて分布の形を見る。外れ値は入力ミスなのか実在の値なのかを確かめる。知りたいのが「合計に効く平均」なのか「典型的な1人」なのかをはっきりさせる。この3つを習慣にするだけで、論文やニュースに出てくる「平均」という言葉の受け取り方が変わります。次の一歩として、ばらつきの示し方を固めたい方は【やさしく解説】標準偏差(SD)と標準誤差(SE)の違いを、生存期間中央値の仕組みを知りたい方はカプランマイヤー法(Kaplan-Meier法)とはをご覧いただければと思います。