統計検定2級「仮説検定・区間推定」攻略 ― t検定・カイ二乗検定・p値の典型出題を例題7問で解説 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- 統計検定2級で出る「区間推定」と「仮説検定」の考え方(p値・2種類の過誤)
- 母平均・母比率の信頼区間、t検定・F検定・カイ二乗検定を本番形式の例題7問で解く手順
- 普通電卓でできる途中式と、棄却限界との比べ方
- すべての例題をRで答え合わせする方法(
t.test()・chisq.test()・prop.test()) - 検定の選び方の一覧表と、本番でやりがちな間違い
はじめに
統計検定2級で合否を分けやすいのが、推定と検定の分野です。公式を覚えるだけなら難しくありませんが、本番では「どの検定を使うか」「分母に何を入れるか」「自由度はいくつか」「片側か両側か」を短時間で判断しなければなりません。ここで一つでも取り違えると、計算が合っていても誤った選択肢を選ぶことになります。
試験の概要は次のとおりです(2026年9月時点で統計検定の公式サイトに記載されている内容です。受験前には公式サイトで最新情報をご確認ください)。
| 項目 | 内容 |
|---|---|
| 試験方式・時間 | CBT方式・90分 |
| 問題数・形式 | 35問程度・4〜5肢選択 |
| 合格基準 | 100点満点で60点以上 |
| 電卓 | 四則演算・百分率・平方根ができる普通電卓のみ(関数電卓は不可) |
| 推定・検定の出題範囲 | 区間推定(母平均・母比率・母分散)、仮説検定(p値・2種類の過誤、母平均・母比率・母分散の1標本・2標本の検定)、適合度検定・独立性の検定 |
関数電卓が使えないため、分布の値は問題に付く数値表から読み取り、平方根と四則演算だけで答えまでたどり着く必要があります。本記事の例題も、すべて普通電卓で解ける数値にしています。
本記事で扱う例題は次の7問です。先に全体を眺めて、自分が苦手な検定から読み始めていただいても構いません。
| 例題 | 内容 | 使う分布 | 結論 |
|---|---|---|---|
| 例題1 | 母平均の95%信頼区間(16錠の有効成分量) | t分布(自由度15) | \([47.74,\ 56.26]\) |
| 例題2 | 母比率の95%信頼区間(400人中120人に副作用) | 標準正規分布 | \([0.2551,\ 0.3449]\) |
| 例題3 | 等分散のF検定と2標本t検定(各群10人) | F分布(9, 9)・t分布(自由度18) | 等分散は棄却しない/平均の差は有意 |
| 例題4 | 対応のあるt検定(8人の投与前後の血圧) | t分布(自由度7) | 有意(\(t=4.243\)) |
| 例題5 | 独立性の検定(新薬群と対照群の改善・非改善) | カイ二乗分布(自由度1) | 有意(\(\chi^2=4.511\)) |
| 例題6 | 適合度検定(理論比9:3:3:1) | カイ二乗分布(自由度3) | 棄却しない(\(\chi^2=0.711\)) |
| 例題7 | 母比率の検定(有効率60%に対し100人中70人) | 標準正規分布 | 有意(\(z=2.041\)) |
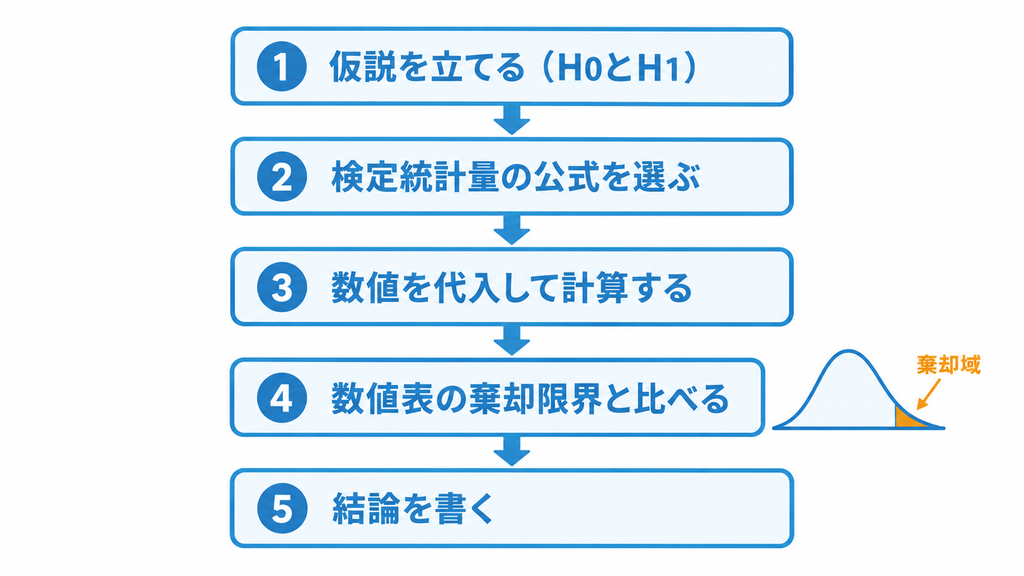
検定の例題は、どれも同じ5つの手順で解きます。①帰無仮説 \(H_0\) と対立仮説 \(H_1\) を立てる、②データの形から検定統計量の公式を選ぶ、③数値を代入して計算する、④数値表の棄却限界と比べる、⑤「\(H_0\) を棄却する/棄却しない」で結論を書く、の順です。手順を固定しておくと、時間に追われる本番でも途中で迷うことが減ります。
数値表の値は、本記事では \(t_{0.025}(15)=2.131\) のように、上側確率を添字に、自由度を括弧内に書きます。有意水準5%の両側検定では上側2.5%点を、片側検定では上側5%点を読みます。表を引く前に「添字の確率はいくつか」「自由度はいくつか」の2つを先に決めておくと、読み違いを防げます。
2級全体の学習計画や教材選びは統計検定2級の勉強法で紹介しています。本記事はその続きとして、推定と検定の分野に絞った攻略編です。各例題は「問題 → 手計算の途中式 → 棄却限界との比較 → Rでの答え合わせ → 解釈」の順に進めます。Rの部分は読み飛ばしても試験対策として成り立ちますが、手を動かして確かめると公式の意味が一段と定着します。ここで扱うt検定やカイ二乗検定は、臨床試験の群比較でも毎日のように使われる手法ですので、試験の先の実務まで見据えて読み進めていただければと思います。
区間推定の基本 ― 母平均と母比率の信頼区間を公式から組み立てる
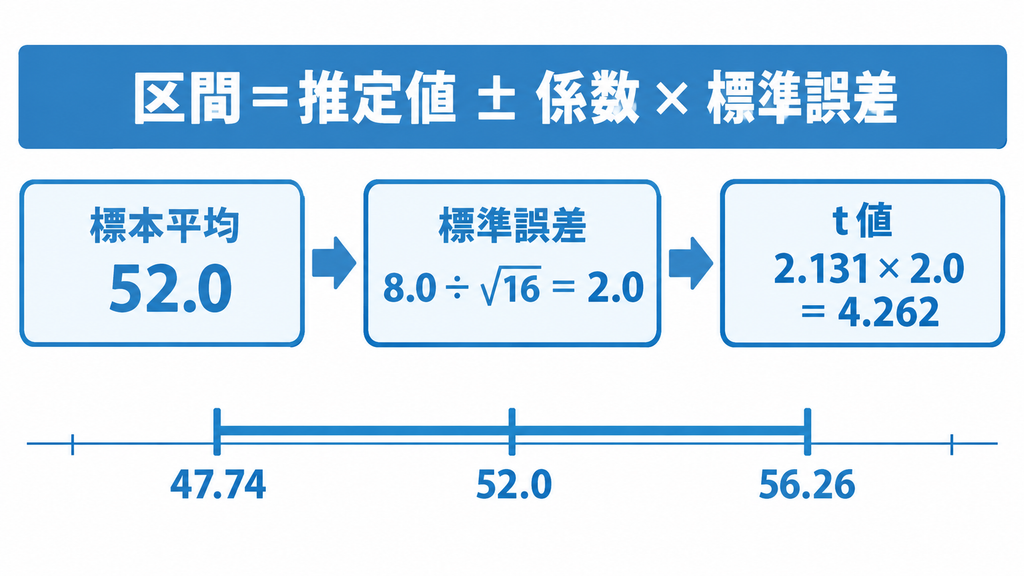
区間推定は「推定値 ± 係数 × 標準誤差」という1つの型で解けます。標準誤差があいまいな方は【やさしく解説】標準偏差(SD)と標準誤差(SE)の違いを先に確認しておくと安心です。
例題1 母平均の95%信頼区間
問題:ある錠剤16錠の有効成分量を測定したところ、標本平均52.0mg、不偏標準偏差8.0mgでした。母平均の95%信頼区間を求めてください(母集団は正規分布を仮定)。
解答:
①母分散が未知なので \(s\) を使い、自由度 \(n-1=15\) の \(t\) 分布で考えます。
②公式は次のとおりです。
\[ \bar{x}\pm t_{0.025}(n-1)\times\frac{s}{\sqrt{n}} \]
③代入:\(8.0/\sqrt{16}=2.0\)、\(t_{0.025}(15)=2.131\) より \(2.131\times2.0=4.262\)
④結論:\(52.0\pm4.262\) より、95%信頼区間は \([47.738,\ 56.262]\) です。
検算:区間の中点 \((47.738+56.262)/2=52.0\) が標本平均に一致します。
Rで答え合わせ:
# 例題1:n = 16、標本平均 52.0、不偏標準偏差 8.0 のときの母平均の95%信頼区間
n <- 16; xbar <- 52.0; s <- 8.0
t_crit <- qt(0.975, df = n - 1)   # 自由度15のt分布の上側2.5%点
half <- t_crit * s / sqrt(n)
round(c(t_crit = t_crit, lower = xbar - half, upper = xbar + half), 3)
t_crit  lower  upper
 2.131 47.737 56.263
Rは \(t\) の値を丸めずに使うため、小数第3位が1ずれます(丸めの差です)。
母平均の95%信頼区間は \([47.738,\ 56.262]\) です。本番では「σ未知なので \(z_{0.025}=1.960\) ではなく \(t_{0.025}(15)=2.131\) を使う」が分かれ目です。自由度は \(n=16\) ではなく15で表を引きます。
例題2 母比率の95%信頼区間
問題:ある薬を服用した400人中120人に副作用が出ました。副作用発現率の95%信頼区間を求めてください。
解答:
①\(n\) が大きいので正規近似を使います。
②公式は次のとおりです。
\[ \hat{p}\pm z_{0.025}\sqrt{\frac{\hat{p}(1-\hat{p})}{n}} \]
③代入:\(\hat{p}=120/400=0.30\)、\(\sqrt{0.30\times0.70/400}=0.0229\)、\(1.96\times0.0229=0.0449\)
④結論:95%信頼区間は \([0.2551,\ 0.3449]\) です。
検算:上限−下限 \(=0.0898\) が \(2\times0.0449\) に一致します。
Rで答え合わせ:
# 例題2:400人中120人に副作用が出たときの母比率の95%信頼区間(正規近似)
x <- 120; n <- 400
p_hat <- x / n
se <- sqrt(p_hat * (1 - p_hat) / n)
round(c(p_hat = p_hat, se = se,
        lower = p_hat - qnorm(0.975) * se,
        upper = p_hat + qnorm(0.975) * se), 4)
 p_hat     se  lower  upper
0.3000 0.0229 0.2551 0.3449
副作用発現率は30%、95%信頼区間は25.51%〜34.49%です。治験の安全性集計でも、発現率には区間を添えて報告します。区間推定の標準誤差には \(\hat{p}\) を使う点を覚えておきましょう。
小標本や比率が0・1に近いときは正規近似が崩れるため、二項比率の信頼区間で別の方法を確認してください。
仮説検定の考え方 ― 帰無仮説・有意水準・p値・2種類の過誤
仮説検定は「\(H_0\) が正しいと仮定すると、観測結果はどれほど珍しいか」を測る手続きです。①\(H_0\)・\(H_1\) を立てる、②有意水準 \(\alpha\) を決める、③検定統計量を計算する、④棄却限界またはp値と比較する、⑤結論を書く、の順に進めます。
片側検定なら5%の棄却限界は \(z_{0.05}=1.645\)、両側検定なら \(z_{0.025}=1.960\) です。\(z=2.05\) はどちらも超えるので \(H_0\) を棄却しますが、p値は片側0.0202、両側0.0404で、両側p値は片側の2倍になります。
# 検定統計量 z = 2.05 のときの片側p値と両側p値
z <- 2.05
round(c(one_sided = 1 - pnorm(z), two_sided = 2 * (1 - pnorm(z))), 4)
qnorm(c(0.95, 0.975))   # 片側5%・両側5%の棄却限界
one_sided two_sided
   0.0202    0.0404
[1] 1.644854 1.959964
判定の誤りは2種類あり、真実と判定の組み合わせで整理できます。
| 真実\判定 | \(H_0\) を棄却しない | \(H_0\) を棄却する |
|---|---|---|
| \(H_0\) が正しい | 正しい判断(\(1-\alpha\)) | 第1種の過誤(\(\alpha\)) |
| \(H_1\) が正しい | 第2種の過誤(\(\beta\)) | 正しい判断(検出力 \(1-\beta\)) |
臨床試験に置き換えると、第1種の過誤は「効かない薬を効くと判断する」誤り、第2種の過誤は「効く薬を見逃す」誤りです。詳しくは仮説検定の“二種類の誤り”を深く理解するで解説しています。
p値は「\(H_0\) が正しいとしたとき、観測値以上に極端な値が得られる確率」です。「\(H_0\) が正しい確率」ではありません。両側p値0.0404を「\(H_0\) が正しい確率が4%」と読むのは典型的な誤りです。
p値の誤解のパターンはp値とは何か?にまとめています。
平均の検定 ― 1標本・2標本・対応ありのt検定と等分散のF検定
母分散が未知のとき、母平均の検定にはt分布を使います。1標本t検定の検定統計量は次のとおりで、自由度は \(n-1\) です。
\[ t=\frac{\bar{x}-\mu_0}{s/\sqrt{n}} \]
分母の \(s/\sqrt{n}\) は標準誤差です(【やさしく解説】標準偏差(SD)と標準誤差(SE)の違い)。t分布が現れる理由はt検定の数理的導出とRによる実装例で詳しく扱っています。
例題3 2標本t検定と等分散のF検定
問題:新薬A群10人・対照B群10人の検査値の低下量を測定しました。A群は平均24.5・不偏標準偏差4.0、B群は平均20.5・不偏標準偏差3.0です。(1)有意水準5%(両側)で等分散のF検定を行ってください。(2)等分散を仮定した2標本t検定を有意水準5%(両側)で行ってください。
解答(1)
- 仮説:\(H_0:\sigma_A^2=\sigma_B^2\)、\(H_1:\sigma_A^2\neq\sigma_B^2\)
- 公式と代入:\(F=s_A^2/s_B^2=4.0^2/3.0^2=16/9=1.778\)
- 比較と結論:\(1.778<F_{0.025}(9,9)=4.026\) なので、\(H_0\) を棄却しません。
解答(2)
- 仮説:\(H_0:\mu_A=\mu_B\)、\(H_1:\mu_A\neq\mu_B\)
- 公式:プールした分散 \(s_p^2\) を使います。
\[ s_p^2=\frac{(n_A-1)s_A^2+(n_B-1)s_B^2}{n_A+n_B-2},\quad t=\frac{\bar{x}_A-\bar{x}_B}{\sqrt{s_p^2\left(\frac{1}{n_A}+\frac{1}{n_B}\right)}} \]
- 代入:\(s_p^2=(9\times16+9\times9)/18=225/18=12.5\)、標準誤差 \(\sqrt{12.5\times(1/10+1/10)}=\sqrt{2.5}=1.581\)、\(t=4.0/1.581=2.530\)
- 比較:\(2.530>t_{0.025}(18)=2.101\)
- 結論:\(H_0\) を棄却します(p値は0.021)。
検算:両群の自由度が等しいので、\(s_p^2\) は分散16と9の単純平均 \((16+9)/2=12.5\) に一致します。
Rで答え合わせ
# 例題3:A群 n=10・平均24.5・SD4.0 / B群 n=10・平均20.5・SD3.0
n1 <- 10; m1 <- 24.5; s1 <- 4.0
n2 <- 10; m2 <- 20.5; s2 <- 3.0
F_stat <- s1^2 / s2^2                 # 等分散のF検定
F_crit <- qf(0.975, n1 - 1, n2 - 1)
sp2 <- ((n1 - 1) * s1^2 + (n2 - 1) * s2^2) / (n1 + n2 - 2)   # プールした分散
t_stat <- (m1 - m2) / sqrt(sp2 * (1 / n1 + 1 / n2))
df <- n1 + n2 - 2
round(c(F = F_stat, F_crit = F_crit, sp2 = sp2, t = t_stat,
        t_crit = qt(0.975, df), p = 2 * (1 - pt(abs(t_stat), df))), 4)
      F  F_crit     sp2       t  t_crit       p
 1.7778  4.0260 12.5000  2.5298  2.1009  0.0210
F = 1.7778 は棄却限界 4.0260 を下回り、等分散は棄却されません。t = 2.5298 は 2.1009 を上回り、p = 0.0210 で5%有意です。手計算の2.530はこの値の丸めです。本番では、大きいほうの分散を分子に置いて上側2.5%点と比べると迷いません。
等分散を仮定しない場合は、Welchのt検定(自由度をWelch–Satterthwaiteの近似で求める)を使います。臨床試験の群比較などの実務では、等分散の事前検定を挟まずにWelchを既定とすることが多いです。
なお、1標本の母分散の検定には \(\chi^2=(n-1)s^2/\sigma_0^2\)(自由度 \(n-1\))を用います。
例題4 対応のあるt検定
問題:降圧薬を投与した8人の投与前後の収縮期血圧(mmHg)です。有意水準5%(両側)で投与前後に差があるか検定してください。
| 被験者 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 投与前 | 150 | 142 | 158 | 147 | 139 | 155 | 144 | 149 |
| 投与後 | 146 | 141 | 152 | 144 | 139 | 150 | 142 | 146 |
| 差(前−後) | 4 | 1 | 6 | 3 | 0 | 5 | 2 | 3 |
解答:対応のあるデータは、差 \(d\) をとれば「差の1標本t検定」になります。
- 仮説:\(H_0:\mu_d=0\)、\(H_1:\mu_d\neq0\)
- 公式:\(t=\bar{d}/(s_d/\sqrt{n})\)、自由度 \(n-1=7\)
- 代入:\(\bar{d}=24/8=3.0\)。偏差 \(1,-2,3,0,-3,2,-1,0\) の平方和は28なので \(s_d^2=28/7=4.0\)、\(s_d=2.0\)。\(t=3.0/(2.0/\sqrt{8})=3.0/0.7071=4.243\)
- 比較:\(4.243>t_{0.025}(7)=2.365\)
- 結論:\(H_0\) を棄却します。95%信頼区間は \(3.0\pm2.365\times0.7071=[1.328,\ 4.672]\) です。
検算:偏差の合計 \(1-2+3+0-3+2-1+0=0\) となり、平均3.0の計算は正しいと確認できます。
Rで答え合わせ
# 例題4:8人の降圧薬投与前後の収縮期血圧(mmHg)
before <- c(150, 142, 158, 147, 139, 155, 144, 149)
after  <- c(146, 141, 152, 144, 139, 150, 142, 146)
d <- before - after
round(c(mean_d = mean(d), sd_d = sd(d), t_crit = qt(0.975, df = 7)), 3)
t.test(before, after, paired = TRUE)
mean_d   sd_d t_crit
 3.000  2.000  2.365

	Paired t-test

data:  before and after
t = 4.2426, df = 7, p-value = 0.003828
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 1.327958 4.672042
sample estimates:
mean difference
              3
t = 4.2426、p-value = 0.003828 で、投与前後の差は5%有意です。95%信頼区間 1.327958〜4.672042 が0を含まないことも結論と整合します。差の分布の正規性に不安があるときの代替法は対応のあるt検定とウィルコクソン符号順位検定を参照してください。
同じデータを誤って2標本t検定で扱うと、投与前後に共通する個人差が誤差に混ざって標準誤差が大きくなり、検出力が落ちます。「同じ人を2回測った」データかどうかを最初に確認しましょう。
カテゴリデータの検定 ― 独立性の検定・適合度検定・母比率の検定
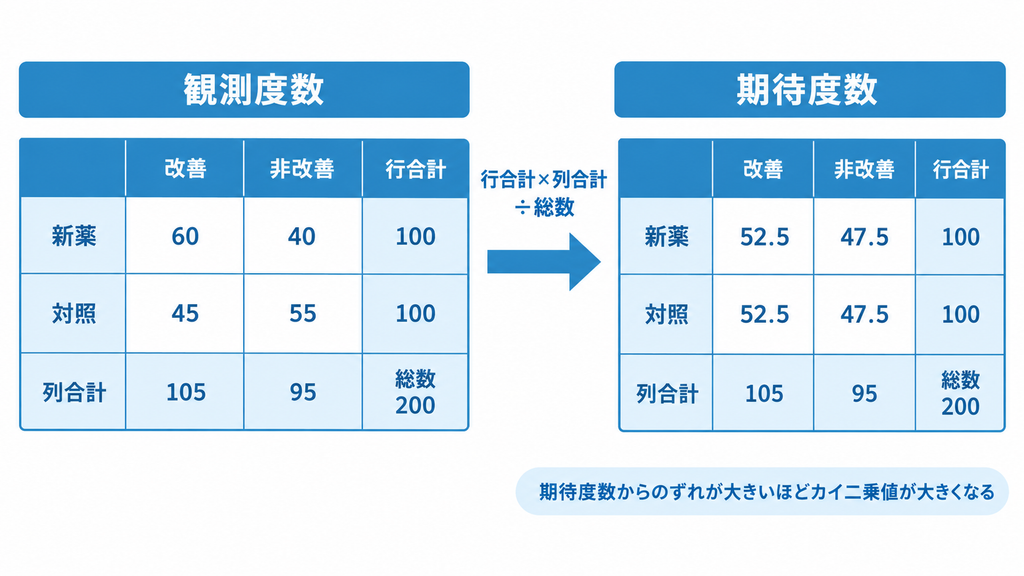
有効率など人数を数えるデータの検定です。本番では期待度数と自由度を電卓で素早く出せるかが勝負です。
例題5 独立性の検定(2×2分割表)
問題:新薬群・対照群各100人の改善/非改善です。有意水準5%で、治療と改善が独立か検定してください。
| 群 | 改善 | 非改善 |
|---|---|---|
| 新薬 | 60 | 40 |
| 対照 | 45 | 55 |
解答
①\(H_0\):治療と改善は独立、\(H_1\):独立でない
②期待度数=行合計×列合計÷総数。列合計は改善105・非改善95、総数200なので、両群とも改善 \(100\times105/200=52.5\)、非改善 \(47.5\) です。
③
\[ \chi^2=\frac{(60-52.5)^2}{52.5}+\frac{(40-47.5)^2}{47.5}+\frac{(45-52.5)^2}{52.5}+\frac{(55-47.5)^2}{47.5}=4.511 \]
④自由度 \((2-1)(2-1)=1\)、\(4.511>\chi^2_{0.05}(1)=3.841\)
⑤\(H_0\)(独立)を棄却します。
検算:期待度数の合計200が総数と一致します。
Rで答え合わせ
# 例題5:新薬群と対照群の改善・非改善(2×2分割表)
tab <- matrix(c(60, 40, 45, 55), nrow = 2, byrow = TRUE,
              dimnames = list(群 = c("新薬", "対照"), 結果 = c("改善", "非改善")))
res <- chisq.test(tab, correct = FALSE)
res$expected
res
chisq.test(tab)   # Rの既定はイェーツの連続性補正あり
qchisq(0.95, df = 1)
      結果
群    改善 非改善
  新薬 52.5   47.5
  対照 52.5   47.5

	Pearson's Chi-squared test

data:  tab
X-squared = 4.5113, df = 1, p-value = 0.03367


	Pearson's Chi-squared test with Yates' continuity correction

data:  tab
X-squared = 3.9298, df = 1, p-value = 0.04744

[1] 3.841459
chisq.test() は2×2表で既定がイェーツの補正あり(X-squared = 3.9298)です。手計算(4.511)と合わせるには correct = FALSE を付けます。境界付近では結論が変わりえます。期待度数5未満のセルがあればFisherの正確検定を検討します。
例題6 適合度検定
問題:交配実験で4つの表現型が 95, 28, 27, 10(計160)観測されました。理論比9:3:3:1に適合するか、有意水準5%で検定してください。
解答
①\(H_0\):理論比に従う、\(H_1\):従わない
②③期待度数は \(160\times9/16=90\)、\(30\)、\(30\)、\(10\) です。
\[ \chi^2=\sum\frac{(O-E)^2}{E}=\frac{25}{90}+\frac{4}{30}+\frac{9}{30}+\frac{0}{10}=0.711 \]
④自由度 \(4-1=3\)、\(0.711<\chi^2_{0.05}(3)=7.815\)
⑤\(H_0\) を棄却しません。
検算:期待度数の合計160が観測度数の合計と一致します。
Rで答え合わせ
# 例題6:観測度数がメンデルの法則(9:3:3:1)に従うか
obs <- c(95, 28, 27, 10)
chisq.test(obs, p = c(9, 3, 3, 1) / 16)
qchisq(0.95, df = 3)
	Chi-squared test for given probabilities

data:  obs
X-squared = 0.71111, df = 3, p-value = 0.8706

[1] 7.814728
例題7 母比率の検定
問題:従来治療の有効率は60%です。新しい治療を100人に行ったところ70人が有効でした。有意水準5%(両側)で、有効率が60%と異なるか検定してください。
解答
①\(H_0:p=0.60\)、\(H_1:p\neq0.60\)
②③
\[ z=\frac{\hat{p}-p_0}{\sqrt{p_0(1-p_0)/n}}=\frac{0.70-0.60}{\sqrt{0.60\times0.40/100}}=\frac{0.10}{0.04899}=2.041 \]
④\(2.041>z_{0.025}=1.960\)
⑤\(H_0\) を棄却します。
検算:\(z^2=2.041^2=4.167\) がRの X-squared = 4.1667 と一致します。
Rで答え合わせ
# 例題7:従来の有効率60%に対し、新しい治療では100人中70人が有効
x <- 70; n <- 100; p0 <- 0.6
z <- (x / n - p0) / sqrt(p0 * (1 - p0) / n)
round(c(z = z, p = 2 * (1 - pnorm(abs(z)))), 4)
prop.test(x, n, p = p0, correct = FALSE)
     z      p
2.0412 0.0412

	1-sample proportions test without continuity correction

data:  x out of n, null probability p0
X-squared = 4.1667, df = 1, p-value = 0.04123
alternative hypothesis: true p is not equal to 0.6
95 percent confidence interval:
 0.6041515 0.7810511
sample estimates:
  p
0.7
p値0.0412で、有効率は60%と異なるといえます。
分母は \(H_0\) の下の \(p_0=0.60\) です(信頼区間では \(\hat{p}\))。典型的な引っかけです。
correct = FALSE としたときの prop.test() の信頼区間はWilson法(スコア法)で、例題2の正規近似の区間とは別物です(二項比率の信頼区間)。試験本番で差がつくポイント ― 検定の選び方と典型的な間違い
本番では、問題文から「何を知りたいか」と「データの形」を読み取り、使う統計量と分布を即座に決めることが得点に直結します。
| 知りたいこと | データ | 検定統計量 | 分布と自由度 |
|---|---|---|---|
| 母平均(σ既知) | 1標本の量的データ | \(z=(\bar{x}-\mu_0)/(\sigma/\sqrt{n})\) | 標準正規分布 |
| 母平均(σ未知) | 1標本の量的データ | \(t=(\bar{x}-\mu_0)/(s/\sqrt{n})\) | \(t(n-1)\) |
| 2標本の平均(等分散) | 独立な2群 | プールした分散 \(s_p^2\) を使うt | \(t(n_A+n_B-2)\) |
| 対応のある平均 | 同じ人の前後など | 差 \(d\) の1標本t | \(t(n-1)\)(\(n\) はペア数) |
| 母分散 | 1標本の量的データ | \(\chi^2=(n-1)s^2/\sigma_0^2\) | \(\chi^2(n-1)\) |
| 2標本の分散比 | 独立な2群 | \(F=s_A^2/s_B^2\) | \(F(n_A-1,n_B-1)\) |
| 母比率 | 2値データ | \(z=(\hat{p}-p_0)/\sqrt{p_0(1-p_0)/n}\) | 標準正規分布 |
| 適合度 | \(k\) 区分の度数 | \(\chi^2=\sum(O-E)^2/E\) | \(\chi^2(k-1)\) |
| 独立性 | \(r\times c\) 分割表 | \(\chi^2=\sum(O-E)^2/E\) | \(\chi^2((r-1)(c-1))\) |
- 両側と片側の取り違え:有意水準5%の棄却限界は両側1.960、片側1.645です。「異なるか」なら両側です。
- 比率の検定の分母に \(\hat{p}\) を使う:検定では例題7のように \(p_0=0.60\) を使い、\(\hat{p}\) は信頼区間で使います。
- 自由度の数え間違い:等分散の2標本は \(10+10-2=18\)、対応ありはペア数8から1を引いて7です。
- 対応のあるデータを2標本扱い:例題4は差をとって1標本t検定にします。
- 「棄却しない=\(H_0\) が正しい」と読む:例題3のF検定は等分散を証明したわけではありません(p値とは何か?)。
📚 この記事をより深く理解するための参考書籍
推定と検定は「公式テキストで範囲を押さえる」「過去の出題形式で手を慣らす」「理論の土台を固める」の3段階で学ぶと定着します。その3段階に対応する書籍を1冊ずつ選びました。


解答も丁寧に記載されているので、分からない問題が出てきても、理解することができるかと思います。

関連記事・次のステップ
2級の学習全体の進め方は統計検定2級の勉強法で、そもそも資格を取る価値については統計検定を受験する意味って?で紹介しています。
p値や信頼区間の理解をもう一段深めたい方は、p値とは何か?、信頼区間とp値の関係を図解で理解する、仮説検定の“二種類の誤り”を深く理解するへ進んでください。t分布が出てくる理由は標本分布を理解しようと中心極限定理とはが土台になります。
個々の検定を掘り下げるなら、t検定の数理的導出とRによる実装例、分割表の独立性の検定、適合度検定の基礎と応用、二項比率の信頼区間がそれぞれ本記事の直接の続きです。2級の先を目指す方は統計検定準1級 攻略ガイドもどうぞ。
まとめ
本記事では、統計検定2級の推定・検定分野を、本番で出そうな例題7問を通して整理しました。
区間推定では、母平均の区間は分散が未知ならt分布を使い、16錠・平均52.0・標準偏差8.0の例で \(t_{0.025}(15)=2.131\) から \([47.738,\ 56.262]\) を求めました。母比率の区間は標本比率 \(\hat{p}\) で標準誤差を作り、400人中120人の副作用で \([0.2551,\ 0.3449]\) となりました。仮説検定では、p値が「帰無仮説が正しい確率」ではないこと、片側と両側で棄却限界が1.645と1.960に分かれることを確認しました。
平均の検定では、2標本t検定で \(t=2.530>2.101\)、対応のあるt検定で \(t=4.243>2.365\) となり、どちらも帰無仮説を棄却しました。カテゴリデータでは、母比率の検定の分母に \(p_0\) を使うこと(\(z=2.041\))、独立性の検定の期待度数の出し方(\(\chi^2=4.511\))、適合度検定で棄却しないことの意味(\(\chi^2=0.711\))を押さえました。Rの chisq.test() が2×2表で既定ではイェーツの補正を行う点は、試験の手計算と答え合わせをするときの落とし穴です。
本番で大切なのは、計算の速さよりも「データの形から検定を選び、自由度と片側・両側を正しく決める」判断です。この判断は臨床試験の統計解析でもそのまま求められる基本動作ですので、本記事の検定選択表を手元に置き、公式問題集で繰り返し確かめていただければと思います。
次の一歩としては、学習計画を立て直すための統計検定2級の勉強法、検定と区間推定の対応を図で整理した信頼区間とp値の関係を図解で理解する、カイ二乗検定の理論を掘り下げた分割表の独立性の検定をあわせてご覧いただくと、推定と検定の理解が確かなものになり、合格への大きな強みになります。