多重比較法をRで実装する ― Bonferroni・Holm・Hochberg・Dunnettから閉検定手順・グラフィカルアプローチまでFWERをシミュレーションで確かめる ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- 検定を繰り返すと偽陽性がどれだけ膨らむのか(FWERの考え方)
p.adjust()によるBonferroni・Holm・Hochberg・Hommelの調整と、mvtnormによるDunnett法の実装- 閉検定手順とグラフィカルアプローチを自作関数で動かし、αが仮説から仮説へ渡る様子を確かめる方法
- FWERと検出力を1万回のシミュレーションで比べた結果
- 手法の選び方と、統計解析計画書(SAP)への書き方
はじめに
プラセボに対して低用量・中用量・高用量の3群を比べる第II相試験を考えます。3つの比較をそれぞれ有意水準5%で検定すると、どの用量にも効果がなかったとしても、「どれか1つが偶然有意になる」確率は5%では収まりません。主要評価項目と副次評価項目が複数ある検証的試験になると、問題はさらに大きくなります。
この「多重性(multiplicity)」への対処として、Bonferroni法やHolm法といった名前は多くの方がご存じだと思います。しかし実務で手が止まるのは、その先です。Holm法とHochberg法は何が違うのか、Dunnett法はなぜBonferroni法より有利なのか、SAPに書かれたグラフィカルアプローチの図は実際にどう動くのか。名前と公式を知っているだけでは、こうした問いには答えにくいはずです。
本記事では、多重比較法をbase Rと mvtnorm パッケージだけで実装しながら整理します。調整p値の計算から始め、閉検定手順とグラフィカルアプローチは専用パッケージに頼らず、アルゴリズムそのものを短い関数で書いて動かします。最後に、FWER(ファミリーワイズエラー率)と検出力を1万回のシミュレーションで比べ、「どの方法が本当に第一種の過誤を守り、どれだけ検出力を失うのか」を数値で確かめます。
想定読者は、SAPで多重性の調整を書く製薬企業・CROの生物統計家、臨床試験の結果を読み解く立場の方、そして統計検定準1級の受験者です。多重性の問題そのものを図で確認したい方は 多重比較法の基礎と活用〜多重性の問題と代表的手法を図解で理解する〜 を、SAP全体の構成を知りたい方は 統計解析計画書(SAP)の書き方 をあわせてご覧ください。
多重性の問題とFWER ― なぜp値の調整が必要なのか
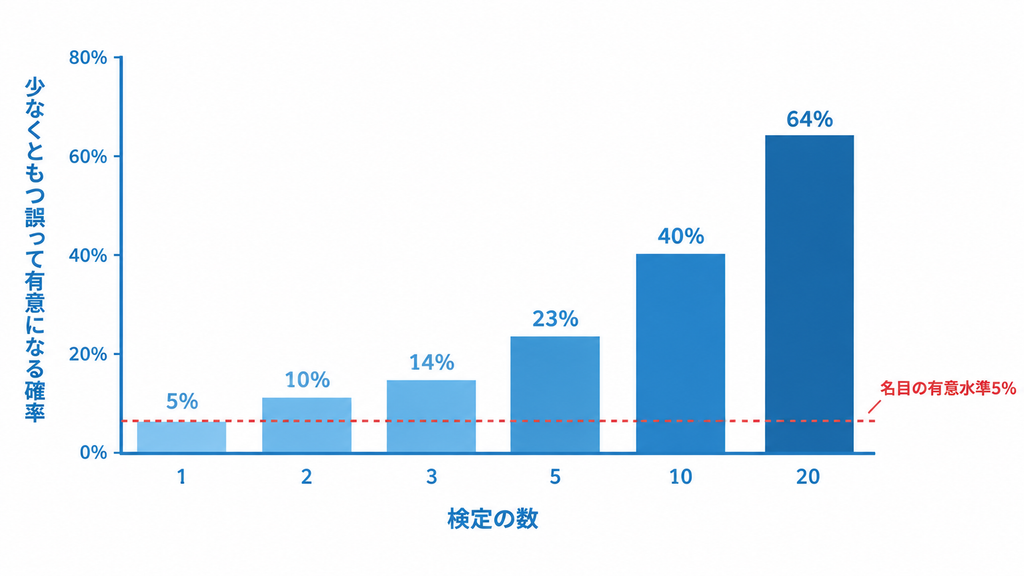
冒頭の3用量の例で、3回のt検定をそれぞれ有意水準5%で行うと、「どれか1つが偶然有意になる」確率は5%に収まりません。これが多重性の問題です。
この確率を FWER(ファミリーワイズエラー率) と呼びます。まとめて結論を出す検定の集まり(family)の中で、真の帰無仮説を1つ以上誤って棄却する確率です。m個の検定が互いに独立で、すべての帰無仮説が真なら、次の式で表せます。
\[ \mathrm{FWER}=1-(1-\alpha)^m \]
検定の数を増やしながらRで計算してみます。
# 検定の数 m を増やすと「少なくとも1つ誤って有意になる確率」はどう増えるか
m <- c(1, 2, 3, 5, 10, 20)
data.frame(m = m, FWER = round(1 - (1 - 0.05)^m, 4))
   m   FWER
1  1 0.0500
2  2 0.0975
3  3 0.1426
4  5 0.2262
5 10 0.4013
6 20 0.6415
検定が3つでFWERは0.1426、10個で0.4013、20個では0.6415に達します。1つひとつを5%で検定しても、family全体では3用量の比較だけで約7回に1回、誤った「有意差あり」を報告することになります。
なお、この式は独立を仮定した場合の値です。共通のプラセボ群と比べる用量比較どうしには相関があるため、実際のFWERはこれより小さくなります(後半のシミュレーションで確かめます)。
FWERの制御の強さと手法の型
調整法は「どの状況でFWERを守るか」と「どう段階的に判定するか」で整理できます。強い意味での制御(strong control) は、どの帰無仮説の組み合わせが真であってもFWER≦αを保証します。弱い意味での制御(weak control) は、全帰無仮説が真のときだけの保証です。検証的試験で用量ごとに効果を主張するには、強い制御が求められます。
判定の進め方は3つの型に分かれます。シングルステップ法はすべてのp値に同じ閾値を当てます。ステップダウン法は最小のp値から順に判定し、棄却できなかった時点で止めます。ステップアップ法は最大のp値から判定し、棄却できた時点で残りをすべて棄却します。下表の手法は、前提が満たされればいずれも強い意味でFWERを制御します。
| 手法 | 型 | 前提 | 特徴 |
|---|---|---|---|
| Bonferroni | シングルステップ法 | 特になし | 最も単純。検定数が多いと保守的 |
| Holm (1979) | ステップダウン法 | 特になし | Bonferroniと同等以上に棄却しやすい |
| Hochberg (1988) | ステップアップ法 | 独立または正の相関 | Holmと同等以上に棄却しやすい |
| Hommel | 閉検定手順(局所検定にSimes検定) | 独立または正の相関 | Hochbergと同等以上に強力。計算はやや複雑 |
| Dunnett (1955) | シングルステップ法 | 正規分布・等分散 | 対照群との多対1比較に特化し、比較間の相関を利用 |
p.adjust()とDunnett法で3用量のp値を調整する
ここからは仮想の用量反応試験データで、実際にp値を調整します。まずプラセボ+3用量(各群30例)のデータを作り、プラセボを基準にした線形モデルで各用量の効果を推定します。係数の検定は、4群のプール分散を使ったt検定と同じ形です。t検定の導出はt検定の数理的導出とRによる実装例、群間比較のモデルの考え方は一元配置分散分析(One-way ANOVA)の数理的導入とRによる実装で解説しています。
# 共通セットアップ:プラセボ+3用量(低・中・高)の並行群間試験、各群30例
set.seed(2026)
n   <- 30
mu  <- c(Placebo = 0, Low = 2, Mid = 4, High = 5)   # 真の改善量
sd0 <- 8
grp <- factor(rep(names(mu), each = n), levels = names(mu))
y   <- rnorm(4 * n, mean = rep(mu, each = n), sd = sd0)
dat <- data.frame(grp, y)

# プラセボを基準にした線形モデル(各用量 vs プラセボの t 検定になる)
fit   <- lm(y ~ grp, data = dat)
est   <- coef(summary(fit))[-1, ]
p_raw <- est[, "Pr(>|t|)"]
round(est, 4)
        Estimate Std. Error t value Pr(>|t|)
grpLow    1.3964     2.1179  0.6593   0.5110
grpMid    4.8529     2.1179  2.2914   0.0237
grpHigh   3.7487     2.1179  1.7700   0.0794
無調整では中用量(grpMid)だけがp=0.0237で5%を下回ります。高用量はp=0.0794、低用量はp=0.5110です。
真の改善量は高用量(5)が最大なのに、推定値は中用量の4.8529が高用量の3.7487を上回っています。1回の試験の推定値はこれだけ揺れる、という点も覚えておきましょう。
p.adjust()によるBonferroni・Holm・Hochberg
p値を小さい順に \(p_{(1)}\le p_{(2)}\le\cdots\le p_{(m)}\) と並べると、各手法の調整p値は次のように計算されます。
\[ \text{Bonferroni:}\quad \tilde{p}_i=\min\bigl(1,\;m\,p_i\bigr) \]
\[ \text{Holm:}\quad \tilde{p}_{(i)}=\max_{j\le i}\,\min\bigl(1,\;(m-j+1)\,p_{(j)}\bigr) \]
\[ \text{Hochberg:}\quad \tilde{p}_{(i)}=\min_{j\ge i}\,\min\bigl(1,\;(m-j+1)\,p_{(j)}\bigr) \]
Holmは閾値を \(\alpha/m,\ \alpha/(m-1),\ \ldots\) と段階的に緩め、Hochbergは同じ閾値を大きいp値の側から当てはめます。調整p値は「その値≦αなら、その手順で棄却される」値として読めます。先ほど作った p_raw を p.adjust() に渡し、一括で比べます。
# 代表的な p 値の調整法を一括で比較する
methods <- c("none", "bonferroni", "holm", "hochberg", "hommel")
round(sapply(methods, function(m) p.adjust(p_raw, method = m)), 4)
          none bonferroni   holm hochberg hommel
grpLow  0.5110     1.0000 0.5110   0.5110 0.5110
grpMid  0.0237     0.0712 0.0712   0.0712 0.0712
grpHigh 0.0794     0.2381 0.1587   0.1587 0.1587
どの調整法でも、中用量の調整p値は0.0712となり5%を超えます。無調整なら「中用量で有意」と言えたところが、3用量の比較を1つのfamilyとして扱うと有意とは言えなくなります。
高用量はBonferroniの0.2381に対し、Holm以降では0.1587に下がります。最小のp値を判定した後は残りの検定数で割ればよい、というステップワイズ法の利点が数値に表れています。
調整後の0.0712は「効果がない」ことを示すわけではありません。p値の読み方の基本はp値とは何か?で確認できます。
Dunnett法で比較間の相関を使う
Bonferroni系の方法は比較どうしの相関を使いません。しかしプラセボ群を共通の対照にする多対1比較では、各群同数なら比較間の相関は0.5と決まっています。Dunnett法はこの相関を多変量t分布に組み込み、必要以上に保守的になるのを防ぎます。先ほど作った est と fit を使い、mvtnorm で調整p値と棄却限界値を求めます。
# Dunnett 法:対照群との比較どうしの相関(各群同数なら 0.5)を考慮する
library(mvtnorm)
t_obs <- est[, "t value"]
df    <- fit$df.residual
R     <- matrix(0.5, 3, 3); diag(R) <- 1

set.seed(1)
p_dunnett <- sapply(abs(t_obs), function(t)
  1 - pmvt(lower = rep(-t, 3), upper = rep(t, 3), df = df, corr = R)[1])
round(p_dunnett, 4)

# 両側 5% の棄却限界値を比べる
set.seed(1)
c(none       = qt(0.975, df),
  bonferroni = qt(1 - 0.025 / 3, df),
  dunnett    = qmvt(0.95, tail = "both.tails", df = df, corr = R)$quantile)
 grpLow  grpMid grpHigh
 0.8483  0.0620  0.1911
      none bonferroni    dunnett
  1.980626   2.429194   2.379948
中用量の調整p値は、Bonferroniの0.0712に対してDunnett法では0.0620と小さくなります(今回はそれでも5%を超えます)。
両側5%の棄却限界値も、Bonferroniの2.429からDunnettの2.380へ下がります。相関を使う分だけハードルが下がり、同じFWERを守りながら保守性を小さくできるわけです。
pmvt() と qmvt() は数値積分に乱数を使うため set.seed() を置いています。小数第4位程度は実行ごとに揺れることがあります。データを見てから調整法を選ぶのは禁じ手です。今回の結果を見比べて最も有利な方法を採用すると、それ自体が新たな多重性を生み、FWERは守られません。
調整法・familyの範囲・αの配分は、試験開始前に統計解析計画書(SAP)で固定しておきます。また、Hochbergは独立または正の相関が前提なので、前提が疑わしい場面ではHolmを選ぶのが安全です。
閉検定手順とグラフィカルアプローチをRで実装する
Holm法やHochberg法は「p値を小さい順に並べて…」という手順として覚えがちですが、その背後には閉検定手順という一般原理があります。さらにその原理を「αの受け渡しの地図」として設計できるのがグラフィカルアプローチです。ここでは両者を自作関数で動かし、計算がどう進むかを確かめます。概念の図解はグラフィカルアプローチの魅力と実践にまとめているので、本節では実装に絞ります。
閉検定手順 ― Holm法の正体
Marcus, Peritz & Gabriel(1976)の閉検定手順は、次の3段階で進みます。
- 仮説 H1・H2・H3 から作れるすべての交差仮説 \(H_I=\bigcap_{i\in I}H_i\)(H1&H2、H1&H2&H3 など計7個)を用意する
- 各交差仮説を、有意水準αの局所検定で検定する
- \(H_i\) を含む交差仮説がすべて棄却されたときだけ、\(H_i\) を棄却する
なぜこれでFWERが強い意味で守られるのでしょうか。真の帰無仮説の集まりを \(T\) とすると、それらの交差仮説 \(H_T\) も必ず局所検定にかけられます。真の仮説を1つでも誤って棄却するには \(H_T\) の棄却が前提になるので、誤棄却の確率は \(H_T\) の局所検定の第一種の過誤=α以下に収まります。どの組み合わせが真でも同じ議論が成り立つ、というのがポイントです。
局所検定に「\(\min_{i\in I} p_i \le \alpha/|I|\) なら棄却」というBonferroni検定を使って実装します。ここでは両側α=0.05とし、仕組みが見えやすいように説明用のp値 p_demo を置きます(先ほどの3用量データとは別の値です)。
# 閉検定手順:すべての交差仮説を局所検定し、H_i を含む交差仮説がすべて棄却されたら H_i を棄却
closed_test <- function(p, alpha = 0.05) {
  m <- length(p)
  subsets <- unlist(lapply(1:m, function(k) combn(m, k, simplify = FALSE)),
                    recursive = FALSE)
  # 局所検定は Bonferroni:min(p_I) <= alpha / |I| なら交差仮説 H_I を棄却
  rej_I <- sapply(subsets, function(I) min(p[I]) <= alpha / length(I))
  print(data.frame(
    I         = sapply(subsets, function(I) paste0("H", I, collapse = "&")),
    min_p     = sapply(subsets, function(I) min(p[I])),
    threshold = round(sapply(subsets, function(I) alpha / length(I)), 4),
    reject    = rej_I))
  sapply(1:m, function(i) all(rej_I[sapply(subsets, function(I) i %in% I)]))
}

p_demo <- c(H1 = 0.012, H2 = 0.030, H3 = 0.045)
closed_test(p_demo)
p.adjust(p_demo, method = "holm") <= 0.05
p.adjust(p_demo, method = "hochberg") <= 0.05
         I min_p threshold reject
1       H1 0.012    0.0500   TRUE
2       H2 0.030    0.0500   TRUE
3       H3 0.045    0.0500   TRUE
4    H1&H2 0.012    0.0250   TRUE
5    H1&H3 0.012    0.0250   TRUE
6    H2&H3 0.030    0.0250  FALSE
7 H1&H2&H3 0.012    0.0167   TRUE
[1]  TRUE FALSE FALSE
   H1    H2    H3
 TRUE FALSE FALSE
  H1   H2   H3
TRUE TRUE TRUE
- 6行目の
H2&H3は min p=0.030 が閾値0.025を超えて棄却できません。この交差仮説を含むH2もH3も棄却されず、棄却はH1だけです。 - この結果は
p.adjust(method = "holm")と完全に一致します。局所検定をBonferroniにした閉検定=Holm法です(Holm, 1979)。 - 一方Hochberg法(1988)は、最大のp値0.045≦0.05を見て3つとも棄却します。大きい方から判定するステップアップ法で検出力は高い反面、検定統計量が独立または正の相関をもつという前提が必要です。
グラフィカルアプローチ ― αを渡す地図
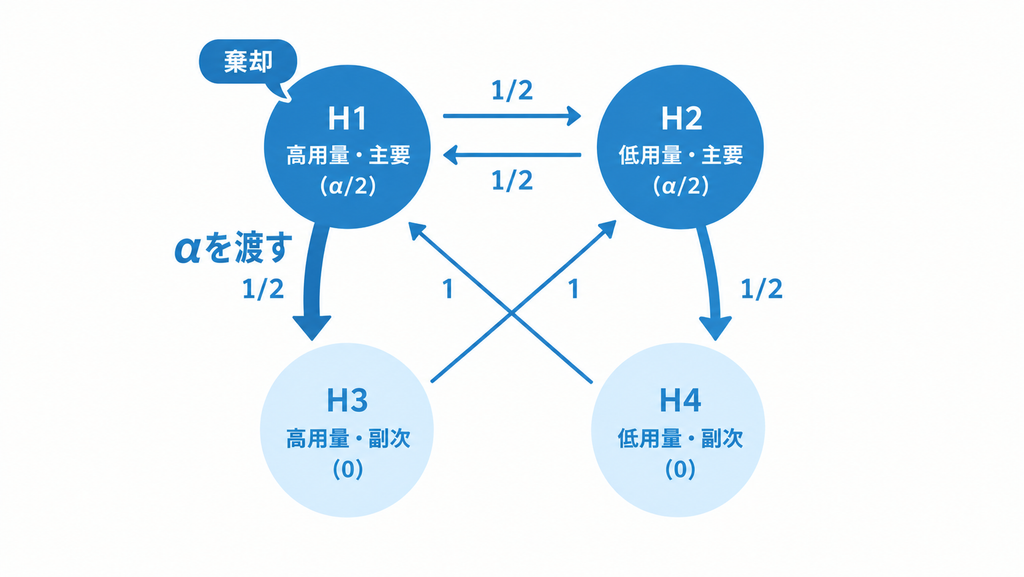
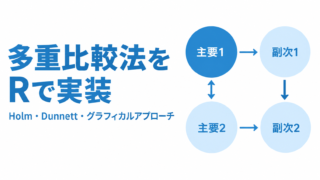
Bretz et al.(2009)のグラフィカルアプローチでは、仮説をノードとし、ノードの重み \(w_i\)=最初に割り当てるαの割合、辺の重み \(g_{ij}\)=棄却後にαを渡す割合、で試験デザインを描きます。\(p_j \le w_j\alpha\) を満たす仮説 \(H_j\) を棄却したら、残る仮説 \(l, k\) について重みとグラフを次のように更新し、また判定に戻ります。
\[ w_l \leftarrow w_l+w_j g_{jl}, \qquad g_{lk} \leftarrow \dfrac{g_{lk}+g_{lj} g_{jk}}{1-g_{lj} g_{jl}} \]
辺の更新式は「\(H_j\) を経由していた経路を直結し、\(l\) と \(j\) の往復ぶんを正規化する」操作です。
例として、主要評価項目と副次評価項目それぞれで高用量・低用量を検定する試験を考えます。検証的試験を想定し、ここだけは片側α=0.025です(閉検定の例は両側0.05でした)。
| 仮説 | 内容 | 初期重み | 棄却時にαを渡す先 |
|---|---|---|---|
| H1 | 高用量・主要 | 0.5 | H2へ0.5、H3へ0.5 |
| H2 | 低用量・主要 | 0.5 | H1へ0.5、H4へ0.5 |
| H3 | 高用量・副次 | 0 | H2へ1(もう一方の主要へ戻す) |
| H4 | 低用量・副次 | 0 | H1へ1(もう一方の主要へ戻す) |
副次は同じ用量の主要が棄却されるまで重み0のまま、という「主要→副次」の門番構造になっています。こうした型(Serial・Parallelなど)の整理はGatekeeping法とはやGatekeeping法の概要と実務的活用に譲り、ここでは更新のアルゴリズムをそのまま関数にします。
# グラフィカルアプローチ(Bretz et al., 2009 のアルゴリズム)
graph_test <- function(p, w, G, alpha = 0.025) {
  m <- length(p); h <- names(p)
  active <- rep(TRUE, m); rejected <- rep(FALSE, m); step <- 0
  repeat {
    cand <- which(active & p <= w * alpha)
    if (length(cand) == 0) break
    j <- cand[1]
    step <- step + 1
    cat(sprintf("Step %d: reject %s (p = %.4f <= %.4f)\n", step, h[j], p[j], w[j] * alpha))
    rejected[j] <- TRUE; active[j] <- FALSE
    w_new <- w; G_new <- G
    for (l in which(active)) {
      w_new[l] <- w[l] + w[j] * G[j, l]
      for (k in which(active)) {
        den <- 1 - G[l, j] * G[j, l]
        G_new[l, k] <- if (l == k || den <= 0) 0 else (G[l, k] + G[l, j] * G[j, k]) / den
      }
    }
    w_new[j] <- 0; G_new[j, ] <- 0; G_new[, j] <- 0
    w <- w_new; G <- G_new
    cat("        weights:", paste(sprintf("%s=%.3f", h, w), collapse = "  "), "\n")
  }
  rejected
}

# H1:高用量・主要  H2:低用量・主要  H3:高用量・副次  H4:低用量・副次
w <- c(0.5, 0.5, 0, 0)
G <- rbind(c(0,   0.5, 0.5, 0  ),
           c(0.5, 0,   0,   0.5),
           c(0,   1,   0,   0  ),
           c(1,   0,   0,   0  ))
p_ep <- c(H1 = 0.004, H2 = 0.018, H3 = 0.009, H4 = 0.030)
graph_test(p_ep, w, G)

# 比較:4仮説すべてに Bonferroni(片側 0.025/4)を使った場合
p_ep <= 0.025 / 4
Step 1: reject H1 (p = 0.0040 <= 0.0125)
        weights: H1=0.000  H2=0.750  H3=0.250  H4=0.000
Step 2: reject H2 (p = 0.0180 <= 0.0188)
        weights: H1=0.000  H2=0.000  H3=0.500  H4=0.500
Step 3: reject H3 (p = 0.0090 <= 0.0125)
        weights: H1=0.000  H2=0.000  H3=0.000  H4=1.000
[1]  TRUE  TRUE  TRUE FALSE
   H1    H2    H3    H4
 TRUE FALSE FALSE FALSE
- Step 1:H1(0.004≦0.0125)を棄却。H1の重み0.5が半分ずつ流れ、H2は0.5→0.75、H3は0→0.25になります。
- Step 2:H2の閾値は0.025×0.75=0.01875(表示は0.0188)で、p=0.018が下回り棄却。H3とH4が0.500ずつになります。
- Step 3:H3(0.009≦0.0125)を棄却。H4に全αが集まり重み1.000(閾値0.025)になりますが、p=0.030>0.025なのでここで止まります。
- 4仮説に単純なBonferroni(0.025/4=0.00625)を使うとH1しか棄却できません。同じくFWERを強い意味で制御しながら、グラフでは3仮説を棄却できました。
棄却できる候補が複数あるとき、関数は先頭から処理していますが、どの順で棄却しても最終結果は変わらないことがBretz et al.(2009)で示されています。「少なくとも1つ有意になる確率」でデザインを比べたい場合は、Disjunctive Power とその多重比較補正の考え方が役立ちます。
ノードの重み \(w_i\) と辺の重み \(g_{ij}\) は、データを見る前にSAPで固定します。p値を見てから「H4へ多めに渡す」ようにグラフを組み替えると、FWERの保証は失われます。SAPにはグラフの図と重み行列の両方を載せておくと、審査側とも認識を合わせやすくなります。
自作関数の検算
最後に、graph_test() が正しく動いているかを確かめます。閉検定の例で定義した p_demo を再利用し、両側α=0.05で「重み1/3ずつ・棄却したら残り2仮説に均等に渡す」グラフを検定します。これはHolm法と一致するはずです。
# 自作関数の検算:重み 1/3 ずつ・残りの重みを均等に渡すグラフは Holm 法と一致するはず
G_holm <- matrix(0.5, 3, 3); diag(G_holm) <- 0
graph_test(p_demo, rep(1/3, 3), G_holm, alpha = 0.05)
Step 1: reject H1 (p = 0.0120 <= 0.0167)
        weights: H1=0.000  H2=0.500  H3=0.500
[1]  TRUE FALSE FALSE
閉検定手順・Holm法と同じく「H1のみ棄却」です。H2の閾値は0.05×0.5=0.025で、p=0.030は下回りません。このように、辺をすべて0にすればBonferroni法、均等に渡せばHolm法、先頭の仮説に重み1を置き辺1で次へ渡せば固定順序法になり、どれもグラフの特殊ケースとして書けます。手元の試験デザインをまずグラフに描いてみると、αの流れを関係者と共有しやすくなります。
シミュレーションでFWERと検出力を比べる
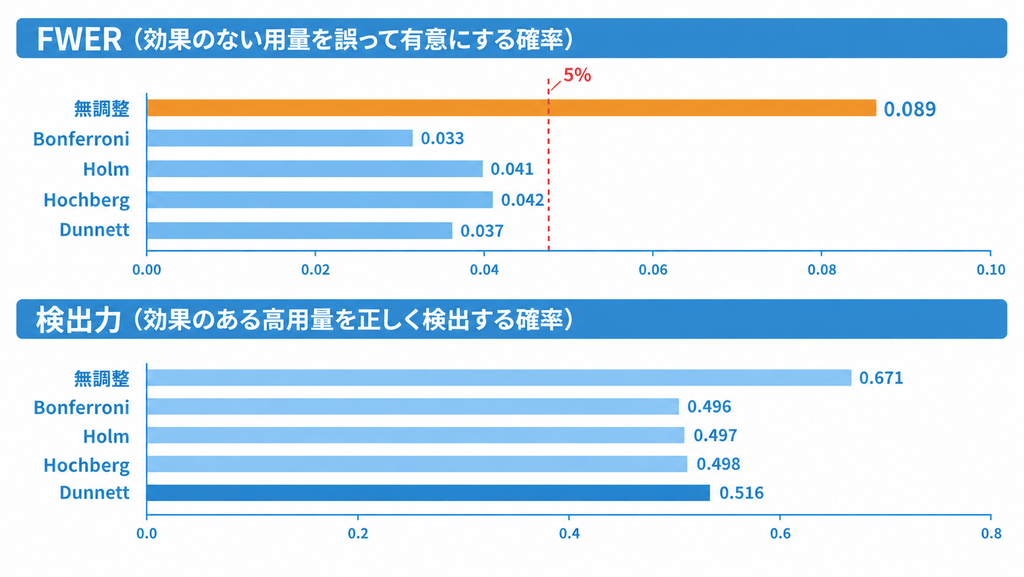
ここまでの手法が本当にFWERを守るのか、検出力にどれだけ差が出るのかを、1万回のシミュレーションで確かめます。条件は先ほどの3用量データと同じ「プラセボ+3用量・各群30例・SD 8・両側α=0.05」です。共通セットアップの例数 n と、Dunnett法の節で作った相関行列 R をそのまま使います。
シナリオは2つです。1つ目は3用量とも効果がない「全帰無仮説」、2つ目はLow・Midは効果なし、Highだけ真の効果5がある「部分帰無仮説」です。後者では、LowかMidを誤って有意にする確率(FWER)と、Highを正しく検出する確率(検出力)を同時に見ます。
# シミュレーション:FWER と検出力を 5 つの方法で比べる
set.seed(1)
crit_dunnett <- qmvt(0.95, tail = "both.tails", df = 4 * (n - 1), corr = R)$quantile

sim_mc <- function(delta, nsim = 10000, n = 30, sd0 = 8, alpha = 0.05) {
  df  <- 4 * (n - 1)
  out <- array(FALSE, dim = c(nsim, 5, 3),
               dimnames = list(NULL, c("none", "bonferroni", "holm", "hochberg", "dunnett"),
                               c("Low", "Mid", "High")))
  for (s in 1:nsim) {
    yy <- matrix(rnorm(4 * n, mean = rep(c(0, delta), each = n), sd = sd0), ncol = 4)
    s2 <- mean(apply(yy, 2, var))
    t  <- (colMeans(yy)[-1] - mean(yy[, 1])) / sqrt(2 * s2 / n)
    p  <- 2 * pt(-abs(t), df)
    out[s, "none", ]       <- p <= alpha
    out[s, "bonferroni", ] <- p.adjust(p, "bonferroni") <= alpha
    out[s, "holm", ]       <- p.adjust(p, "holm") <= alpha
    out[s, "hochberg", ]   <- p.adjust(p, "hochberg") <= alpha
    out[s, "dunnett", ]    <- abs(t) > crit_dunnett
  }
  out
}

set.seed(2026)
null_all <- sim_mc(delta = c(0, 0, 0))
round(apply(null_all, 2, function(r) mean(apply(r, 1, any))), 4)   # FWER(全帰無仮説が真)

set.seed(2026)
partial <- sim_mc(delta = c(0, 0, 5))
round(rbind(
  FWER       = apply(partial[, , c("Low", "Mid")], 2, function(r) mean(apply(r, 1, any))),
  power_High = apply(partial[, , "High"], 2, mean)), 4)
      none bonferroni       holm   hochberg    dunnett
    0.1201     0.0444     0.0444     0.0453     0.0508
             none bonferroni   holm hochberg dunnett
FWER       0.0888     0.0325 0.0410   0.0423  0.0370
power_High 0.6711     0.4963 0.4972   0.4978  0.5161
2つの出力を1つの表にまとめます。
| 方法 | FWER(全帰無仮説) | FWER(部分帰無仮説) | Highの検出力 |
|---|---|---|---|
| 無調整 | 0.1201 | 0.0888 | 0.6711 |
| Bonferroni | 0.0444 | 0.0325 | 0.4963 |
| Holm | 0.0444 | 0.0410 | 0.4972 |
| Hochberg | 0.0453 | 0.0423 | 0.4978 |
| Dunnett | 0.0508 | 0.0370 | 0.5161 |
- 無調整のFWERは0.1201で、名目5%の2.4倍です。それでも冒頭で計算した独立な場合の0.1426より小さいのは、3つの比較が共通のプラセボ群を使うため、比較どうしに相関0.5があるからです。プラセボ群の平均がたまたま低いと3比較が同時に有意になりやすく、誤りが重なる分「どれか1つ」の確率は膨らみにくくなります。
- Holm=Bonferroni(0.0444):全帰無仮説の下では、誤りが起きるかどうかはHolm法の第1段(最小のp値をα/3と比べる)だけで決まります。第1段はBonferroni法と同じ判定なので、FWERは一致します。
- Dunnett法は0.0508で、1万回のモンテカルロ誤差(±0.004程度)の範囲でほぼ名目どおりです。相関を使って、Bonferroni法が余らせていたαを使い切っています。
- 調整法の中では、検出力はDunnett法の0.5161が最大です。Bonferroni 0.4963 → Holm 0.4972 → Hochberg 0.4978とステップワイズ化で少しずつ上がりますが、多対1比較に特化して相関を使うDunnett法が上回ります。部分帰無仮説でのBonferroni法のFWER 0.0325は保守的です。
- 無調整の検出力0.6711は比べる土俵が違います。FWER 0.0888という「誤りの許容」と引き換えに得た数字だからです。検出力が足りないときは調整を外すのではなく、多重性の調整を前提に
nを設計し直します。
調整後の検出力で症例数を決める考え方は、検出力分析(Power Analysis)入門で整理しています。上の sim_mc() の n と delta を変えれば、そのまま多重性込みの検出力計算に使えます。
実務でのポイント ― 手法の選び方とSAPへの書き方
手法は「どれが一番有意になりやすいか」ではなく、仮説の family がどういう構造かで選びます。代表的な場面を表にまとめます。
| 場面 | 第一候補 | 理由 |
|---|---|---|
| 複数用量をそれぞれプラセボと比べる(多対1) | Dunnett法 | 比較間の相関を使えるため、シミュレーションでも調整法の中で検出力が最大 |
| 仮説に明確な優先順位がある(高用量から順に など) | 固定順序法・グラフィカルアプローチ | 先頭の仮説にαを全額使え、棄却できなければそこで止まる |
| 主要+副次の複数エンドポイント、複数用量の組み合わせ | グラフィカルアプローチ・Gatekeeping法 | αの配分と流れを事前に図で固定でき、SAPに書きやすい |
| 相関構造や分布の前提を説明できない | Holm法 | 前提なしで強い意味のFWER制御ができ、Bonferroni法より常に同等以上に棄却できる |
用量反応の形そのものを評価したい場合は、多重比較とモデリングを組み合わせるMCP-Modが選択肢になります。規制面では、ICH E9(1998年)が多重性の調整方法を解析計画で事前に定めることを求めており、FDAは2022年に最終版ガイダンス「Multiple Endpoints in Clinical Trials」を公表して、Holm法や固定順序法、グラフィカルアプローチなどの考え方を整理しています。SAPのどこに何を書くかは統計解析計画書(SAP)の書き方を参照してください。
- 盲検解除前にSAPで固定する:family に含む仮説、α(重み)の配分、グラフの辺や検定順序、片側か両側か。
- 結果を見てから手法を選び直さない。有意になる手法を後から探すこと自体が新たな多重性です。
- Hochberg法・Hommel法は相関の前提を確認する。独立または正の相関を説明できなければHolm法を選びます。
- 調整p値と信頼区間の扱いを明記する。報告する信頼区間が無調整か同時信頼区間かを書き、ステップワイズ法では調整p値と整合する区間が作りにくい点に注意します。
- 事前に family を定めにくい解析は探索的と位置づける。サブグループ解析などは調整で取り繕うより、位置づけを明記する方が誠実です。
📚 この記事をより深く理解するための参考書籍
多重比較は「原理」「手法の数理と検出力」「臨床試験での使い方」の3層で理解すると定着します。それぞれに対応する1冊を選びました。

p.adjust() を使って比べたBonferroni法・Holm法や、閉検定手順の考え方を、数式を追って確かめたいときの最初の一冊になります。

mvtnorm を使って計算したDunnett法の棄却限界値や、シミュレーションで見た検出力の差を理論面から裏づけられます。

関連記事・次のステップ
多重性の考え方を図で復習したい方は、多重比較法の基礎と活用とp値とは何か?から読み直してください。
αの流し方を深めたい方は、グラフィカルアプローチの魅力と実践とGatekeeping法とはが本記事の直接の続きです。
複数の仮説での検出力の定義を整理したい方は、Disjunctive Powerとその多重比較補正と同時検出力(Conjunctive Power)とはを、試験計画の上流から考えたい方はICH E9(R1) Estimandフレームワーク徹底解説をどうぞ。試験対策には統計検定準1級「分散分析・実験計画法」攻略が役立ちます。
まとめ
本記事では、多重比較法をbase Rと mvtnorm だけで実装し、調整の仕組みと実際の性能を確かめてきました。
出発点は、検定を増やすと偽陽性が膨らむという事実でした。独立な検定を3回行えばFWERは0.1426、10回なら0.4013に達します。プラセボ+3用量のシミュレーションでも、無調整のFWERは0.1201と名目5%の2倍を超えました。共通のプラセボ群による相関で独立の場合より小さくなるとはいえ、「5%で検定した」とは言えない水準です。
調整法には性格の違いがありました。p.adjust() で比べると、Bonferroni法はHighの調整p値が0.2381、ステップダウンのHolm法では0.1587まで下がります。多対1の比較に特化したDunnett法は比較どうしの相関を使うため、棄却限界値が2.429から2.380に下がり、部分帰無仮説のもとでの検出力も0.5161と調整法の中でもっとも高くなりました。閉検定手順を自作関数で動かすと、局所検定をBonferroniにした閉検定がHolm法と完全に一致することも確認できました。
グラフィカルアプローチでは、棄却された仮説のαが次の仮説へ渡っていく様子を重みの変化として追いました。単純なBonferroni法ではH1しか棄却できない例でも、同じくFWERを強い意味で守りながら3つの仮説を棄却できます。手順が図とアルゴリズムで一意に決まるので、SAPに書いておけば解析者によって結論が変わりません。
実務での結論は、データを見る前に、仮説のfamily・α配分・手順をSAPで固定することに尽きます。多対1ならDunnett法、優先順位があるなら固定順序法やグラフィカルアプローチ、前提がはっきりしなければHolm法を選び、Hochberg法は相関の前提を確認してから使ってください。
グラフィカルアプローチの考え方をもう一度図で整理したい方は 臨床試験における多重比較法 ― グラフィカルアプローチの魅力と実践、主要・副次評価項目の階層構造を型から学びたい方は Gatekeeping法とは、用量反応の評価へ進みたい方は MCP-Mod(多重比較とモデリング)で用量反応を解析する もあわせてご覧ください。多重性の調整を「公式を当てはめる作業」ではなく「αをどう使うかの設計」として捉え、自信を持ってSAPに書けるようになっていただければと思います。