症例数が少ないときの統計解析 ― 正確検定・並べ替え検定・Firth法の使い分けをRとSASで実装する ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- 症例数が少ないと大標本近似が崩れ、第1種の過誤や信頼区間がずれる仕組み
- 2値データでのカイ二乗検定とFisherの正確検定の使い分け(過誤率の厳密計算つき)
- 連続データでの並べ替え検定のRとSASでの実装
- 完全分離へのFirth法、混合モデルのKenward-Roger法、ベイズ借用の位置づけ
- 少数例の試験で解析計画に書くべきこと
はじめに
希少疾患、小児、第I相・早期第II相試験など、症例数を増やしたくても増やせない場面があります(各相の位置づけは臨床試験のフェーズ(第I相〜第IV相)とはを参照)。そうした試験で大規模試験と同じ解析をそのまま使うと、p値や信頼区間が正しくなくなることがあります。
本記事では、どの解析が、なぜ、どちらの方向に崩れるのかをRの厳密計算とシミュレーションで確かめ、代わりの方法を整理します。想定する読者は、製薬企業の生物統計担当者、臨床研究に携わる医師・研究者、統計を学ぶ大学院生の方です。t検定・p値・信頼区間の基本は知っている前提で進めます。
症例数が少ないと何が起きるのか ― 大標本近似が崩れる仕組み
多くの検定は「大標本近似」に頼っている
多くの検定や信頼区間は、「症例数が十分に大きければ、統計量の分布は正規分布やカイ二乗分布に近づく」という性質(中心極限定理など)を使ってp値を計算しています。これを大標本近似(漸近近似)と呼びます。症例数が少ないと、この近似のずれが無視できなくなります。
例として、比率のWald型信頼区間を見てみましょう。
\[ \hat{p}\pm1.96\sqrt{\hat{p}(1-\hat{p})/n} \]
\(\hat{p}\) は観測された割合、\(n\) は例数です。n が小さいときや割合が0や1に近いときは、この区間が真の値を含む確率(被覆確率)が、名目の95%を下回ります。各手法の比較は二項比率の信頼区間で扱っています。
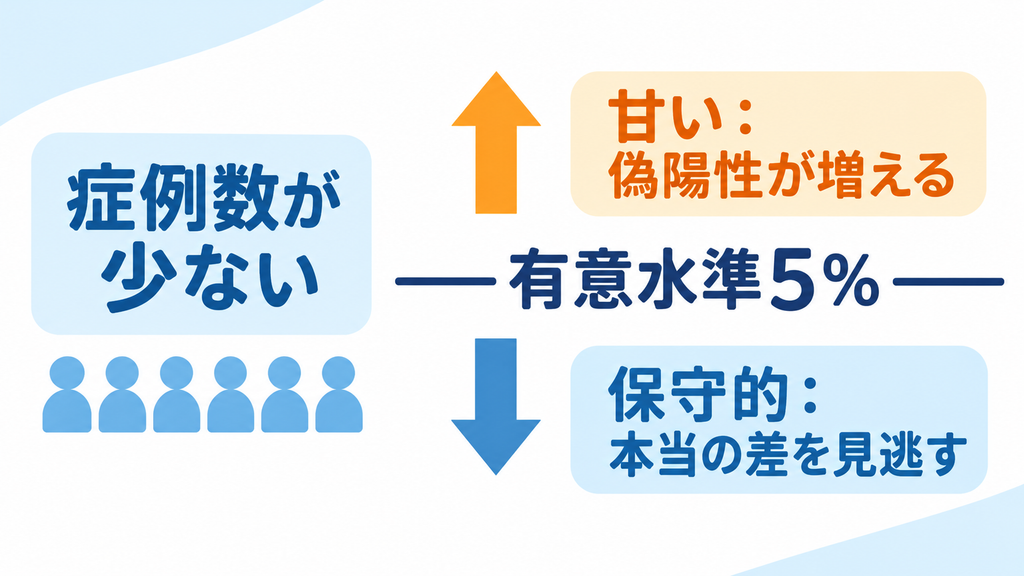
ずれは検定の第1種の過誤にも現れます。第1種の過誤とは、本当は差がないのに「差あり」と判定してしまう誤りで、有意水準5%の検定ではこの確率が5%になるよう作られています(p値とは何か?)。小標本では、これが5%を超える「甘い」方向と、5%を大きく下回る「保守的」な方向の2通りに崩れます。甘ければ偽陽性が増え、保守的なら本当の差を見逃しやすく(検出力が低く)なります。次章以降で、両方の例を実測で見ていきます。
小標本で崩れやすい場面と代わりの方法
場面ごとに、崩れ方と代わりの方法を整理すると次のとおりです。
| 場面 | 大標本で使う方法 | 小標本で起きること | 代わりの方法 |
|---|---|---|---|
| 2値データの群間比較 | カイ二乗検定 | 期待度数が小さいと近似が崩れる | Fisherの正確検定 |
| 比率の信頼区間 | Wald型信頼区間 | 被覆確率が95%を下回る | Clopper-Pearson法・Wilson法 |
| 連続データの群間比較 | t検定 | 正規性の仮定が効き、外れ値に弱い | 並べ替え検定・Wilcoxon順位和検定(正確検定) |
| ロジスティック回帰 | 最尤法 | 完全分離で推定値が発散する | Firth法 |
| 混合モデル(MMRMなど) | 通常の検定 | 標準誤差が小さめ・自由度が大きめに出て検定が甘くなる | Kenward-Roger法 |
| 情報そのものが足りない | ─ | 検出力が低く信頼区間が広い | ベイズ流の情報借用 |
連続データでは、「正規性の検定で有意でなかったからt検定」と判断したくなりますが、数例ずつでは正規性の検定もほとんど検出力がなく、「有意でない=正規分布」とは言えません(正規性の検定(Shapiro-Wilk)とは)。
正確検定・並べ替え検定・Firth法は「近似の誤り」を防ぐ方法であって、「情報不足」を解決する方法ではありません。症例数が少なければ検出力は低く、有意でないことは効果がないことを意味しません。
ここまでのまとめ
- 小標本では大標本近似が崩れ、第1種の過誤や被覆確率が名目からずれる
- 崩れる方向は「甘い」と「保守的」の2通りあり、場面ごとに代わりの方法がある
- どの方法も情報不足は補えない。有意でないことは効果がないことではない
2値データの小標本解析 ― Fisherの正確検定と第1種の過誤
2値データ(奏効あり/なし)の群間比較は、少数例の試験でいちばんよく出会う場面です。ここでは2つの実測で、近似に頼るカイ二乗検定と、数え上げで p値を求めるFisherの正確検定が、症例数が少ないときにそれぞれどう振る舞うかを確かめます。
カイ二乗検定とFisherの正確検定の過誤率を厳密に比べる
まず、本当は差がないのに誤って「差あり」と判定してしまう確率(第1種の過誤)を調べます。各群 n 例、両群とも真の奏効率が0.3の設定で、有意水準5%の検定を行ったときの過誤率です。
# 各群8例・両群とも真の奏効率0.3(本当は差がない)のとき、
# 有意水準5%で誤って「差あり」と判定してしまう確率(第1種の過誤)を全組合せで厳密に計算する
type1 <- function(n, p) {
  g  <- expand.grid(x1 = 0:n, x2 = 0:n)              # 2群の奏効例数のすべての組合せ
  pr <- dbinom(g$x1, n, p) * dbinom(g$x2, n, p)      # その組合せが起きる確率
  pv <- t(sapply(seq_len(nrow(g)), function(i) {
    m <- matrix(c(g$x1[i], n - g$x1[i], g$x2[i], n - g$x2[i]), nrow = 2, byrow = TRUE)
    if (sum(m[, 1]) %in% c(0, 2 * n)) return(c(1, 1)) # 全員奏効・全員非奏効は検定不能→p=1
    c(chisq = suppressWarnings(chisq.test(m, correct = FALSE)$p.value),
      fisher = fisher.test(m)$p.value)
  }))
  round(c(n = n, カイ二乗 = sum(pr[pv[, 1] < 0.05]), Fisher = sum(pr[pv[, 2] < 0.05])), 4)
}
rbind(type1(8, 0.3), type1(15, 0.3), type1(50, 0.3))
      n カイ二乗 Fisher
[1,]  8   0.0527 0.0119
[2,] 15   0.0548 0.0170
[3,] 50   0.0498 0.0307
このコードは乱数を使うシミュレーションではありません。各群 n 例で起こりうる奏効例数の組合せ \((x_1,x_2)\) をすべて列挙し、それぞれが起こる確率(二項分布の dbinom)と p値を計算して、p<0.05 になる組合せの確率を合計しています。だから結果は乱数に左右されない厳密な値です。カイ二乗検定は連続性補正なし(correct = FALSE)、n は1群あたりの例数です。
- 各群8例・15例では、カイ二乗検定の第1種の過誤は 0.0527・0.0548 と5%をわずかに超えます。この設定では甘い側にずれています。
- Fisherの正確検定は 0.0119・0.0170 と5%を大きく下回ります。保守的すぎて、本当の差を見逃しやすい状態です。正確検定の結果はとびとびの値しかとらず、p値も「5%ちょうど」で区切れないためです(離散性)。これを和らげる工夫が mid-p値で、詳しくは連続分布のp値と離散分布のp値、そしてmid-p値の意義で解説しています。
- 各群50例ではカイ二乗検定は 0.0498 とほぼ名目どおりで、Fisherも 0.0307 まで近づきます。症例数が増えると近似が効いてきます。
- 小標本では「Fisherなら安全」は第1種の過誤については正しいものの、その代償として検出力を失います。どちらの方向に崩れるかを知ったうえで選びましょう。検定の仕組みそのものはFisherの正確検定をご覧ください。
小規模試験の2×2表をFisherの正確検定で解析する
次に、新薬8例中6例、プラセボ8例中1例が奏効した架空の小規模試験を解析します。期待度数を先に確認するのが実務の手順です。
# 新薬8例中6例・プラセボ8例中1例が奏効した小規模試験
m <- matrix(c(6, 2, 1, 7), nrow = 2, byrow = TRUE,
            dimnames = list(群 = c("新薬", "プラセボ"), 奏効 = c("あり", "なし")))
m
chisq.test(m)$expected        # 期待度数(5未満のセルがあるか確認)
fisher.test(m)
          奏効
群        あり なし
  新薬        6    2
  プラセボ    1    7
          奏効
群        あり なし
  新薬      3.5  4.5
  プラセボ  3.5  4.5
Warning message:
In chisq.test(m) : Chi-squared approximation may be incorrect

	Fisher's Exact Test for Count Data

data:  m
p-value = 0.04056
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
    1.087594 1088.437009
sample estimates:
odds ratio
  16.19942
m は2×2の分割表、chisq.test(m)$expected は帰無仮説のもとでの期待度数です。一つの目安として、期待度数5未満のセルが全体の20%を超えたら正確検定を考えます。分割表の考え方は分割表の独立性の検定にまとめています。
- 期待度数は4つのセルすべてが 3.5または4.5 で5未満です。Rも「カイ二乗近似は正しくないかもしれない」と警告しています(日本語環境では警告文が日本語で表示されることがあります)。
- Fisherの正確検定は p=0.041 で5%を下回りました。
- オッズ比の推定値は 16.2、95%信頼区間は 1.09〜1088 と極端に広く、「差はありそう」とは言えても効果の大きさはほとんど分かりません。小標本では p値だけでなく信頼区間の幅を必ず見ます。
- この推定値は条件付き最尤推定値で、表から手計算する \((6\times7)/(2\times1)=21\) とは一致しません。
- 比率そのものの信頼区間は Clopper-Pearson(正確法)や Wilson法を使います。比率の差の信頼区間をきちんと出したいときは比率の差の検定と信頼区間について徹底解説が参考になります。
ここまでのまとめ
- 各群8例・15例では、カイ二乗検定は5%をわずかに超え(甘い)、Fisherの正確検定は5%を大きく下回ります(保守的)。
- 期待度数が5未満のセルが目立つ2×2表では、近似の警告に従い正確検定を使います。
- 有意でも、オッズ比の信頼区間は非常に広いままです。p値と信頼区間をセットで報告しましょう。
連続データの小標本解析 ― 並べ替え検定をRとSASで実装する
希少疾患の小規模試験を想定します。新薬6例・プラセボ6例で、12週後のバイオマーカー減少量を比べます。以下のデータは説明用の架空データです。 連続データの小標本では、t検定が前提とする正規分布が当てはまるかを確かめようがなく、外れ値1つで結論が変わりかねません。
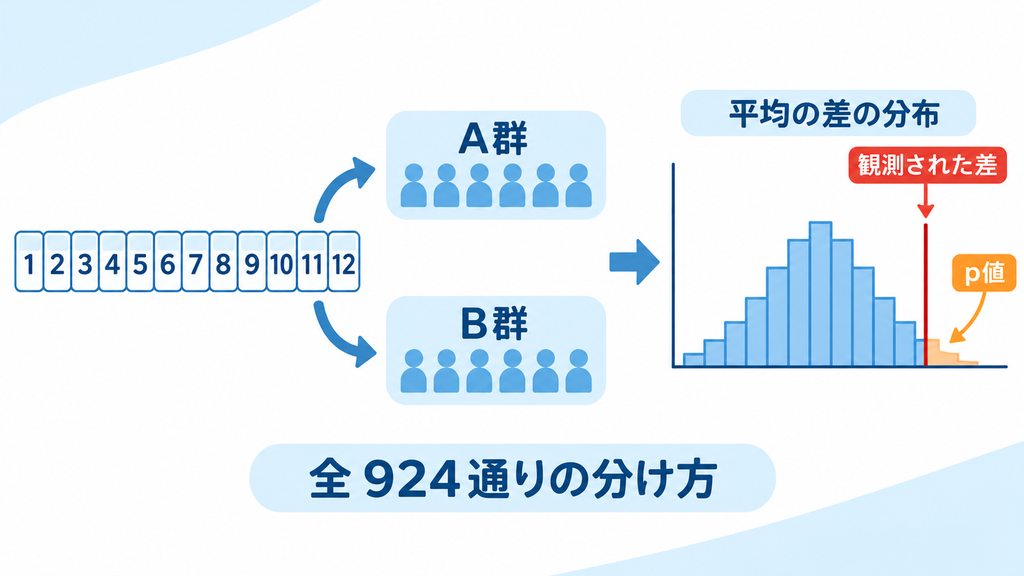
そこで使えるのが並べ替え検定(permutation test)です。「群の違いが本当にないなら、どの人がどちらの群に入っていても同じ」と考えます。12枚のカードに値を書き、6枚ずつ2つの山に配り直す場面を想像してください。配り直すたびに平均の差を計算し、実際に観測された差と同じかそれ以上に極端な配り方の割合を p値とします。正規分布は仮定せず、帰無仮説は「2群の分布が同じ」です。ランダム化試験では、ランダム化そのものがこの検定の根拠になります。
\[ p=\frac{\#\{\,|D^{\ast}|\ge|D_{\text{obs}}|\,\}}{\binom{12}{6}} \]
\(D_{\text{obs}}\) は観測された平均の差、\(D^{\ast}\) は割り付け直したときの平均の差、\(\#\{\cdot\}\) は条件を満たす分け方の数です。分母は分け方の総数 \(\binom{12}{6}=924\) です。
Rでの実装
まず、Welchのt検定とWilcoxon順位和検定を実行します。
# 希少疾患の小規模試験:12週後のバイオマーカー減少量(新薬6例・プラセボ6例、架空データ)
new <- c(12.1, 8.4, 15.3, 9.7, 41.2, 11.0)
pbo <- c(3.2, 6.8, -1.5, 4.9, 9.1, 2.4)
t.test(new, pbo)                          # Welchのt検定(Rの既定)
wilcox.test(new, pbo)                     # Wilcoxon順位和検定(同順位なし→正確検定)
	Welch Two Sample t-test

data:  new and pbo
t = 2.2921, df = 5.8729, p-value = 0.06271
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -0.8880058 25.1546725
sample estimates:
mean of x mean of y
 16.28333   4.15000


	Wilcoxon rank sum exact test

data:  new and pbo
W = 35, p-value = 0.004329
alternative hypothesis: true location shift is not equal to 0
t.test() は等分散を仮定しないWelchのt検定を既定で行います。wilcox.test() は各群50例未満で同順位がないとき、正確検定を自動で選びます。
- 平均は新薬 16.28、プラセボ 4.15 です。新薬群の1例(41.2)が飛び抜けて大きい架空データです。
- Welchのt検定は p=0.063 で5%を超え、差の95%信頼区間 −0.89〜25.15 も0をまたぎます。外れ値1つが新薬群の標準偏差を大きくし、t値を小さくしてしまいました。
- Wilcoxon順位和検定は値そのものではなく順位を使うので外れ値の影響を受けにくく、p=0.0043 です。
- 6例ずつでは正規性の検定もほとんど検出力がありません。「正規性検定で有意でなかったからt検定」という判断は当てになりません。
次に、並べ替え検定を自分で実装します。12人を6人と6人に分け直す全924通りを列挙します。
# 並べ替え検定:12人の値を「6人と6人」に分け直す全924通りで平均の差を計算する
y    <- c(new, pbo)
obs  <- mean(new) - mean(pbo)             # 実際に観測された平均の差
idx  <- combn(12, 6)                      # 新薬群に入る6人の選び方すべて
perm <- apply(idx, 2, function(i) mean(y[i]) - mean(y[-i]))
length(perm)
round(obs, 3)
mean(abs(perm) >= abs(obs) - 1e-8)        # 両側p値:観測値以上に極端な分け方の割合
[1] 924
[1] 12.133
[1] 0.004329004
combn(12, 6) は12人から6人を選ぶ組合せをすべて列挙する関数で、\(\binom{12}{6}=924\) 通りです。それぞれの分け方で平均の差を計算し、観測された差 12.133 と同じかそれ以上に極端(絶対値が大きい)な分け方の割合が両側 p値になります。- 1e-8 は、小数の丸め誤差で「同じ値」を取りこぼさないための小さな余裕です。
- 並べ替え検定の p値は 0.0043(924通り中4通り)です。t検定と同じ平均の差を使いながら、正規分布を仮定せずに p値を求めたので、外れ値があっても有効な検定になっています。
- この例ではWilcoxon順位和検定と同じ p値になりましたが、統計量が違うので一般には一致するとは限りません。
- 組合せの数は症例数とともに急増します(各群10例で \(\binom{20}{10}=184756\) 通り)。多いときは、ランダムに数万通りを抜き出すモンテカルロ法で近似します。
- 正確検定でも症例数の少なさは解決しません。p値が小さくても効果の大きさの推定は不安定なので、信頼区間・効果量を併記してください。
Wilcoxon順位和検定の数理はノンパラメトリック検定の代表格:ウィルコクソン検定の数理と実装、ノンパラメトリック法全般の整理は統計検定準1級「ノンパラメトリック法」攻略で詳しく解説しています。3つの結果を整理します。
| 方法 | 使う情報 | 正規分布の仮定 | p値 |
|---|---|---|---|
| Welchのt検定 | 平均と標準偏差 | あり | 0.063 |
| Wilcoxon順位和検定(正確検定) | 順位 | なし | 0.0043 |
| 並べ替え検定 | 値そのもの(平均の差) | なし | 0.0043 |
ここまでのまとめ
- 外れ値が1つあるだけで、Welchのt検定は p=0.063 と差を見逃しました。
- Wilcoxon順位和検定と並べ替え検定は、どちらも p=0.0043 で差を検出しました。
- 並べ替え検定は全924通りを数えるだけで実装でき、正規分布を仮定しません。
SASでの実装
SASでは、同じ12例を PROC TTEST と PROC NPAR1WAY で解析します。
/* 新薬6例・プラセボ6例のバイオマーカー減少量(架空データ) */
data bm;
  input group $ y @@;
  datalines;
new 12.1 new 8.4 new 15.3 new 9.7 new 41.2 new 11.0
pbo 3.2 pbo 6.8 pbo -1.5 pbo 4.9 pbo 9.1 pbo 2.4
;
run;

/* Welchのt検定(出力のSatterthwaiteの行を見る) */
proc ttest data=bm;
  class group;
  var y;
run;

/* Wilcoxon順位和検定の正確検定 */
proc npar1way data=bm wilcoxon;
  class group;
  var y;
  exact wilcoxon;
run;

/* 並べ替え検定:元の値そのものをスコアとして使う(SCORES=DATA) */
proc npar1way data=bm scores=data;
  class group;
  var y;
  exact scores=data;
run;

/* 組合せが多いときはモンテカルロ法で近似する */
proc npar1way data=bm scores=data;
  class group;
  var y;
  exact scores=data / mc n=100000 seed=4869;
run;
input group $ y @@;の@@は、1行に複数の観測値(群と値の組)を続けて書けるようにする指定です。PROC TTESTは、等分散を仮定するPooled(プール)の行と、仮定しないSatterthwaiteの行を両方出力します。Rのt.test()の既定(Welch)に対応するのはSatterthwaiteの行です。PROC NPAR1WAYのWILCOXONオプションでWilcoxon順位和検定、EXACT WILCOXON;でその正確検定の p値を求めます。SCORES=DATAは、順位ではなく元の値そのものをスコアとして使う指定です。EXACT SCORES=DATA;と組み合わせると、元の値を使った並べ替え検定(正確検定)になります。群の例数が固定されているので、値の合計を使う検定は平均の差を使う検定と同じ結論になります。EXACT文の/ MCでモンテカルロ法による近似、N=で抜き出す回数、SEED=で乱数の種を指定します。組合せが膨大で正確計算に時間がかかるときに使います。
本記事で扱った他の手法のSASでの指定も、あわせて整理します。
| 手法 | SASの指定 |
|---|---|
| Fisherの正確検定 | PROC FREQ の TABLES 文 / FISHER または EXACT FISHER; |
| 比率の正確な信頼区間(Clopper-Pearson) | PROC FREQ の TABLES 文 / BINOMIAL(正確な信頼限界が出力される) |
| Firth法 | PROC LOGISTIC の MODEL 文 / FIRTH CLPARM=PL |
| Kenward-Roger法 | PROC MIXED の MODEL 文 / DDFM=KR |
SASの出力で、並べ替え検定の正確な p値とRの結果を突き合わせると、実装の検算になります。
シミュレーションで第1種の過誤を確かめる
6例ずつの1回のデータだけでは、手法そのものの性質は分かりません。そこで「本当は差がない」状況を何度も再現し、誤って「差あり」となる割合(第1種の過誤)を比べます。
# 各群5例・両群とも同じ歪んだ分布(対数正規分布)=本当は差がない状況を5,000回再現し、
# 誤って「差あり」となる割合(第1種の過誤)をWelchのt検定と並べ替え検定で比べる
set.seed(4869)
idx5 <- combn(10, 5)
res <- replicate(5000, {
  x <- rlnorm(5, meanlog = 0, sdlog = 1.5)
  z <- rlnorm(5, meanlog = 0, sdlog = 1.5)
  y <- c(x, z)
  d <- apply(idx5, 2, function(i) mean(y[i]) - mean(y[-i]))
  c(welch = t.test(x, z)$p.value < 0.05,
    perm  = mean(abs(d) >= abs(mean(x) - mean(z)) - 1e-8) < 0.05)
})
rowMeans(res)
 welch   perm
0.0124 0.0462
対数正規分布は右に長く裾を引く分布で、バイオマーカーや薬物濃度でよく見られる形です。両群とも同じ分布から5例ずつ乱数を発生させ(=本当は差がない)、これを5,000回くり返して、Welchのt検定と並べ替え検定(各群5例なので \(\binom{10}{5}=252\) 通り)で p<0.05 になった割合を求めました。set.seed(4869) で乱数を固定しているので再現できます。実行には数十秒かかります。
- Welchのt検定の第1種の過誤は 0.0124 です。5%より大幅に小さく、「甘い」のではなく保守的すぎる方向に崩れました。本当に差があっても見逃しやすい(検出力が低い)ことを意味します。
- 並べ替え検定は 0.0462 で、名目の5%に近い値でした。並べ替え検定は、帰無仮説のもとで第1種の過誤が5%を超えないことが分布の形によらず保証されます(離散性のため5%ちょうどにはなりません)。
- 小標本のt検定は「正規分布に近ければ頑健」と言われますが、歪んだ分布では崩れ方が分布の形によって変わります。この結果は1つの設定での例であり、どの方向に崩れるかは分布や群の例数によります。
- 5,000回のシミュレーションなので、割合には±0.006程度の誤差があります。
ブートストラップも「手元の標本が母集団をよく代表している」ことを前提とした近似なので、数例しかないデータでは万能ではありません。並べ替え検定は、帰無仮説のもとで群の割り付けを入れ替えるだけなので、この点で性質が異なります。
回帰モデル・混合モデルでの小標本対策 ― Firth法・Kenward-Roger法・ベイズ借用
完全分離をFirth法で回避する
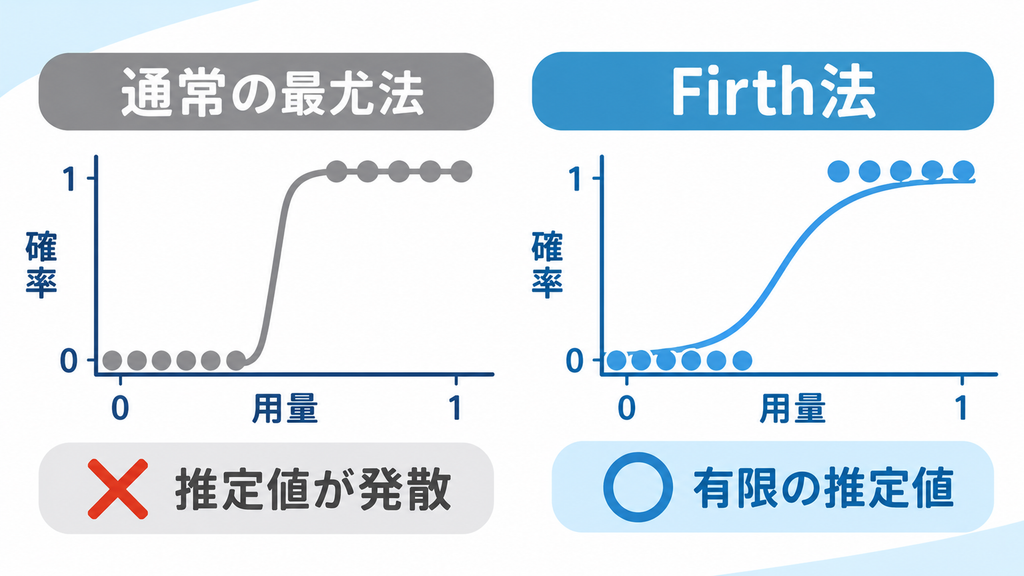
ロジスティック回帰では、ある説明変数の値によって結果(0/1)が完全に分かれる完全分離が起き、最尤推定値が無限大に発散して推定できなくなることがあります。症例数が少ないときやイベントがまれなときに起きやすい現象です。Firth法は対数尤度にペナルティ(Jeffreys事前分布に相当)を加えて最尤推定のバイアスを小さくする方法で、完全分離でも有限の推定値を返します。
# 12例の小さなデータ:用量が高い人だけが反応し、完全分離が起きている
dat <- data.frame(dose = c(1, 1, 2, 2, 3, 3, 4, 4, 5, 5, 6, 6),
                  resp = c(0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1))
fit_ml <- glm(resp ~ dose, family = binomial, data = dat)
round(coef(summary(fit_ml)), 3)           # 通常の最尤法
library(logistf)
fit_fi <- logistf(resp ~ dose, data = dat)
round(cbind(coef = coef(fit_fi), lower = fit_fi$ci.lower, upper = fit_fi$ci.upper, p = fit_fi$prob), 3)
Warning message:
glm.fit: fitted probabilities numerically 0 or 1 occurred
            Estimate Std. Error z value Pr(>|z|)
(Intercept) -165.318  288161.17  -0.001        1
dose          47.234   81504.25   0.001        1
              coef   lower  upper     p
(Intercept) -6.903 -29.488 -1.478 0.003
dose         1.972   0.482  8.255 0.001
glm が通常の最尤法、logistf がFirth法です(CRAN から install.packages("logistf") で導入)。
- 用量3以下は全員0、用量4以上は全員1で、完全分離です。
- 通常の最尤法は「当てはめた確率が数値的に0か1になった」と警告し、用量の係数 47.234・標準誤差 81504.25・p値 1 という意味のない結果になりました。推定値が発散しようとして計算が止まった状態です。
- Firth法は用量の係数 1.972、95%信頼区間 0.482〜8.255、p値 0.001 と、有限で解釈できる値を返します。オッズ比に直すと \(\exp(1.972)\approx7.18\)(用量が1上がるごとに反応のオッズが約7.2倍)。
- 信頼区間はプロファイル罰則付き尤度による(
logistfの既定)もので、12例しかないため上限8.255と広くなります。詳しくはFirthのロジスティック回帰とはをご覧ください。
混合モデルの自由度補正とベイズ流の情報借用
Kenward-Roger法:MMRMなどの混合モデルで固定効果を検定するとき、症例数が少ないと通常の方法では標準誤差が小さめに出て、自由度も大きめに扱われるため、検定が甘くなります。Kenward-Roger法は標準誤差の補正と、Satterthwaite型の自由度の近似を組み合わせてこれを補正します。SASでは PROC MIXED の MODEL 文の DDFM=KR、Rでは mmrm の method = "Kenward-Roger" で指定します。実装はmmrmをRで実装するとmmrmをSASで実装するで確認できます。
ベイズ流の情報借用:症例数そのものが足りないときは、過去の試験・外部対照・成人データなどを事前分布として取り込み、精度を補います。階層モデルや、食い違うほど借用を弱める動的借用が代表例です。基礎はベイズ階層モデル、外部情報の使い方は外部対照群の統計手法、規制面はFDA 2026年ベイズドラフトガイダンス徹底解読、単群試験は二値エンドポイントの単群臨床試験におけるベイズ流デザイン入門が参考になります。
外部情報と現在のデータの食い違い(prior-data conflict)があると、借用は偏りを生みます。借用の程度を事前に決め、シミュレーションで第1種の過誤や検出力を確認しましょう。また、ブートストラップも「手元の標本が母集団をよく代表している」ことを前提とした近似なので、数例しかないデータでは万能ではありません。ブートストラップ法とはで前提を確認してください。
ここまでのまとめ
- 完全分離では通常の最尤法は破綻しますが、Firth法は有限の推定値と信頼区間を返します。
- 混合モデルは検定が甘くなるため、Kenward-Roger法で自由度を補正します。
- ベイズ流の借用は情報不足を補えますが、食い違いに備えて動作特性を事前に確認します。
実務でのポイント ― 少数例の試験で解析計画に書くべきこと
- 解析方法は事前に決める:データを見てから「t検定で有意でなかったのでWilcoxonにする」と選び直すと、第1種の過誤が膨らみます。統計解析計画書で主解析(並べ替え検定やFisherの正確検定など)と感度解析を事前に規定します。
- 差の大きさと信頼区間を報告する:小標本ではp値が少し変わるだけで判定が入れ替わります。効果量(Effect Size)と信頼区間を併記し、区間の広さも結果として伝えます。
- 全例のデータを見せる:6例ずつなら、全員の値を点で示すドットプロットが平均±SDより多くの情報を伝えます。
- 多重性に注意する:少数例で多くの評価項目を検定すると偶然の有意が出やすくなります(多重比較法をRで実装する)。
- 設計段階で限界を織り込む:単群で有効性を早期に判断する二段階デザインなどの選択肢があります(Simonの二段階デザインとは)。
少数例の解析チェックリスト
- 期待度数・例数を確認し、正確検定が必要か判断したか
- 連続データの外れ値や歪みを確認し、並べ替え検定やWilcoxon検定を検討したか
- ロジスティック回帰で完全分離が起きていないか確認したか
- 混合モデルでKenward-Roger法などの自由度補正を指定したか
- p値だけでなく効果の大きさと信頼区間を示したか
📚 この記事をより深く理解するための参考書籍
小標本で使う正確検定・ノンパラメトリック法・回帰モデルを、理論の面から深めるための3冊を紹介します。



関連記事・次のステップ
本記事で使った個別手法を深めたい方は、2値データの正確検定をFisherの正確検定で、完全分離への対処をFirthのロジスティック回帰とはで、再標本化による推定をブートストラップ法とはでご覧ください。比率の信頼区間を選び直したい方には二項比率の信頼区間が直接の続きになります。
症例数そのものを補う考え方を知りたい方は、ベイズ階層モデルと二値エンドポイントの単群臨床試験におけるベイズ流デザイン入門がおすすめです。設計段階での工夫はSimonの二段階デザインとはと第I相がん臨床試験の用量探索デザインで扱っています。
ノンパラメトリック法を体系的に押さえたい方は、ウィルコクソン検定の数理と実装・対応のあるt検定とウィルコクソン符号順位検定・統計検定準1級「ノンパラメトリック法」攻略を順に読むと、順位にもとづく検定の全体像がつかめます。
まとめ
本記事では、症例数が少ないときにどの解析が崩れ、何に置き換えればよいかを、Rの厳密計算とシミュレーションで確かめながら整理しました。
小標本で起きる問題の中心は、大標本近似のずれです。そのずれは「甘くなる」方向にも「保守的になる」方向にも現れます。各群8例の2値データでは、カイ二乗検定の第1種の過誤が0.0527と5%を超える一方、Fisherの正確検定は0.0119と保守的すぎて検出力を失っていました。6例対6例の連続データでは、外れ値1つのせいでWelchのt検定がp=0.063と差を見逃し、正規分布を仮定しない並べ替え検定(全924通り)はp=0.0043で差を検出しました。各群5例の歪んだ分布のシミュレーションでも、Welchのt検定の過誤率0.0124に対し、並べ替え検定は0.0462と名目の5%近くを保っています。
回帰モデルでも、12例の完全分離データで通常の最尤法は標準誤差81504という意味のない値を返し、Firth法は係数1.972(95%信頼区間0.482〜8.255)という解釈できる結果を返しました。混合モデルではKenward-Roger法による自由度補正、情報そのものが足りないときはベイズ流の情報借用が選択肢になります。
ただし、どの方法も近似の誤りを防ぐものであり、情報不足そのものは解決しません。少数例の試験では、解析方法を事前に決め、p値だけでなく効果の大きさと信頼区間を示し、全例のデータを見せることが何より大切です。症例数を増やせない試験でこそ、手法の性質を理解したうえで解析計画を組み立てていただければと思います。