AI創薬とは ― 仕組み・最新事例・臨床成功率を生物統計家の視点でやさしく解説 ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
この記事でわかること
- AI創薬とは何か、なぜ注目されているのか
- 新薬開発のどこにAIが使われるのか
- 成功例・失敗例と、臨床試験での成功率
- 予測上位を選ぶと起きる「勝者の呪い」をRで体感する
- 生物統計家がAI創薬で果たす役割
はじめに
ニュースや新聞で「AI創薬」という言葉を目にする機会が増えました。しかし、「AIが薬を作る」とは具体的に何をしているのか、本当に成功しているのかは、意外と知られていません。
この記事では、導入から全体像を整理し、最後に臨床試験・統計の立場から「AIの予測をどう評価し、どう臨床につなぐか」を考えます。想定している読者は、製薬企業で働く方(統計以外の職種も含みます)、生物統計の担当者、そしてこの分野に関心のある学生や社会人の方です。
なお、AI全般の製薬業界での使われ方や規制については説明可能AI(XAI)とはで詳しく扱っています。本記事は「創薬」に焦点を当てます。
AI創薬とは ― 新薬開発の「長い・高い・成功しにくい」をどう変えるのか
AI創薬とは、機械学習・深層学習・生成AIなどを使って、薬の標的探しから候補化合物の設計・絞り込みまでの研究段階を効率化・高度化する取り組みです。
背景にあるのは、新薬開発の難しさです。日本製薬工業協会(製薬協)のDATA BOOK 2021をもとにした厚生労働省の資料では、国内企業の自社開発品について、合成された化合物が承認に至る累積の成功率は2015〜2019年で約2万3千分の1(1:22,749)、基礎研究から承認までの期間は9〜17年とされています。なお、成功確率は何を分母にするか(化合物数かプロジェクト数か)で大きく変わるため、数字は目安として受け取ってください。
新薬ができるまでの流れとAIが入り込む場所
創薬(ディスカバリー)は、病気の原因に関わる分子を見つけ、それに作用する薬の候補(化合物)を作り出す研究段階です。その後、動物や細胞で安全性・薬理を確かめる非臨床試験、人で確かめる臨床試験、承認申請・審査へと進みます。AIが関わる場所を整理すると、次のようになります。
| 段階 | 何をするか | AIの主な役割 |
|---|---|---|
| 標的探索 | 薬が作用する分子(標的)を選ぶ | 大規模データや論文の解析、立体構造の予測 |
| ヒット探索 | 標的に作用する化合物(ヒット)を見つける | バーチャルスクリーニングで膨大な化合物を予測で絞り込む |
| リード最適化 | ヒットを改良し、臨床に進める候補化合物を決める | 新しい分子の提案、ADMET(吸収・分布・代謝・排泄・毒性)の予測 |
| 非臨床試験 | 動物・細胞で安全性と薬理を確認する | 毒性や体内動態の予測による絞り込みの支援 |
| 臨床試験のフェーズ(第I〜III相) | 人で安全性と有効性を確かめる | 試験デザインの支援など(本記事では概要のみ) |
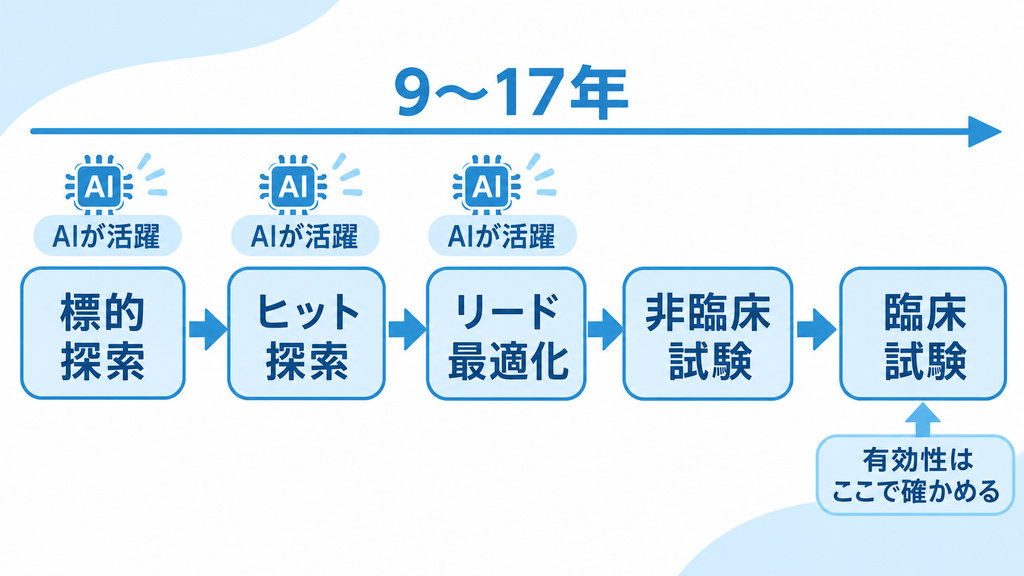
AIの狙いは大きく3つあります。①候補を早く・安く見つける、②失敗しそうな候補(体内で吸収されない、毒性があるなど)を早めに落とす、③人が思いつかない分子や仮説を出す、の3点です。
AI創薬で使われる主な技術
機械学習は、データからパターンを学び、未知のデータについて予測するアルゴリズムの総称です。創薬では、化合物の構造から活性やADMETなどの性質を予測するのに使われます。
深層学習(ディープラーニング)は、多層のニューラルネットワークを使う機械学習の一種です。タンパク質の立体構造予測のように、複雑なパターンの学習が必要な場面で力を発揮します。
生成AI(生成モデル)は、学習したデータの特徴をもとに新しいデータを作り出すAIです。創薬では、望ましい性質を持ちそうな新しい分子構造を提案するのに使われます。
ナレッジグラフと自然言語処理も重要です。ナレッジグラフは、遺伝子・タンパク質・疾患・薬などの関係を網の目のようにつないだデータベースで、論文などから関係を抽出して作ります。既存薬の新しい使い道を探す仮説づくりに活用されます。具体例は次の章以降で詳しく扱います。
AI創薬の代表的な使いどころ ― 標的探索から化合物設計・既存薬の転用まで
標的探索とタンパク質の立体構造予測
標的とは、薬が作用する体内の分子のことで、多くはタンパク質(酵素や受容体など)です。標的探しでは、遺伝子やタンパク質の大規模データ(オミクスデータ)や膨大な論文をAIで解析し、病気に本当に関わっていそうな分子を探します。標的の妥当性が低いと、その後の開発がすべて空振りになります。
標的探しでは、遺伝子の情報と薬の効き方の関係も手がかりになります。用語の整理はICH E15「ゲノム薬理学における用語集」で、患者を層別するバイオマーカーの考え方はICH E16 をやさしく理解する(バイオマーカー)で確認できます。
もうひとつの柱がタンパク質の立体構造予測です。タンパク質の立体構造の予測は約50年来の難問とされてきました。2024年のノーベル化学賞は、Google DeepMindのデミス・ハサビス氏とジョン・ジャンパー氏(AIモデル「AlphaFold2」による構造予測)と、ワシントン大学のデイヴィッド・ベイカー氏(コンピュータによるタンパク質の設計)に授与されています。立体構造が分かれば、薬が結合するポケットの形を手がかりに化合物を設計できます(構造に基づく創薬)。
化合物の生成・絞り込みと体内動態・毒性の予測
標的が決まったら、作用する化合物を探します。ここでは主に3つの使い方があります。
- バーチャルスクリーニング:実験の前に、コンピュータ上で膨大な化合物から有望なものを予測で絞り込む方法です。
- 生成AI(生成モデル)による分子の提案:学習したデータの特徴をもとに、望ましい性質を持ちそうな新しい分子構造を作り出します。
- ADMET予測:ADMETは吸収・分布・代謝・排泄・毒性の頭文字で、薬が体内でどう動き、安全かどうかを表す性質です。これを事前に予測します。
費用の削減には、体内動態や毒性で失敗しそうな分子を、臨床に進む前に早く落とすことも大きな意味を持ちます。
ただし注意点があります。予測モデルは、学習したデータに似た化合物でしか当たりにくいものです(適用範囲)。学習データからかけ離れた化合物の予測は外れやすいと心得ておきましょう。この点は、後ほどRのシミュレーションと合わせて詳しく扱います。
既存薬の新しい使い道を探すドラッグ・リポジショニング
ドラッグ・リポジショニングとは、すでに承認されている薬や開発途中で止まった薬に、別の病気への効き目を見つけて転用することです。安全性の情報がすでにあるため、開発期間を短縮しやすいのが利点です。
ここで活躍するのがナレッジグラフです。遺伝子・タンパク質・疾患・薬などの関係を網の目のようにつないだデータベースで、論文などから関係を抽出して作ります。そこから「この薬はあの病気にも効くのでは」という仮説を導きます。具体例としてバリシチニブを、次の章で成功例としてまとめて紹介します。
AI創薬の実例 ― 成功例と失敗例から見える現在地
臨床試験まで進んだ代表例
まず4つの例を一覧にします。
| 化合物 | 開発企業 | 対象疾患 | AIの使い方 | 現状 |
|---|---|---|---|---|
| DSP-1181 | Exscientia社・大日本住友製薬(現・住友ファーマ) | 強迫性障害 | 化合物の創出 | 2020年に第I相開始を発表 |
| バリシチニブ | イーライリリー社(転用の仮説はBenevolentAI社) | COVID-19 | ナレッジグラフで転用を提案 | 2022年5月に米FDAが承認 |
| rentosertib | Insilico Medicine社 | 特発性肺線維症 | 標的選定と化合物設計 | 第III相試験中(未承認) |
| REC-994 | Recursion社 | 脳海綿状血管奇形 | AI・画像解析を活用した創薬 | 2025年5月に開発中止を発表 |
DSP-1181は、2020年1月に第I相試験の開始が発表された化合物で、両社は「AIで創出した化合物として世界で初めて臨床試験に入った」としていました。Exscientia社は、通常は数千の化合物の合成が必要なところを、約350化合物の合成で候補にたどり着いたと説明しています。なお、Exscientia社は2024年11月に米国Recursion社と経営統合を完了しています。
バリシチニブは、関節リウマチ治療薬(JAK阻害薬)です。2020年2月、BenevolentAI社の研究者がナレッジグラフを使った探索から、COVID-19の治療候補とする仮説を医学誌The Lancetに発表しました。その後、ACTT-2試験やCOV-BARRIER試験などのランダム化比較試験で検証され、米国FDAは2020年11月に緊急使用許可を出し、2022年5月に入院中の成人COVID-19患者への適応を承認しました。大切なのは、AIが出したのは「仮説」であり、効くかどうかを決めたのはランダム化比較試験だったことです。
rentosertibは、生成AIで標的(TNIKというタンパク質)の選定と化合物の設計の両方を行った治療候補です。第IIa相試験で肺機能の改善傾向が報告され、第III相試験に進みました。2026年11月時点で、どの規制当局からも承認されていない治験薬です。第IIa相の中身は、後の章で統計家の目で読み解きます。
うまくいかなかった例と臨床での成功率
うまくいかなかった例もあります。REC-994は、脳海綿状血管奇形(脳の血管の異常で出血などを起こす希少疾患)を対象に、約60例で第II相試験が行われました。2025年5月、Recursion社は、さらなる投資を正当化するだけの有効性が見込めないとして開発の中止を発表し、その後、権利は患者団体に移管されました。
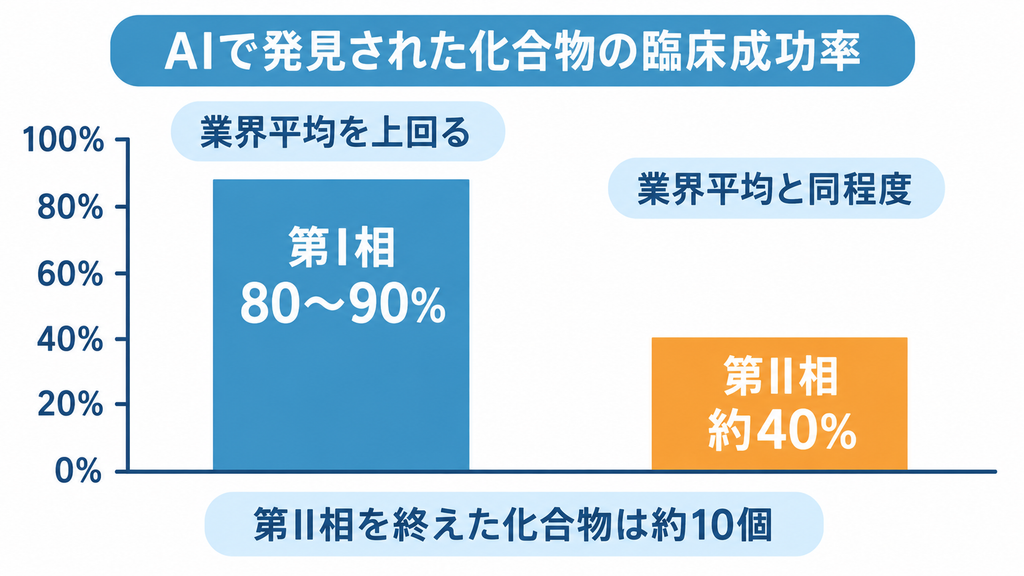
では全体としては、どうなのでしょうか。Jayatungaらが2024年に学術誌Drug Discovery Todayに発表した分析(2023年12月までのデータ)によると、AIで発見された化合物の第I相の成功率は80〜90%で、過去の業界平均を大きく上回りました。一方、第II相の成功率は約40%で、過去の業界平均と同程度でした。ただし、第II相を終えた化合物はまだ約10個と少なく、確定的な結論ではありません。
この差は、次のように解釈できます。第I相は主に安全性と体内動態を確かめる段階で、AIが得意とする「化合物の性質の予測」が効きやすいといえます。第II相は「その標的を狙うと本当に病気が良くなるか」という有効性が問われる段階で、ここはAIでもまだ大きくは改善できていない可能性があります。なお、執筆時点(2026年11月)で、AIが一から設計した新規化合物が承認に至った例は、筆者が確認した範囲では見当たりません。
「AI創薬」と呼ばれる化合物でも、AIがどこまで関わったかは企業ごとに大きく違います。標的探索だけにAIを使った例もあれば、分子設計まで使った例もあり、同列には比べにくい点に注意してください。
日本でも取り組みが進んでいます。LINC(ライフインテリジェンスコンソーシアム)は、2016年に京都大学・理化学研究所・医薬基盤・健康・栄養研究所などが中心となって発足した、製薬企業・IT企業・アカデミアなど約120の企業・団体が参加する産学連携の枠組みです。2025年、LINCと株式会社Elixは、製薬企業16社が保有するデータを連合学習したAIモデルを搭載したAI創薬プラットフォームの事業化を発表しました。連合学習とは、各社がデータを外に出さず手元で学習し、モデルの情報だけを持ち寄って共同のAIモデルを作る方法で、企業の機密データを守りながら学習データを増やせます。
生物統計家の視点で見るAI創薬 ― 予測上位を選ぶと何が起きるかをRで確かめる
AI創薬は、突き詰めると「予測をもとに候補を選ぶ」営みです。そして、予測と選抜があるところには、統計家が昔から扱ってきた落とし穴があります。ここでは小さなシミュレーションで、その落とし穴を実際に確かめてみましょう。
予測上位50化合物の「期待外れ」をシミュレーションする
これから使うのは架空のシミュレーションです。1万個の候補化合物があり、それぞれに「真の活性」があるとします。活性の指標 pIC50 は、薬が標的の働きを半分に抑える濃度(IC50)の対数にマイナスを付けたもので、値が大きいほど少ない量で効く=強いことを表します(1大きいと10倍強い)。
AIの予測値は「真の活性+予測誤差」とし、予測と真値の相関は0.71(まずまず当たるAI)にしました。予測値の上位50個を「合成して測定する候補」に選びます。バーチャルスクリーニングそのものの選び方です。
set.seed(2026)
n <- 10000                                  # 候補化合物の数
true_act <- rnorm(n, mean = 6, sd = 1)      # 真の活性(pIC50)
pred_act <- true_act + rnorm(n, sd = 1)     # AIの予測値(誤差あり)
round(cor(true_act, pred_act), 2)           # 予測と真値の相関

top50 <- order(pred_act, decreasing = TRUE)[1:50]   # 予測上位50化合物を合成へ
round(c(予測の平均 = mean(pred_act[top50]),
        真の平均   = mean(true_act[top50]),
        全体の平均 = mean(true_act)), 2)

# 真の上位1%(100化合物)を何個拾えたか
true_top <- order(true_act, decreasing = TRUE)[1:100]
c(AIで選んだ50個 = sum(top50 %in% true_top),
  ランダムな50個の期待値 = 50 * 100 / n)
[1] 0.71
予測の平均   真の平均 全体の平均
     10.19       8.01       6.00
        AIで選んだ50個 ランダムな50個の期待値
                  15.0                    0.5
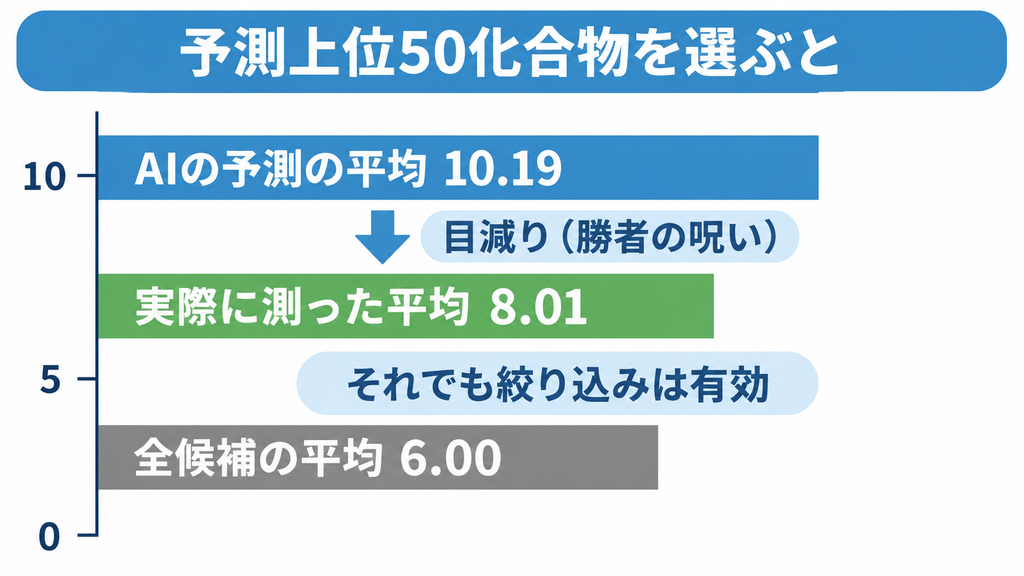
選ばれた50化合物の予測の平均は10.19ですが、真の平均は8.01で、予測は2.18も過大でした。実際に合成して測ると、予測より平均で約2.2下がるため「期待外れ」に見えます。これが勝者の呪い(平均への回帰とはと同じ仕組み)です。AIが悪いのではなく、上位を選ぶ操作が生む偏りです。
一方で、選ばれた50化合物の真の平均8.01は、全体の平均6.00より2.01高く、AIによる絞り込みは確かに役に立っています。また、真の上位1%(100化合物)のうち、AIの上位50個には15個が含まれました。ランダムに50個選んだ場合の期待値は0.5個なので、約30倍の濃縮です(15÷0.5=30)。
実務上の含意は次の3点です。
- AIの予測スコアを、選んだ後の「期待値」としてそのまま使わない(次の実験や臨床で目減りする前提で計画する)
- 評価は「選ばれたもの」ではなく、選抜とは独立した新しいデータで行う
- この偏りは臨床開発でも同じで、第II相の良い結果を見て第III相に進むと、効果が小さく見えやすい
なお、ここで示した30倍や2.18という値は、この架空設定(相関0.71・1万個から50個)での値であり、一般的な数値ではありません。
AIの予測を評価するときに確認したいこと
次の5点を確認しましょう。
データの分け方とデータリーク:化合物データを学習用と評価用にランダムに分けると、よく似た構造の化合物が両方に入り、性能が楽観的になりやすくなります。これはデータリーク(本来は予測時に使えない情報が学習に紛れ込み、性能が実力以上に良く見えること)の一種です。化合物の基本骨格(スキャフォールド)ごとに分ける骨格分割や、測定時期で分ける時間分割のほうが、「本当に新しい化合物」への実力に近い評価になります。
評価指標の選び方:AUCのような全体の識別力だけでなく、上位をどれだけ当てるか(濃縮)も確認します。さらに、予測値と実測値のずれ(キャリブレーション)も見ます。指標の考え方はROC曲線とAUCをRで実装すると臨床予測モデルの検証とはで詳しく解説しています。
過学習と多重性:多数のモデルや特徴量を試して一番良いものを選ぶと、その評価自体も勝者の呪いを受けます。モデル選択は独立した検証データで行うのが基本です。考え方の土台はモデル選択の基礎:AIC・BICが参考になります。
不確実性と適用範囲:予測値だけでなく、その予測がどれくらい当てにならないか(予測区間)を添えることが大切です。分布の仮定に頼らず予測区間を作るコンフォーマル予測という方法もあります。また、モデルは学習データに似た範囲(適用範囲)でしか信頼できず、学習データから遠い化合物の予測は外れやすくなります。
外部検証・前向き検証:モデルを作ったのとは別の時期や別の化合物系列のデータ、あるいはこれから行う実験で性能を確かめます。
臨床開発への橋渡し ― 有効性を確かめるのは臨床試験
生成AIで標的と化合物の両方を見つけた rentosertib の第IIa相試験を読んでみます。
AI創出化合物の第IIa相試験を統計家の目で読む
2025年6月に医学誌Nature Medicineに掲載された第IIa相試験(GENESIS-IPF)は、特発性肺線維症の患者71例を対象とした、中国の22施設でのランダム化・二重盲検・プラセボ対照試験(12週間)です。群構成は、30mg 1日1回(18例)、30mg 1日2回(18例)、60mg 1日1回(18例)、プラセボ(17例)でした。
主要評価項目は安全性で、治験薬投与後に発現した有害事象が1件以上あった患者の割合は、プラセボ群70.6%、60mg群83.3%でした。有効性の指標である努力肺活量(FVC)の12週の平均変化量は、60mg群で+98.4mL(95%信頼区間 10.9〜185.9)、プラセボ群で−20.3mL(95%信頼区間 −116.1〜75.6)でした。
統計家の読み方のポイントは次のとおりです。
- 主要評価項目は安全性:FVCは有効性の手がかりとして見るもので、この試験だけで有効性を証明したとは言えません
- 各群が17〜18例と小さい:プラセボ群の95%信頼区間は−116.1〜75.6mLと幅が広く、推定の精度は高くありません
- 60mg群の信頼区間の下限は10.9mL:0に近く、効果の大きさはまだ不確かです。研究者自身も、症例数が少なく、より大きな集団での検証が必要としています
- だからこそ第III相で確かめる:第III相試験(GENESIS-IPF-3)は、中国の47施設・320例・52週間のプラセボ対照二重盲検試験として、2026年7月に開始が発表され、同年9月に最初の患者への投与が行われました。2026年11月時点で、どの規制当局からも承認されていません
- 評価のものさしは従来の薬と同じ:「AIで作った薬だから効く」わけではなく、効くかどうかはランダム化比較試験で判断します
小規模試験の良い結果は、後の大規模試験で小さく見えやすいことに注意が必要です。良い結果を見て次の試験に進むという選抜の構造は、さきほどのシミュレーションで予測上位の値が目減りした勝者の呪いと同じだからです。第III相の結果は、第IIa相の数値より控えめになる可能性を念頭に読むのが安全です。
臨床開発で生物統計家が果たす役割
Jayatungaらの分析では、AIで発見された化合物の第I相の成功率は80〜90%と高い一方、第II相は約40%で従来の業界平均と同程度でした。第II相で問われる「その標的を狙うと本当に病気が良くなるか」という有効性の不確実さは、臨床試験のデザインで扱うしかありません。ここに統計家の出番があります。
第I相の用量探索:安全に投与できる用量を見つける段階では、デザインの選択が結果を左右します。詳しくは第I相がん臨床試験の用量探索デザインをご覧ください。
患者選択と効率的な試験:バイオマーカーで患者を選ぶ試験や、複数の候補・疾患を効率よく調べる試験では、マスタープロトコル試験とはで紹介するバスケット・アンブレラ・プラットフォーム試験の考え方が役立ちます。
仮説を検証できる形にすること:AIが出したのは「仮説」です。それを、事前に定めた評価項目と解析計画で検証できる試験に落とし込むのが、統計家の大切な仕事です。バリシチニブの例でも、効くかどうかを決めたのはランダム化比較試験でした。
なお、規制当局は、AIを規制上の意思決定に使う場合、使用文脈に応じてリスクを評価し、求める証拠の重さを変える考え方を示しています。詳しくは説明可能AI(XAI)とはで整理しています。
実務でのポイント ― AI創薬時代に生物統計家が身につけたいこと
AI創薬やデータサイエンスの領域で、生物統計家には次のようなスキルが求められます。
- 統計的学習(機械学習)の基礎と、予測モデルの評価・検証の考え方:予測がどれくらい当たるのかを、偏りなく見積もる力です
- R・Pythonなどでの実装力:手法を理解するだけでなく、自分で動かして確かめられること
- 臨床試験デザインと因果推論の知識:AIの出した仮説を、検証可能な試験に落とし込む力です
- 化学・生物のドメイン知識:研究者やデータサイエンティストと共通言語で話すために必要です
働く場としては、製薬企業の研究部門やデータサイエンス部門、AI創薬のスタートアップ、CROなどが考えられます。キャリアの選択肢は生物統計家の就職先はどこ?、学び方は生物統計家を目指すための勉強法、AIとの付き合い方は生物統計家とAIについてで詳しく解説しています。
- AIの予測は「仮説」であり、効くかどうかの検証は臨床試験で行う
- 評価は、選抜とは独立したデータで行う
- 予測には必ず不確実性を添える
- 臨床試験の知識は、AI時代こそ生物統計家の強みになる
生物統計家のキャリアについて相談したい方へ
製薬企業・CROでのキャリア、未経験からの転職、実務で必要になるスキルの伸ばし方について、現役の生物統計家が個別にご相談をお受けしています。
📚 この記事をより深く理解するための参考書籍
AI創薬を「創薬の基本」「化学データの機械学習」「予測モデルの統計学」の3方向から深めたい方に、おすすめの書籍をご紹介します。



関連記事・次のステップ
AIと製薬業界の関係を広く知りたい方は、AIの判断根拠の示し方とFDA・EMA・日本の規制動向をまとめた説明可能AI(XAI)とはと、生物統計家の日常業務とAIの付き合い方を扱った生物統計家とAIについてがおすすめです。
本記事のシミュレーションの背景を深めたい方は、選抜による目減りの正体である平均への回帰とは、予測モデルの過学習補正を扱った臨床予測モデルの検証とは、多数の候補から選ぶときの偽陽性を制御する多重比較法をRで実装するを順に読むと理解がつながります。
臨床開発につなぐ試験デザインを知りたい方は、新しい治療候補の評価で話題になる外部対照群(External Control Arm)とはや、バイオマーカーで患者を絞るときに欠かせないサブグループ解析と交互作用検定を正しく行うをご覧ください。
まとめ
本記事では、AI創薬とは何かを導入から整理し、創薬のどこでAIが使われているのか、成功例と失敗例から見える現在地、そして生物統計家の視点からAIの予測と臨床試験をどうつなぐかを解説しました。
AI創薬は、機械学習・深層学習・生成AIを使って、標的探索から候補化合物の設計・絞り込みまでの研究段階を効率化する取り組みです。AlphaFold2による立体構造予測、生成AIによる分子の提案、ナレッジグラフを使ったドラッグ・リポジショニングなど、実際に臨床試験まで進んだ例も増えています。一方で、AIで発見された化合物は第I相の成功率こそ80〜90%と高いものの、第II相は約40%と従来並みであり、「その標的を狙うと本当に病気が良くなるか」という問いには、まだAIだけでは答えられていません。
Rのシミュレーションでは、予測と真値の相関が0.71のAIで上位50化合物を選ぶと、ランダムに選ぶより約30倍多く当たりを拾える一方、選んだ化合物の予測は真の値より2.18も過大になることを確かめました。AIの予測は役に立つ「仮説」ですが、選抜の後には必ず目減りが起きます。だからこそ、選抜とは独立したデータでの評価、不確実性の提示、そして事前に計画したランダム化臨床試験での検証が欠かせません。
AIが強力になるほど、その予測をどう評価し、どう検証可能な試験につなぐかという統計の考え方の価値は高まります。AI創薬の動きを追いながら、臨床試験と統計の知識をご自身の強みとして磨いていただければと思います。