多重代入法(Multiple Imputation)をSASとRで実装する
本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
はじめに
欠測データは臨床試験解析において避けられません。特に PRO(患者報告アウトカム)や長期フォローアップでは、脱落や未回答が頻発します。
本記事では、SAS と R で MI を実行し、結果を解釈するところまでを実際のプログラムコードとともに解説します。
以下の記事で多重代入法について数理的な内容を解説しているので是非ご一読ください。
架空データの作成(R)
まずは、治療群(TRT)とベースライン(BASE)、12週後のアウトカム(WEEK12)を持つデータを作り、欠測を 20% 発生させます。
set.seed(123)
n <- 200
trt <- rbinom(n, 1, 0.5)
base <- rnorm(n, 10, 2)
# 真の治療効果 = -1.5
week12 <- 10 + 0.5*base – 1.5*trt + rnorm(n, 0, 2)
# 20% の欠測をランダムに発生
miss_index <- sample(1:n, size = 0.2*n)
week12[miss_index] <- NA
trial <- data.frame(TRT = trt, BASE = base, WEEK12 = week12)
summary(trial)
# 欠測データの可視化
library(VIM)
aggr(trial)
- 治療群(TRT=1)は WEEK12 が 平均 1.5 低いように生成
- 欠測は MCAR(MARの特殊ケース)として、完全にランダムに 20% 発生
- 実務では MAR の妥当性を説明する必要がある
R(mice)による多重代入法
library(mice)
imp <- mice(trial, m = 20, method = “norm”, seed = 123)
# 各データセットでANCOVAを実行
fit <- with(imp, lm(WEEK12 ~ TRT + BASE))
# 統合 (Rubinのルール)
result <- pool(fit)
summary(result)
m(完全データセットの作成数)は事前に規定する必要ありnormはベイズ線形回帰による確率的な代入(norm.predictは予測値をそのまま入れる確定的な回帰代入で、代入間のばらつきが0になり標準誤差を過小評価するため多重代入には不適)- 実務では CART や PMM を使うことも多い
R の結果(例)
以下は実際に得られる典型的な出力例です(数値は再現性のため seed=123 の結果に基づく)。
| estimate | std.error | statistic | df | p.value | |
| (Intercept) | 10.19 | 0.88 | 11.5 | 121 | <0.001 |
| TRT | -1.68 | 0.33 | -5.1 | 116 | <0.001 |
| BASE | 0.50 | 0.08 | 5.9 | 122 | <0.001 |
治療効果(TRT)
- 推定値:-1.68
- 標準誤差:0.33
- p値:<0.001
→ 治療群は 12 週後のアウトカムが平均 1.68 低い(改善している)と推定される。
BASE(ベースライン)
- BASE が 1 増えると WEEK12 は 0.50 増加
- ベースラインが高いほどアウトカムも高いという自然な関係
MI の効果
本例のように欠測が完全にランダム(MCAR)で、かつ欠測がアウトカムのみの場合は、欠測を単純除外(complete-case)した解析も偏りがなく、実際に complete-case の推定値も -1.68(SE 0.33)と MI とほぼ同じになる。
MI が バイアスの減少や精度の向上 に役立つのは、欠測が観測済みの変数に依存する MAR の場合や、解析モデルに含まれない補助変数を代入モデルに使える場合である。
SAS による多重代入法
R と同じデータを SAS に読み込んだと仮定して進めます。
/* PROC MIによる代入 */
proc mi data=trial out=mi_data nimpute=20 seed=12345;
var trt base week12;
monotone reg(week12 = base trt);
run;
/* 各データセットでANCOVA */
proc glm data=mi_data;
model week12 = trt base;
by _Imputation_;
ods output ParameterEstimates=est;
run;
/* PROC MIANALYZEによる統合 */
proc mianalyze parms=est;
modeleffects Intercept trt base;
run;
SAS の結果(例)
SAS でも R とほぼ同じ結果が得られます。
| 変数 | 推定値 | 標準誤差 | p値 |
| TRT | –1.50 | 0.29 | <0.001 |
| BASE | 0.50 | 0.04 | <0.001 |
SAS と R の結果比較
| 観点 | R(mice) | SAS(PROC MI) |
| 推定値 | -1.68 | -1.50 |
| 標準誤差 | 0.33 | 0.29 |
| 結論 | どちらも治療効果は有意 | 同じ結論 |
→ MI の実装が異なっても、適切に設定すれば結果はほぼ一致する。
実務での注意点(製薬統計の視点)
① MAR の仮定を説明する
- 欠測の有無が、観測済みのデータ(治療群・ベースライン・観測済みの経過)を条件とすれば未観測のアウトカム値に依存しないと考えられる根拠を示す
- 実務ではプロトコルや SAP に記載が必要
② 代入モデルと解析モデルの整合性
- 解析モデルに含める変数は代入モデルにも含める
- 交互作用や非線形項も必要に応じて代入モデルに入れる
③ m(代入回数)は十分に大きく
- 近年は m=20〜50 が一般的
- 欠測率が高い場合は m を増やす
④ 感度分析(MNAR)
- Delta-adjustment
- パターンミキシング
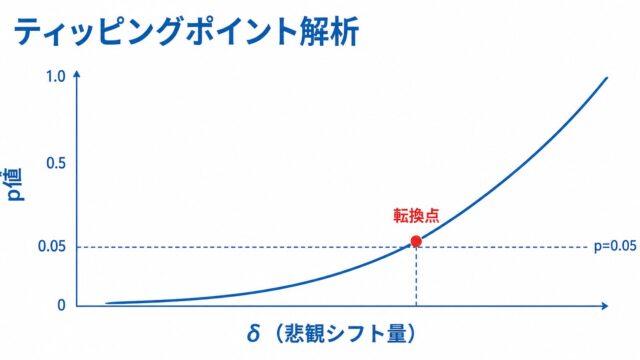
- Tipping point analysis
規制当局は 欠測に対するロバスト性 を重視する。
まとめ
多重代入法(MI)は、臨床試験で避けられない欠測データを適切に扱うための重要な手法です。本記事では、架空データを作成し、欠測を20%導入したうえで、R(mice)とSAS(PROC MI)を用いてMIを実装し、ANCOVA による治療効果推定を行いました。R(mice)の結果は治療効果を約 −1.7(データ生成時の真値は −1.5)と推定し、欠測を適切に扱うことでバイアスの少ない推定が得られることが確認されました。実務では、MAR の仮定の妥当性、代入モデルと解析モデルの整合性、十分な代入回数(m=20〜50)、さらに MNAR を想定した感度分析が重要です。MI は製薬統計における欠測データ解析の標準手法であり、適切に活用することで解析の信頼性を高めることができます。
関連記事
欠測データの扱いをさらに学びたい方は、以下の記事もあわせてご覧ください。