mmrmをRで実装する ― mmrmパッケージ・nlme/glsで反復測定混合モデルを動かす ―

本記事にはプロモーション(広告・アフィリエイトリンク)が含まれます。
💡 この記事でわかること
- 反復測定混合モデル(MMRM)をRで実装する代表的な方法(
mmrmパッケージとnlme::gls) - 無構造(UN)・複合対称(CS)・AR(1)・Toeplitzといった共分散構造の特徴と選び方
- R実装の結果がSAS PROC MIXEDと整合するかという、規制対応上の関心事
- 欠測(MAR)が必然的に生じる臨床試験において、MMRMが完全ケース分析やLOCFより頑健である理由
- mmrmパッケージ同梱の
fev_dataを使った、再現可能なRコードの全体像
臨床試験では、同じ被験者からアウトカム(評価項目)を複数の時点で繰り返し測定する「経時データ(縦断データ)」を扱う場面が数多くあります。たとえば呼吸器疾患の試験で、投与開始後の各来院時に1秒量(FEV1)を測定するようなケースです。こうしたデータでは、同一被験者内の測定値が互いに相関するため、各時点を独立に解析することはできません。さらに、被験者の脱落や来院の欠席によって、欠測が必然的に生じます。
反復測定混合モデル(MMRM:Mixed-effects Model for Repeated Measures)は、こうした経時データを解析するための標準的な手法です。欠測がランダム(MAR:Missing At Random)であるという仮定のもとで、尤度ベースの推定によって観測されたすべての情報を活用できるため、欠測に対して頑健である点が大きな強みになります。ICH E9(R1)以降、縦断データの主要解析として事実上の標準的な位置づけを得ています。MMRMそのものの概念については、別記事「MMRM(反復測定混合モデル)とは ― 臨床試験での柔軟な時系列解析手法」で詳しく解説していますので、あわせてご参照ください。
従来、MMRMの実装はSASのPROC MIXEDが主流でした。しかし近年は、製薬企業の統計家が参加するopenstatswareの取り組みから生まれたmmrmパッケージが整備され、Rでも規制対応水準のMMRM解析が可能になっています。本記事では、このR実装を一気通貫で扱い、mmrmパッケージとnlme::glsという2つのアプローチで反復測定混合モデルを動かす手順を整理します。
Rでmmrmを実装する前に ― モデルと共分散構造のおさらい
実装に入る前に、MMRMがどのようなモデルなのかを簡単におさらいします。被験者 \( i \) の時点 \( j \) におけるアウトカム \( Y_{ij} \) を、次のような平均構造でモデル化します。
\[ Y_{ij} = \beta_0 + (\text{治療効果}) + (\text{時点効果}) + (\text{治療} \times \text{時点}) + \beta\,\text{baseline} + \varepsilon_{ij} \]
この式で \( \beta_0 \) は切片、治療効果は実薬かプラセボかという群の違い、時点効果は来院時点ごとの違い、治療×時点はその交互作用(治療効果が時点によってどう変わるか)を表します。\( \text{baseline} \) はベースライン値(投与前のアウトカム)で、\( \beta \) はその回帰係数です。臨床試験では、最終時点における治療×時点の効果が主要な関心の対象になることが多くなります。
MMRMの特徴は、被験者内の反復測定残差ベクトル \( \varepsilon_i = (\varepsilon_{i1}, \dots, \varepsilon_{iT})^\top \) が、多変量正規分布
\[ \varepsilon_i \sim N(0, \Sigma) \]
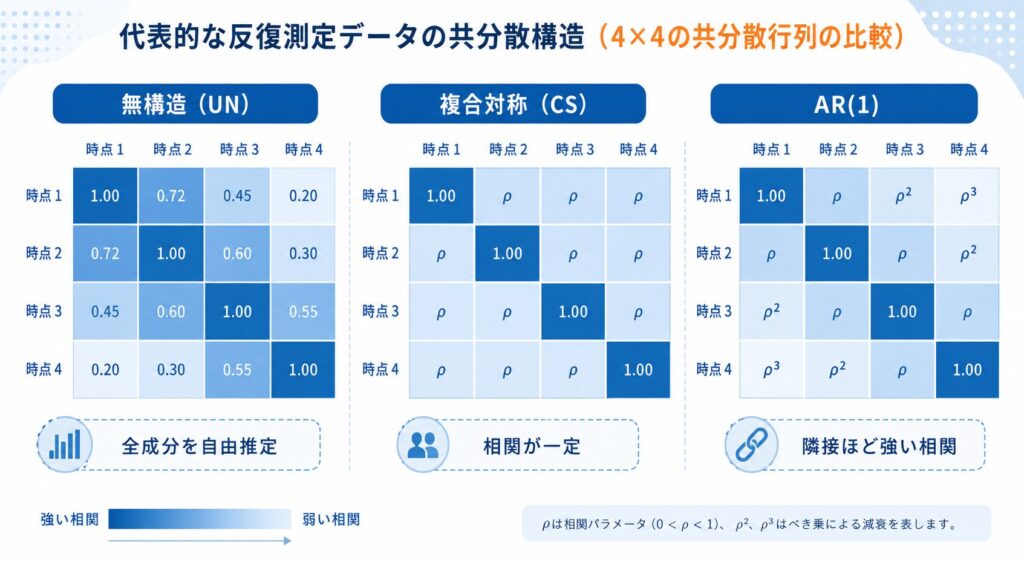
に従うと仮定する点です。ここで \( \Sigma \) は時点間の分散・共分散をまとめた行列であり、同一被験者内の測定値が互いに相関することを表現します。この \( \Sigma \) をどのような「共分散構造」で表すかが、MMRMを動かすうえで最も重要な設計判断になります。代表的な共分散構造を以下に整理します。
| 共分散構造 | パラメータ数(時点数T) | 主な仮定 | 臨床試験での使いどころ |
|---|---|---|---|
| Unstructured(UN/無構造) | T(T+1)/2 | 分散・共分散に一切の制約を置かない | 最も柔軟。規制当局向けの主要解析で既定として好まれる |
| Compound Symmetry(CS/複合対称) | 2 | 分散一定・どの時点間も相関が等しい | 最も倹約的。反復測定ANOVAに相当する強い仮定 |
| AR(1)(1次自己回帰) | 2 | 時点が離れるほど相関が指数的に減衰 | 等間隔で測定が密な時系列に適する |
| Toeplitz(トープリッツ) | T | 同じ時点差の相関は等しい(バンド構造) | UNとAR(1)の中間。倹約性と柔軟性のバランス |
表のとおり、UN(無構造)は分散・共分散の形に一切の仮定を置かないため最も柔軟であり、共分散構造の誤特定によるリスクを避けられます。この性質から、規制当局向けの確証的試験の主要解析では、UNが既定の選択肢として広く用いられています。一方でCSやAR(1)はパラメータ数が少なく倹約的ですが、その分だけ仮定が強くなる点に注意が必要です。
MMRMが欠測に強いのは、この尤度ベースの枠組みのおかげです。完全ケース分析(欠測のある被験者を丸ごと除外する方法)や、LOCF(最終観測値を以降の欠測に繰り越す方法)と異なり、MMRMは観測されたすべての時点の情報を尤度に取り込みます。そのため、MAR(観測されたデータで説明できる欠測)のもとでは偏りの小さい推定が得られます。なお、すべての時点で同じ分散・相関を仮定する反復測定ANOVAは、共分散構造がCSの場合のMMRMに相当する特殊ケースであり、欠測のあるバランスしないデータへの対応力という点でMMRMが優れています。反復測定ANOVAとの違いについては「反復測定ANOVA」の記事もあわせてご覧ください。
本記事で一貫して使用するのは、mmrmパッケージに同梱されているfev_dataです。data(fev_data, package = "mmrm")で読み込めるこのデータは、呼吸器疾患を想定した架空の臨床試験データで、1秒量(FEV1)を縦断的に測定した構造になっています。mmrm公式vignette(パッケージ付属の解説文書)でも標準データとして使われており、誰でも同じ結果を再現できます。主な変数は以下のとおりです。
| 変数名 | 内容 |
|---|---|
| USUBJID | 被験者ID |
| AVISIT | 来院時点(VIS1〜VIS4の4時点・因子) |
| ARMCD | 投与群(PBO=プラセボ/TRT=実薬) |
| FEV1 | アウトカム(1秒量・一部欠測あり) |
| FEV1_BL | ベースラインのFEV1 |
| RACE / SEX | 人種・性別(共変量) |
| VISITN / WEIGHT | 数値の来院番号・体重 |
FEV1に意図的な欠測が含まれている点が、MMRMの強みを示すうえで好都合です。次のセクションからは、このデータを使って実際にRでMMRMを動かしていきます。
mmrmパッケージによる実装 ― FDA準拠の最短ルート
mmrm パッケージは、ASA Biopharmaceutical Section の openstatsware ワーキンググループ(Roche をはじめ複数の製薬企業の統計家が参加するオープンソース統計開発コミュニティ)が中心となって開発した、MMRM(反復測定混合モデル)専用パッケージです。Satterthwaite 法や Kenward-Roger 法による自由度補正をサポートし、SAS の PROC MIXED と整合する結果が得られるよう設計されているため、規制当局向けの解析(CSR:治験総括報告書)でそのまま使える信頼性を備えています。従来 R で MMRM を組む際に使われてきた nlme::gls や lme4 には「小標本での自由度補正が SAS と一致しない」「無構造共分散の収束が不安定」といった実務上の難点がありましたが、mmrm はこれらを正面から解決するために設計された後発のパッケージです。最適化に C++(TMB)を用いるため大規模データでも高速で、医薬品開発の現場で SAS から R へ移行する際の有力な選択肢になっています。
まずはパッケージを読み込み、解析対象データの構造を確認します。前述のとおり、本記事では mmrm パッケージに同梱されている fev_data を使用します。これは ADaM 形式の解析用データセットを模した構造になっており、製薬実務で扱う縦断データのイメージそのままです。
library(mmrm)
data(fev_data)
str(fev_data)   # 200被験者・4時点の縦断データ
'data.frame':	800 obs. of  10 variables:
 $ USUBJID: Factor w/ 200 levels "PT1","PT2","PT3",..: 1 1 1 1 2 2 2 2 3 3 ...
 $ AVISIT : Factor w/ 4 levels "VIS1","VIS2",..: 1 2 3 4 1 2 3 4 1 2 ...
 $ ARMCD  : Factor w/ 2 levels "PBO","TRT": 2 2 2 2 1 1 1 1 1 1 ...
 $ RACE   : Factor w/ 3 levels "Asian","Black or African American",..: 2 2 2 2 1 1 1 1 2 2 ...
 $ SEX    : Factor w/ 2 levels "Male","Female": 2 2 2 2 1 1 1 1 2 2 ...
 $ FEV1_BL: num  25.3 25.3 25.3 25.3 45 ...
 $ FEV1   : num  NA 40 NA 20.5 NA ...
 $ WEIGHT : num  0.677 0.801 0.709 0.809 0.465 ...
 $ VISITN : int  1 2 3 4 1 2 3 4 1 2 ...
 $ VISITN2: num  -0.626 0.184 -0.836 1.595 0.33 ...
200被験者×4時点で800行ありますが、アウトカム FEV1 には
NA(欠測)が263件含まれます(FEV1 が全時点で欠測の3被験者は解析に寄与せず、モデルが使うのは197被験者・537観測です)。これが MMRM を使う本質的な理由です。データは1行=1被験者×1来院の long形式(縦持ち) で、被験者ID(USUBJID)と来院(AVISIT)で1観測が一意に定まります。MMRM は欠測行を除外しつつ、観測された全データを使って最尤推定するため、LOCF のような恣意的な補完を行わずに MAR(ランダム欠測) の仮定下で妥当な推定が得られます。次に MMRM 本体をフィットします。固定効果には治療群(ARMCD)と来院(AVISIT)の交互作用、ベースライン FEV1(FEV1_BL)、人種(RACE)、性別(SEX)を含めます。治療×時点の交互作用を入れるのが MMRM の要で、これにより「効果が時間とともにどう変化するか」「最終評価時点で群間差があるか」を直接評価できます。共分散構造は us(AVISIT | USUBJID) で指定し、これは被験者内の4時点に 無構造(Unstructured, UN)共分散 を当てはめることを意味します。無構造は時点間の相関・分散に一切の形を仮定しないため、ICH E9 関連のガイダンスや FDA レビューでもデフォルトの共分散構造として広く受け入れられています。reml = TRUE(制限付き最尤)と method = "Satterthwaite"(自由度)はいずれも既定値であり、明示しなくても規制対応に適した設定が選ばれます。
fit <- mmrm(
  formula = FEV1 ~ ARMCD * AVISIT + FEV1_BL + RACE + SEX + us(AVISIT | USUBJID),
  data = fev_data
)
summary(fit)
mmrm fit

Formula:
FEV1 ~ ARMCD * AVISIT + FEV1_BL + RACE + SEX + us(AVISIT | USUBJID)
Data:        fev_data (used 537 observations from 197 subjects with maximum 4
timepoints)
Covariance:  unstructured (10 variance parameters)
Method:      Satterthwaite
Vcov Method: Asymptotic
Inference:   REML

Model selection criteria:
     AIC      BIC   logLik deviance
  3381.4   3414.2  -1680.7   3361.4

Coefficients:
                               Estimate Std. Error        df t value Pr(>|t|)
(Intercept)                    24.35372    1.40754 257.97000  17.302  < 2e-16
ARMCDTRT                        3.98329    1.04540 142.32000   3.810 0.000206
AVISITVIS2                      4.79036    0.79848 144.82000   5.999 1.51e-08
AVISITVIS3                     10.36601    0.81318 157.08000  12.748  < 2e-16
AVISITVIS4                     15.19231    1.30857 139.25000  11.610  < 2e-16
FEV1_BL                         0.15978    0.02777 190.27000   5.753 3.46e-08
RACEBlack or African American   1.41921    0.57874 169.56000   2.452 0.015211
RACEWhite                       5.45679    0.61626 157.54000   8.855 1.65e-15
SEXFemale                       0.33812    0.49273 166.43000   0.686 0.493529
ARMCDTRT:AVISITVIS2            -0.05253    1.12609 139.43000  -0.047 0.962859
ARMCDTRT:AVISITVIS3            -0.99957    1.17519 159.74000  -0.851 0.396286
ARMCDTRT:AVISITVIS4             0.42071    1.84622 130.54000   0.228 0.820098

(Intercept)                   ***
ARMCDTRT                      ***
AVISITVIS2                    ***
AVISITVIS3                    ***
AVISITVIS4                    ***
FEV1_BL                       ***
RACEBlack or African American *
RACEWhite                     ***
SEXFemale
ARMCDTRT:AVISITVIS2
ARMCDTRT:AVISITVIS3
ARMCDTRT:AVISITVIS4
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Covariance estimate:
        VIS1    VIS2    VIS3    VIS4
VIS1 37.8301 11.3255  3.4796 10.6844
VIS2 11.3255 23.5476  0.7760  5.5103
VIS3  3.4796  0.7760 13.8037  0.5683
VIS4 10.6844  5.5103  0.5683 92.9625
無構造共分散により4時点の分散・共分散として 10個(4分散+6共分散) のパラメータが推定され、来院間の相関構造に一切の制約を置きません。これが規制申請で最も保守的かつ標準的とされる設定です。自由度は Satterthwaite 法で係数ごとに調整され(例:
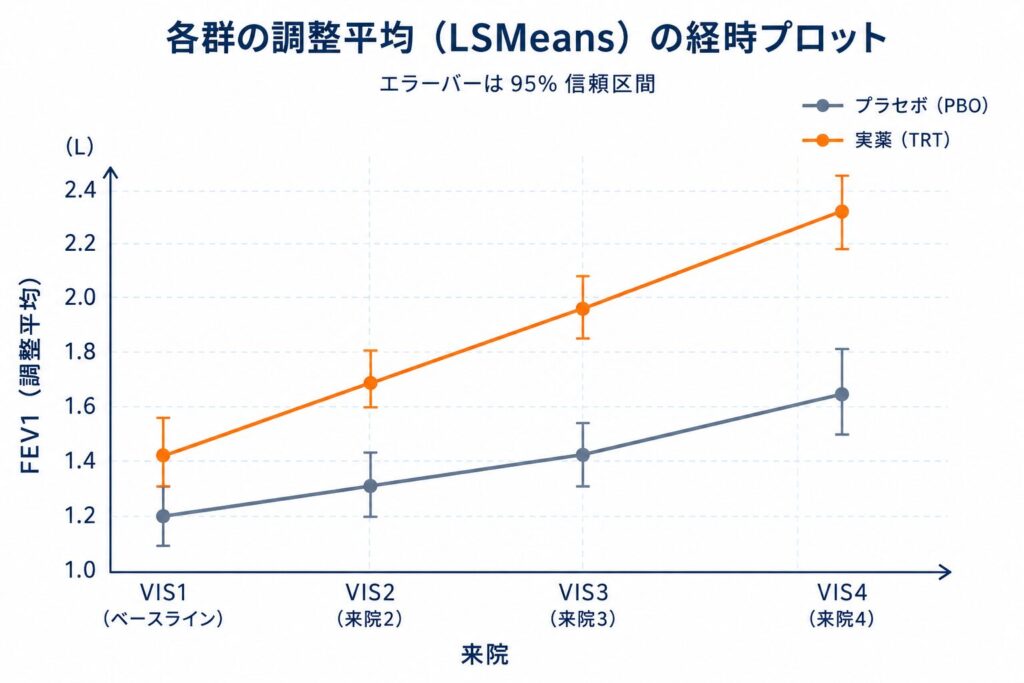
ARMCDTRT:AVISITVIS4 で約131)、small-sample の I 型過誤を抑えます。交互作用項 ARMCDTRT:AVISITVIS4 の推定値は +0.42(SE 1.85, p=0.82) で有意ではありません。この係数は「VIS4 の群間差が VIS1 の群間差(ARMCDTRT = +3.98)からどれだけ変わったか」を表す交互作用であり、VIS4 時点の群間差そのものではありません。各時点での実際の群間差は次の emmeans で読み解きます。summary() の係数表は「VIS1 を基準とした相対効果」を示すため、そのままでは臨床的に解釈しづらいのが難点です。そこで、得られたモデルから各時点・各群の 調整済み平均(least-square means、最小二乗平均) と、最終時点 VIS4 での群間差(contrast)を emmeans パッケージで算出します。これにより、共変量を平均的な水準に固定したうえでの「各群の予測平均値」が直接得られ、結果表や図表にそのまま載せられる形になります。
library(emmeans)
emm <- emmeans(fit, ~ ARMCD | AVISIT)
emm
pairs(emm, reverse = TRUE)   # TRT - PBO を各時点で
# (VIS4 の部分を抜粋)
AVISIT = VIS4:
 ARMCD emmean    SE  df lower.CL upper.CL
 PBO     48.4 1.170 134     46.1     50.8
 TRT     52.8 1.170 132     50.5     55.2

AVISIT = VIS4:
 contrast  estimate    SE  df t.ratio p.value
 TRT - PBO     4.40 1.660 133   2.652  0.0090
最終時点 VIS4 における調整済み平均は PBO 群 48.4、TRT 群 52.8 で、群間差は TRT − PBO = +4.40(SE 1.66, 95%CI 1.12〜7.69, p=0.0090) です。95%信頼区間が 0 を含まないため、治療効果は統計的に有意と判断できます。このような「各時点での調整済み平均」と「主要時点での群間差・95%CI」こそが、CSR の主要解析表や論文の Figure・Table にそのまま掲載される最終成果物です。MMRM では欠測のある被験者も推定に寄与しているため、completers のみの解析より一般化可能性が高い点も実務上の利点です。
nlme::gls による実装 ― 共分散構造を手で選ぶ
mmrm パッケージが導入できない環境(社内のバリデーション済み R 環境にまだ追加されていない、など)や、共分散構造の仕組みを教育的に理解したい場面では、nlme::gls(一般化最小二乗法)でも同等の MMRM を組むことができます。gls はランダム効果を持つ混合モデルではなく、誤差項の相関・分散構造を直接指定することで反復測定をモデル化するアプローチです。MMRM は「被験者ごとのランダム効果を置く代わりに、残差の共分散行列そのものを推定するモデル」と捉えられるため、gls の枠組みと自然に対応します。共分散構造を引数で手組みすることになるので、us() という1語で済む mmrm() に比べると MMRM の内部構造が見えやすいのも特長です。
無構造共分散を再現するには、来院間の相関を自由に推定する corSymm(無構造相関)と、時点ごとに異なる残差分散を許す varIdent(不等分散)を組み合わせます。欠測行は na.action = na.omit で除外します。
library(nlme)
fit_gls <- gls(
  FEV1 ~ ARMCD * AVISIT + FEV1_BL + RACE + SEX,
  data = fev_data,
  correlation = corSymm(form = ~ as.integer(AVISIT) | USUBJID),
  weights = varIdent(form = ~ 1 | AVISIT),
  na.action = na.omit
)
summary(fit_gls)
# (出力の一部を抜粋)
Generalized least squares fit by REML
  Model: FEV1 ~ ARMCD * AVISIT + FEV1_BL + RACE + SEX
  Data: fev_data
       AIC      BIC    logLik
  3405.379 3499.173 -1680.689

Correlation Structure: General
 Formula: ~as.integer(AVISIT) | USUBJID
 Parameter estimate(s):
 Correlation:
  1     2     3
2 0.379
3 0.152 0.043
4 0.180 0.118 0.016
Variance function:
 Structure: Different standard deviations per stratum
 Formula: ~1 | AVISIT
 Parameter estimates:
     VIS2      VIS4      VIS3      VIS1
1.0000000 1.9869076 0.7656431 1.2675073

Coefficients:
                                  Value Std.Error   t-value p-value
(Intercept)                   24.353659 1.4075290 17.302421  0.0000
ARMCDTRT                       3.983475 1.0454174  3.810416  0.0002
AVISITVIS2                     4.790401 0.7984899  5.999326  0.0000
AVISITVIS3                    10.366055 0.8131770 12.747600  0.0000
AVISITVIS4                    15.192293 1.3086471 11.609160  0.0000
FEV1_BL                        0.159781 0.0277745  5.752786  0.0000
RACEBlack or African American  1.419225 0.5787365  2.452282  0.0145
RACEWhite                      5.456789 0.6162489  8.854845  0.0000
SEXFemale                      0.338130 0.4927210  0.686250  0.4929
ARMCDTRT:AVISITVIS2           -0.052725 1.1261017 -0.046821  0.9627
ARMCDTRT:AVISITVIS3           -0.999742 1.1751864 -0.850709  0.3953
ARMCDTRT:AVISITVIS4            0.420462 1.8463330  0.227728  0.8199
固定効果係数は
mmrm() とほぼ完全に一致しており(例:ARMCDTRT:AVISITVIS4 は mmrm が +0.4207、gls が +0.4205)、同じ UN-MMRM を別経路で推定していることが確認できます。両者とも REML で同じ尤度を最大化しているため当然の帰結です。ただし注意点が2つあります。第一に、gls は既定で 残差自由度(残差の数-パラメータ数)に基づく t 検定 を用いるため、Satterthwaite 補正を行う mmrm() とは df・p値が微妙に異なります(小標本では mmrm の方が保守的)。第二に、na.action = na.omit を明示しないと欠測でエラーになるため、欠測のある行のみが除外され被験者は保持される点を理解しておく必要があります。両実装の主要係数を並べると、実務上は同一の結論に達することが一目で分かります。
| 係数 | mmrm() | gls() |
|---|---|---|
| ARMCDTRT | 3.983 | 3.983 |
| AVISITVIS4 | 15.192 | 15.192 |
| ARMCDTRT:AVISITVIS4 | 0.421 | 0.420 |
| FEV1_BL | 0.160 | 0.160 |
このように、点推定はどちらの実装でも一致します。違いが出るのは自由度・標準誤差の small-sample 補正の部分のみであり、規制対応では Satterthwaite/Kenward-Roger 補正を備えた mmrm() を第一選択とするのが安全です。gls は「MMRM の中身(相関+不等分散)が何をしているか」を可視化する教育的なツールとして位置づけると良いでしょう。
共分散構造の選択とモデル比較 ― AIC/BICと収束
ここまでは無構造(UN)共分散を既定として実装してきましたが、mmrm パッケージでは式の右辺に置く構造指定の関数を差し替えるだけで構造を切り替えられます。先ほどの us()(UN)を、より倹約的な複合対称 cs()(CS)や 1 次自己回帰 ar1()(AR(1))、Toeplitz toep() に置き換え、情報量規準で比較するのが基本的な流れです。
fit      <- mmrm(FEV1 ~ ARMCD * AVISIT + FEV1_BL + us(AVISIT | USUBJID),  data = fev_data)
fit_cs   <- mmrm(FEV1 ~ ARMCD * AVISIT + FEV1_BL + cs(AVISIT | USUBJID),  data = fev_data)
fit_ar1  <- mmrm(FEV1 ~ ARMCD * AVISIT + FEV1_BL + ar1(AVISIT | USUBJID), data = fev_data)
sapply(list(us = fit, cs = fit_cs, ar1 = fit_ar1), AIC)   # fit は無構造(us)
      us       cs      ar1
3450.082 3556.480 3559.929
AIC・BIC はいずれも「当てはまりの良さ」と「パラメータ数(複雑さ)」のバランスを評価し、値が小さいモデルほど好ましいと判断します。ここでは無構造 us が最小 AIC ですが、時点が 4 つでも共分散パラメータを 10 個推定しており、最も複雑なモデルです。臨床試験の主要解析では、時点間相関に強い仮定を置かない無構造(UN)が既定として好まれます。一方、時点数が多く UN が収束しない場合は、当てはまりを大きく損なわない範囲で UN → Toeplitz → AR(1)/CS の順に構造を倹約化(縮退)させていくのが定石です。この縮退順は解析前に SAP へ明記しておきます。
無構造(UN)は推定する共分散パラメータが時点数の二乗オーダーで増えるため、時点数が多い・例数(特に各群の完了例)が少ない場面では収束しないことがあります。対処としては、(a) 想定どおり
ARMCD * AVISIT の飽和(saturated)平均構造になっているか確認する、(b) method の自由度法(Satterthwaite/Kenward-Roger)を切り替える、(c) 構造を Toeplitz や AR(1) へ簡素化する、(d) vcov の指定を見直す、(e) FEV1_BL など連続共変量を中心化・スケーリングして数値的安定性を高める、といった手段があります。収束しないまま得た推定値は使わず、必ず収束判定とフィット警告を確認してください。実務でのポイント ― SAS PROC MIXEDとの整合性とSAP
規制対応の臨床試験では、長らく SAS の PROC MIXED が MMRM の事実上の標準でした。R で再現・併走させる際は、両者の指定が一対一で対応していることを押さえておくと安心です。下表に主要な対応をまとめます。
| 項目 | R(mmrmパッケージ) | SAS(PROC MIXED) |
|---|---|---|
| 共分散構造(無構造) | us(AVISIT | USUBJID) | REPEATED / TYPE=UN SUBJECT=USUBJID |
| その他の構造 | cs() / ar1() / toep() | TYPE=CS / AR(1) / TOEP |
| 自由度(DF) | method="Satterthwaite" / "Kenward-Roger" | DDFM=SAT / DDFM=KR |
| 推定法 | REML(既定) | METHOD=REML(既定) |
| 調整平均(LSMeans)と対比 | emmeans()(emmeansパッケージ) | LSMEANS ... / DIFF CL |
同じデータ・同じモデル指定であれば、R(mmrm)と SAS(PROC MIXED)は推定値・標準誤差・自由度まで実務上一致します。SAS 側の具体的な書き方は、姉妹記事「mmrmをSASで実装する(2/2)― PROC MIXEDで反復測定混合モデルを動かす」で詳しく解説していますので、二経路を突き合わせて検証したい方はあわせてご覧ください。
欠測の扱いも MMRM の核心です。MMRM は尤度ベースの解析であり、欠測が共変量と観測済みアウトカムで説明できる「ランダム欠測(MAR:Missing At Random)」を前提とすれば、欠測時点をそのまま除いても妥当な推定が得られます。一方、欠測が観測されない値そのものに依存する「非ランダム欠測(MNAR)」の懸念に対しては、感度分析として、プラセボ群の挙動を当てはめる制御ベース(control-based)の多重代入や、結果が逆転する代入量を探る tipping point 解析などが用いられます。本記事では深入りしませんが、主解析の MAR 前提を補強する位置づけとして押さえておきましょう。
これらは解析後に決めるものではなく、SAP(統計解析計画書)に事前指定すべき項目です。具体的には、主要解析の共分散構造と収束しない場合のフォールバック順(例:UN → Toeplitz → AR(1))、自由度法(Satterthwaite か Kenward-Roger か)、欠測の前提(MAR)と感度分析の手法、という三点を最低限明記します。とりわけ共分散構造のフォールバック順は、解析時点で恣意的に選んだという指摘を避けるために重要です。収束判定の基準や、どの段階でどの構造に切り替えるかまで具体的に書いておけば、ブラインド解除後に構造を変更したのではないか、という疑念を持たれずに済みます。事前指定があってこそ、解析者の恣意が入らない再現可能な MMRM になり、規制当局への説明責任も果たせます。
- 共分散構造は AIC/BIC で比較し、規制試験では 無構造(UN)を既定に。収束しなければ UN → Toeplitz → AR(1)/CS の順に縮退。
- R(mmrm)と SAS(PROC MIXED)は
us()↔TYPE=UN、Satterthwaite/KR↔DDFM=SAT/KRなど一対一で対応し、推定値も一致。 - 欠測は MAR を主前提、MNAR への懸念は制御ベース多重代入・tipping point などで感度分析。
- 共分散構造とフォールバック順・自由度法・欠測の前提は SAP に事前指定するのが鉄則。
📖 次に読みたい関連記事
まとめ
本記事では、R で MMRM(反復測定混合モデル)を動かす二つの経路を扱いました。一つは臨床試験向けに設計された mmrm パッケージで、無構造の共分散と Satterthwaite/Kenward-Roger 自由度を既定に備え、SAS の PROC MIXED を強く意識した実装になっています。もう一つは汎用の nlme::gls で、correlation と weights を組み合わせて同等の構造を表現でき、混合モデルの内部挙動を理解するうえでも有用です。
共分散構造の選択では、無構造(UN)を出発点に AIC/BIC で比較し、収束しない場合は Toeplitz や AR(1)/CS へ倹約化していく縮退の考え方を確認しました。さらに、R と SAS の指定が一対一で対応し、推定値・標準誤差・自由度まで実務上一致することも見てきました。
R でも、無構造共分散・REML 推定・Satterthwaite/KR 自由度・調整平均の対比という、規制対応水準の MMRM が問題なく実行できます。鍵になるのは、共分散構造とそのフォールバック順、自由度法、欠測の前提を SAP に事前指定しておくことです。再現可能で説明責任を果たせる縦断解析は、R を実務に取り入れるうえで大きな強みになります。SAS と R の双方を引き出しに持ち、試験ごとに最適な手段を選んでいただければと思います。SAS 側の実装手順は姉妹記事「mmrmをSASで実装する(2/2)― PROC MIXEDで反復測定混合モデルを動かす」でも詳しく扱っていますので、あわせてご活用ください。
参考書籍 ― mmrmとMMRMをさらに深く学ぶ3冊